我用同一组 6 个 Python 小仓库,对照测了 GLM-5.2、DeepSeek V4 Flash、Qwen3.8-Max-preview、Grok 4.5 Build 和 Codex(GPT-5.6-sol)。每款 6 题,共 30 次运行;每次最多 300 秒,中途不补提示,不人工改代码,也不允许动测试。
结果先说:30 次全部通过,公开得分五款并列。
这组数据会改变三个决定:修边界清楚的小功能时,不必为“正确率”专门换模型;这道并发重试题应保留 Codex 的实现;以后验收任何 Coding Agent,绿测之外都要带着同一份隐藏清单,而且不要把 Agent 自写验证脚本直接当裁判。
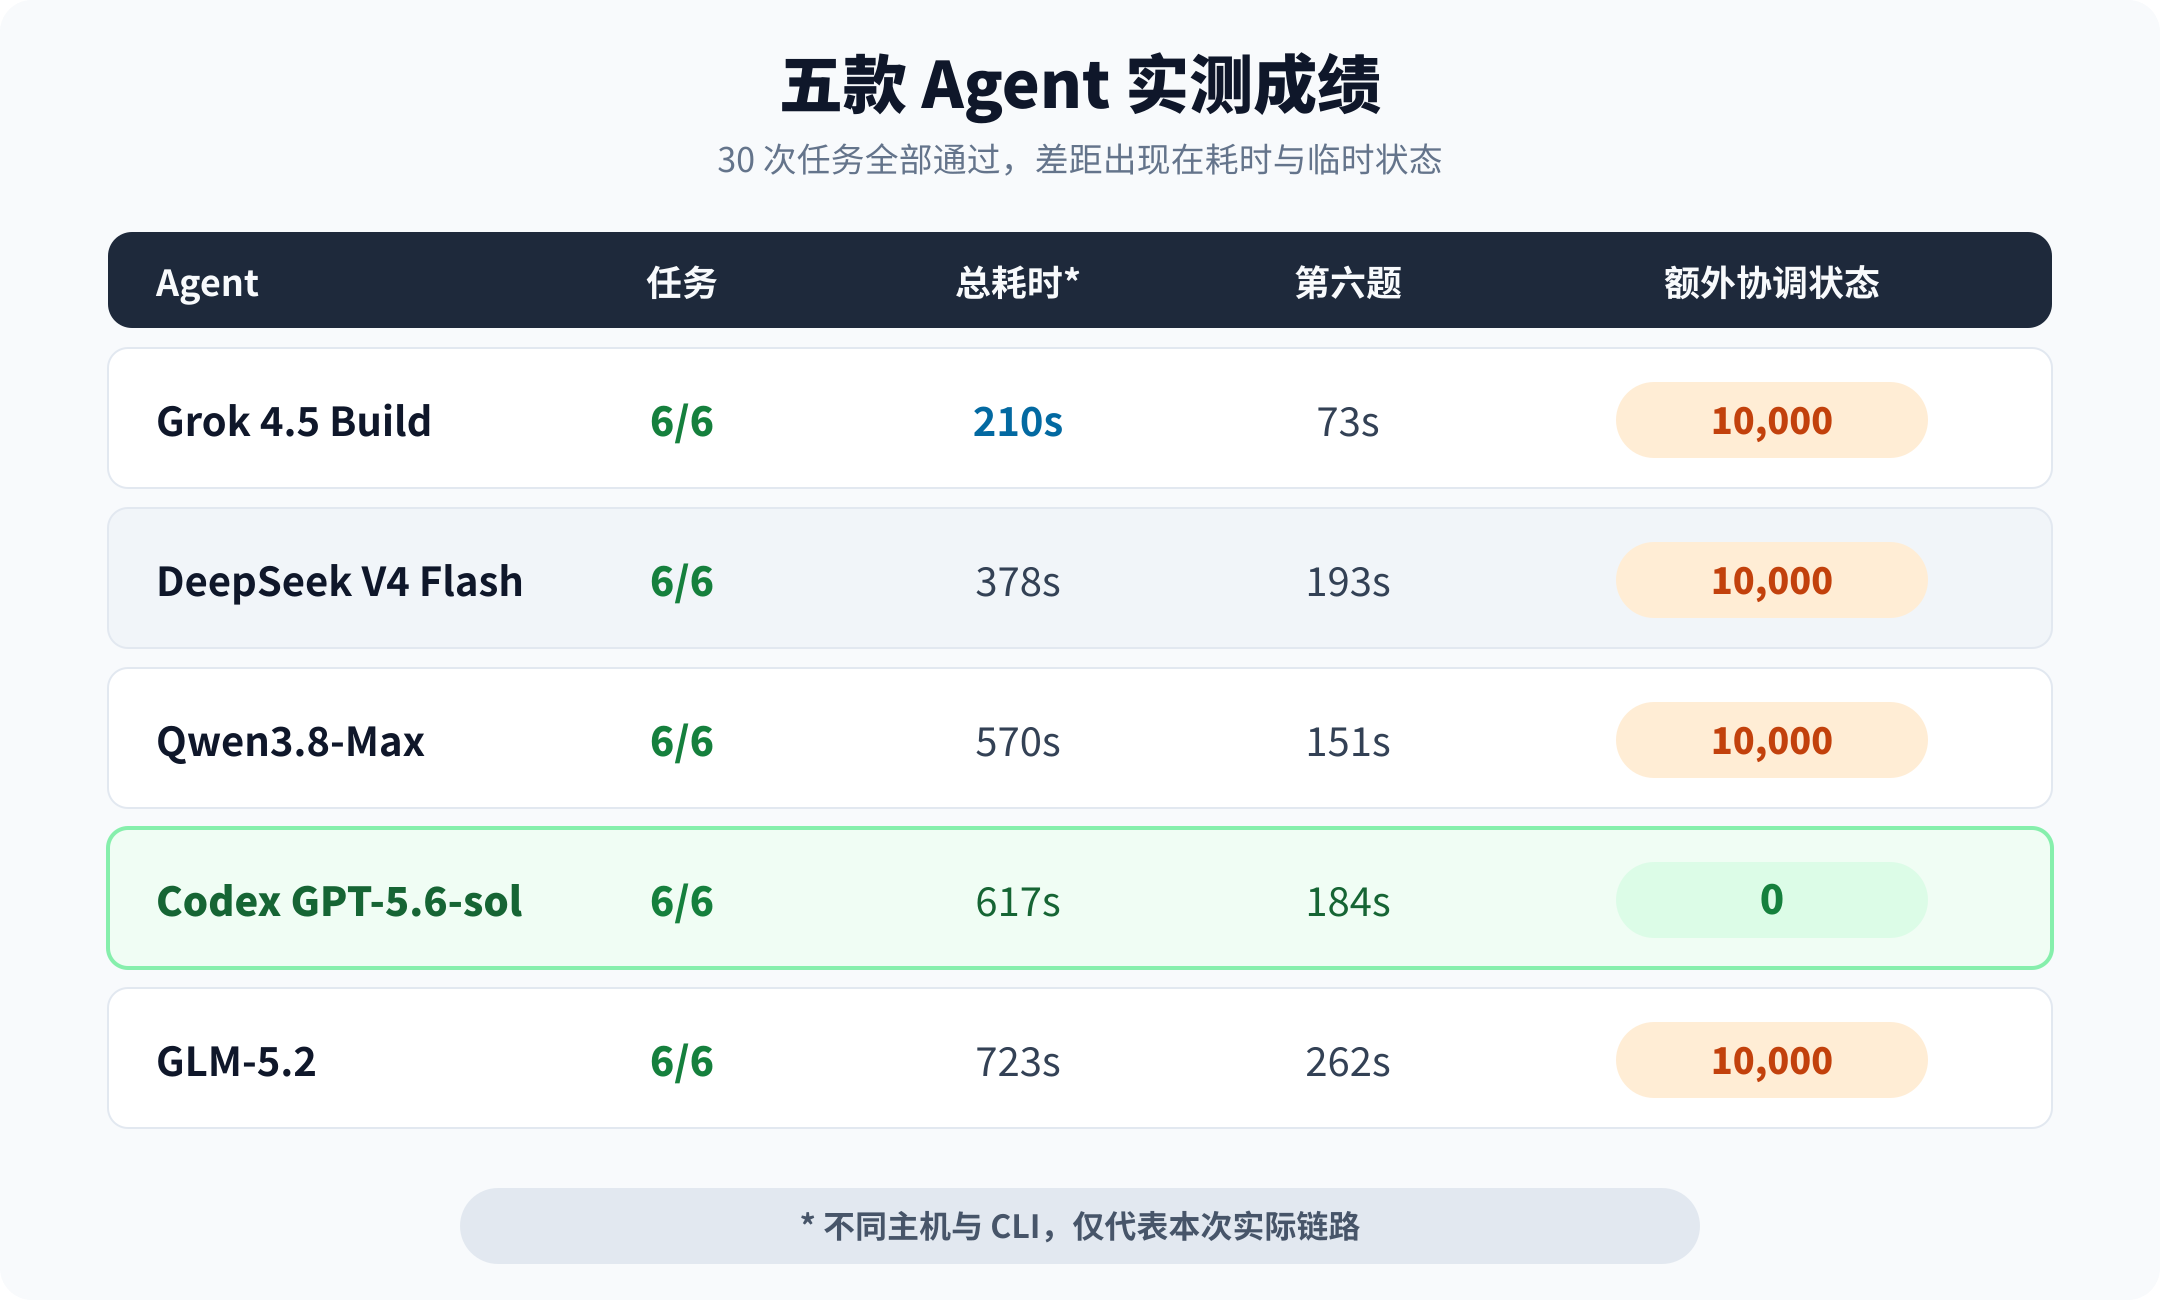
五款 Coding Agent 的实测成绩表
成绩表上没有正确率冠军。差距只出现在等待时间,以及测试没写进计分的临时状态里。
小任务打平,差在状态生命周期
前五题是边界 bug、跨文件功能、诊断、需求变更回归,以及按租户限流。五款都交了能过测的补丁。如果你日常大多是这类“题面清楚、有测试、改完就走”的活,当前接入最稳、等待和成本可接受的那款就够用;这次实验没有给出为正确率迁移的理由。
拉开细节的是第六个仓库:入账通知处理器。收到订单后,它先检查订单编号是否出现过,没有就记下来,再调用入账接口。坏掉的初始代码有两个缺口。入账接口临时失败时,编号已经提前记成“处理过”,重试只会收到“重复请求”,钱却一次没入账。两条相同订单同时到达,又可能一起通过检查,给同一笔订单入账两次。一个缺口吞钱,另一个复制钱。
Python 还有个容易忽略的边界:True 也属于整数。只检查金额是不是整数,就可能把 True 当成 1 分钱。
更麻烦的是,自带的两项公开测试在坏基线上本来就是绿的。我把同一份任务说明交给五款 Agent,它们退出后,再跑四项未公开测试:失败重试、同订单并发、不同订单并发、布尔值金额。
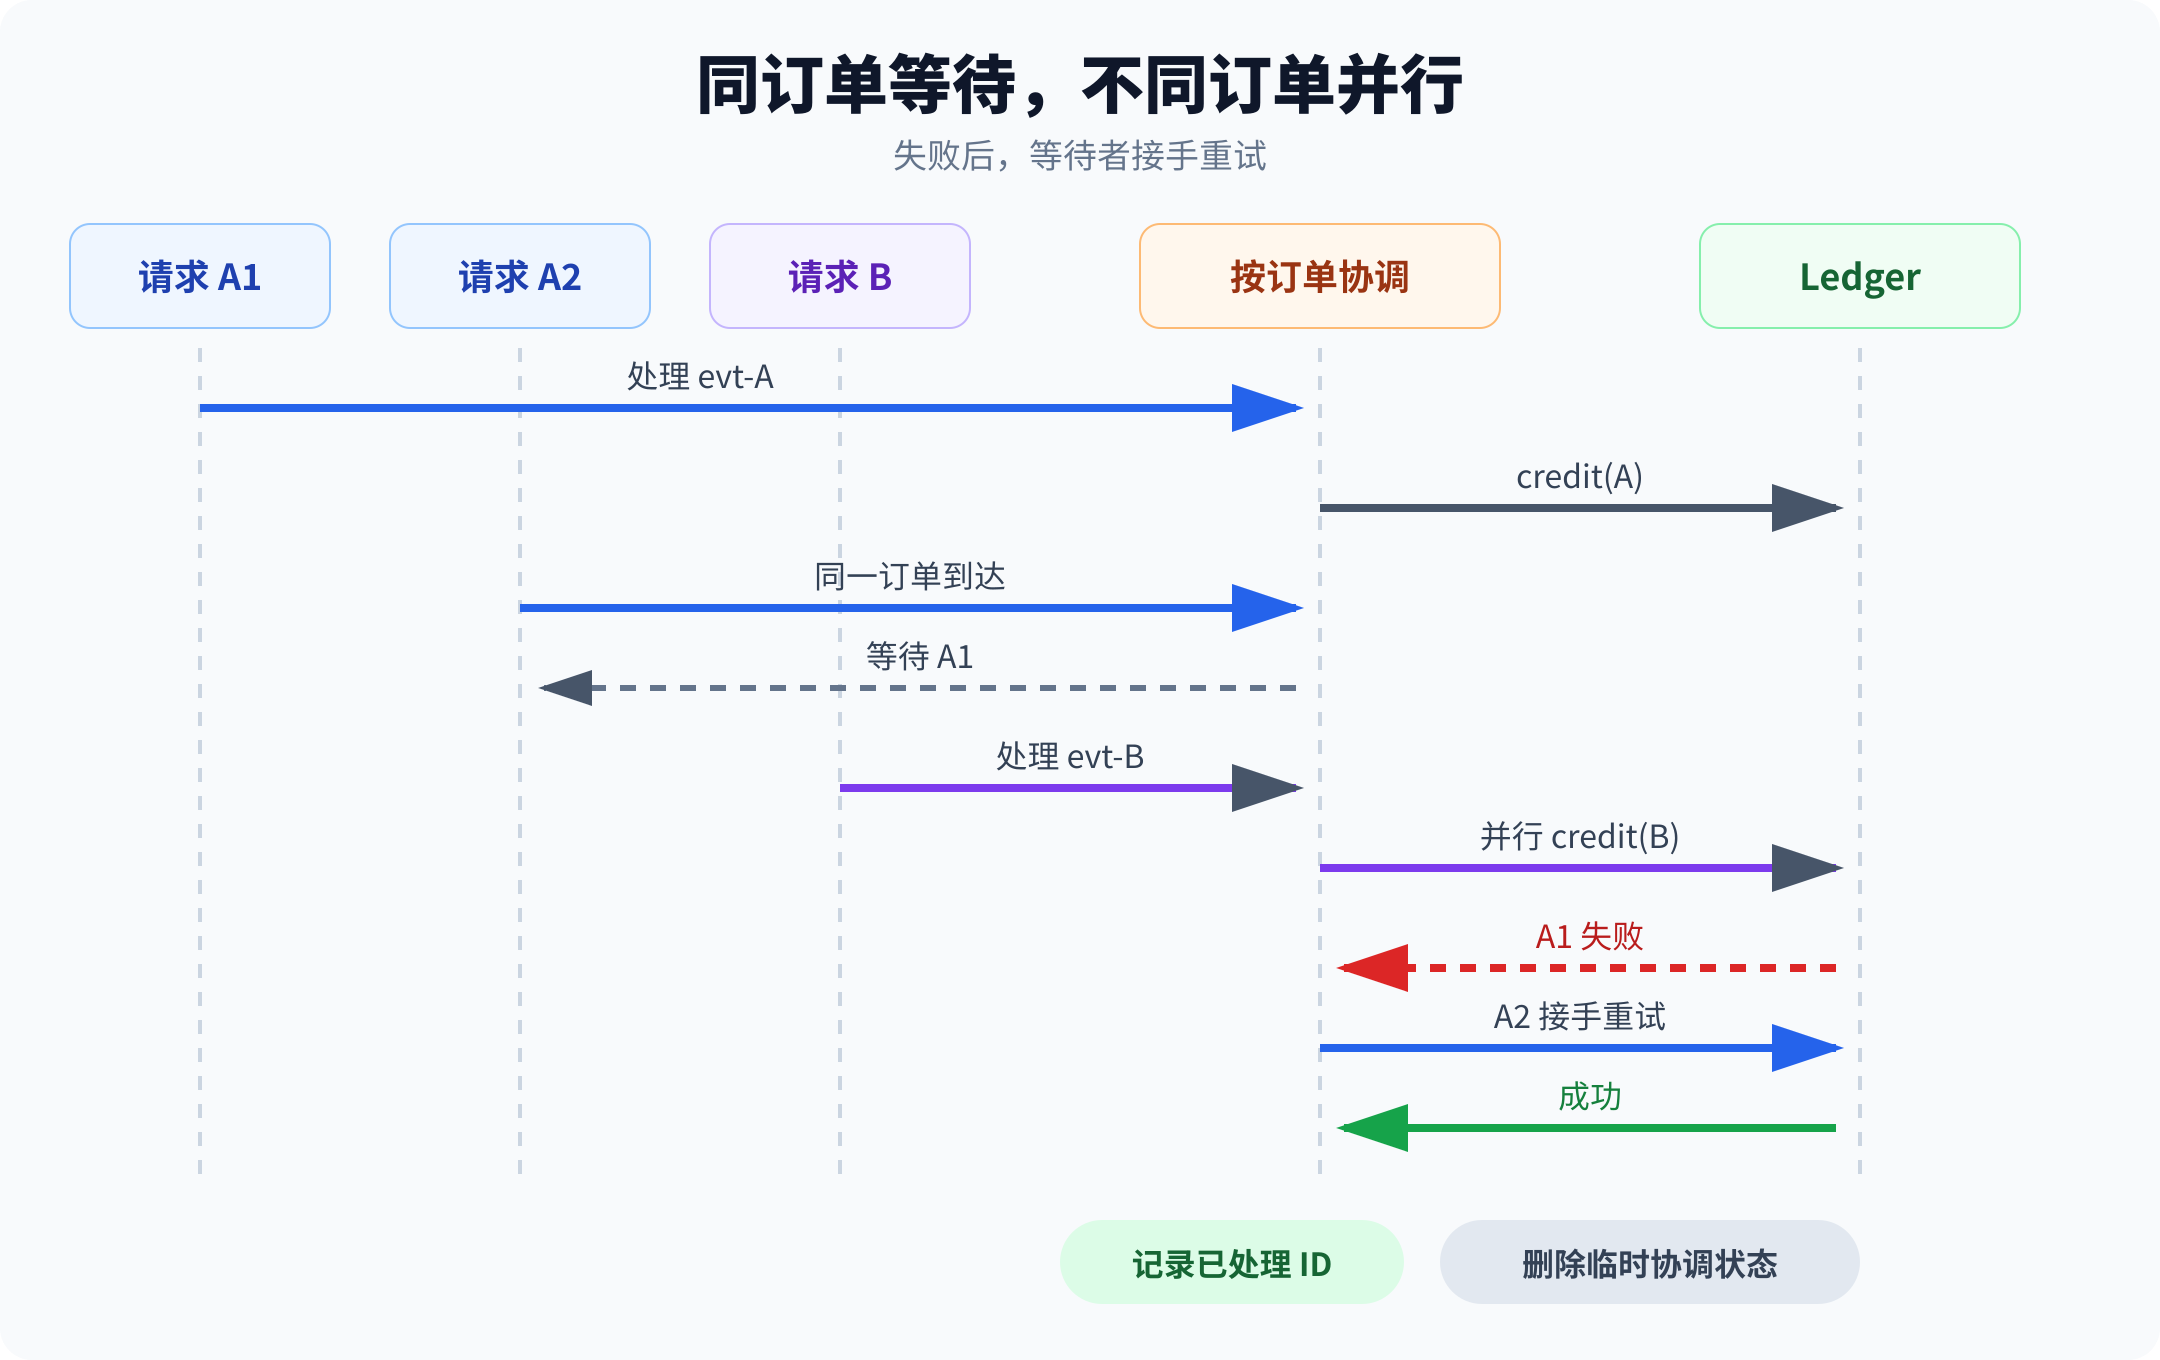
Webhook 同订单等待、不同订单并行与失败重试时序
Qwen 为每个订单编号准备一把独立锁:相同订单排队,不同订单继续并发;只有入账成功,编号才进入已处理集合。四项外部测试全部通过。
DeepSeek 采用相同基本方案,并把取锁逻辑单独放进一个函数。它还主动补测失败、取消和并发。中途检查脚本报错,排查后发现业务代码没问题,是脚本把预期结果顺序写反了。题做对了,参考答案印错了。修正脚本后完成验证。
GLM 的正式代码同样一次改对,自写验证脚本却连续失败两次:第一次拿着永远成功的模拟账本等异常,第二次把异步调用方式写错。它在业务代码上没有返工,主要时间花在批改自己的答题卡。
这两段日志比单独一个 PASS 更有用。Agent 会写错业务代码,也会写错用来证明自己正确的验证代码。自动验收如果只读最后一句,两种错误看起来完全一样。生产代码和自证代码来自同一个 Agent 时,不能直接信。
Grok 是第六题完成得最快的。它同样为每个订单准备一把锁,并对创建锁的瞬间增加保护,避免两个请求分别创建两把锁;外部测试随后通过。
前四个版本实现细节不同,基本思路仍是同一张锁表。Codex 没有保存永久锁表,只记录当前正在处理的订单。后来者等待当前任务结束;前一个失败,它继续重试;前一个成功,它返回重复。任务完成、报错或被取消,临时记录随即删除。它的四项外部测试也全部通过。
重新核对后,五个版本在功能上仍然同分:都防了重复入账,允许失败后重试,也没有用全局锁堵死其他订单。
功能测试结束后,我又连续送入一万个不同订单,再查看处理器内部剩余的协调状态。
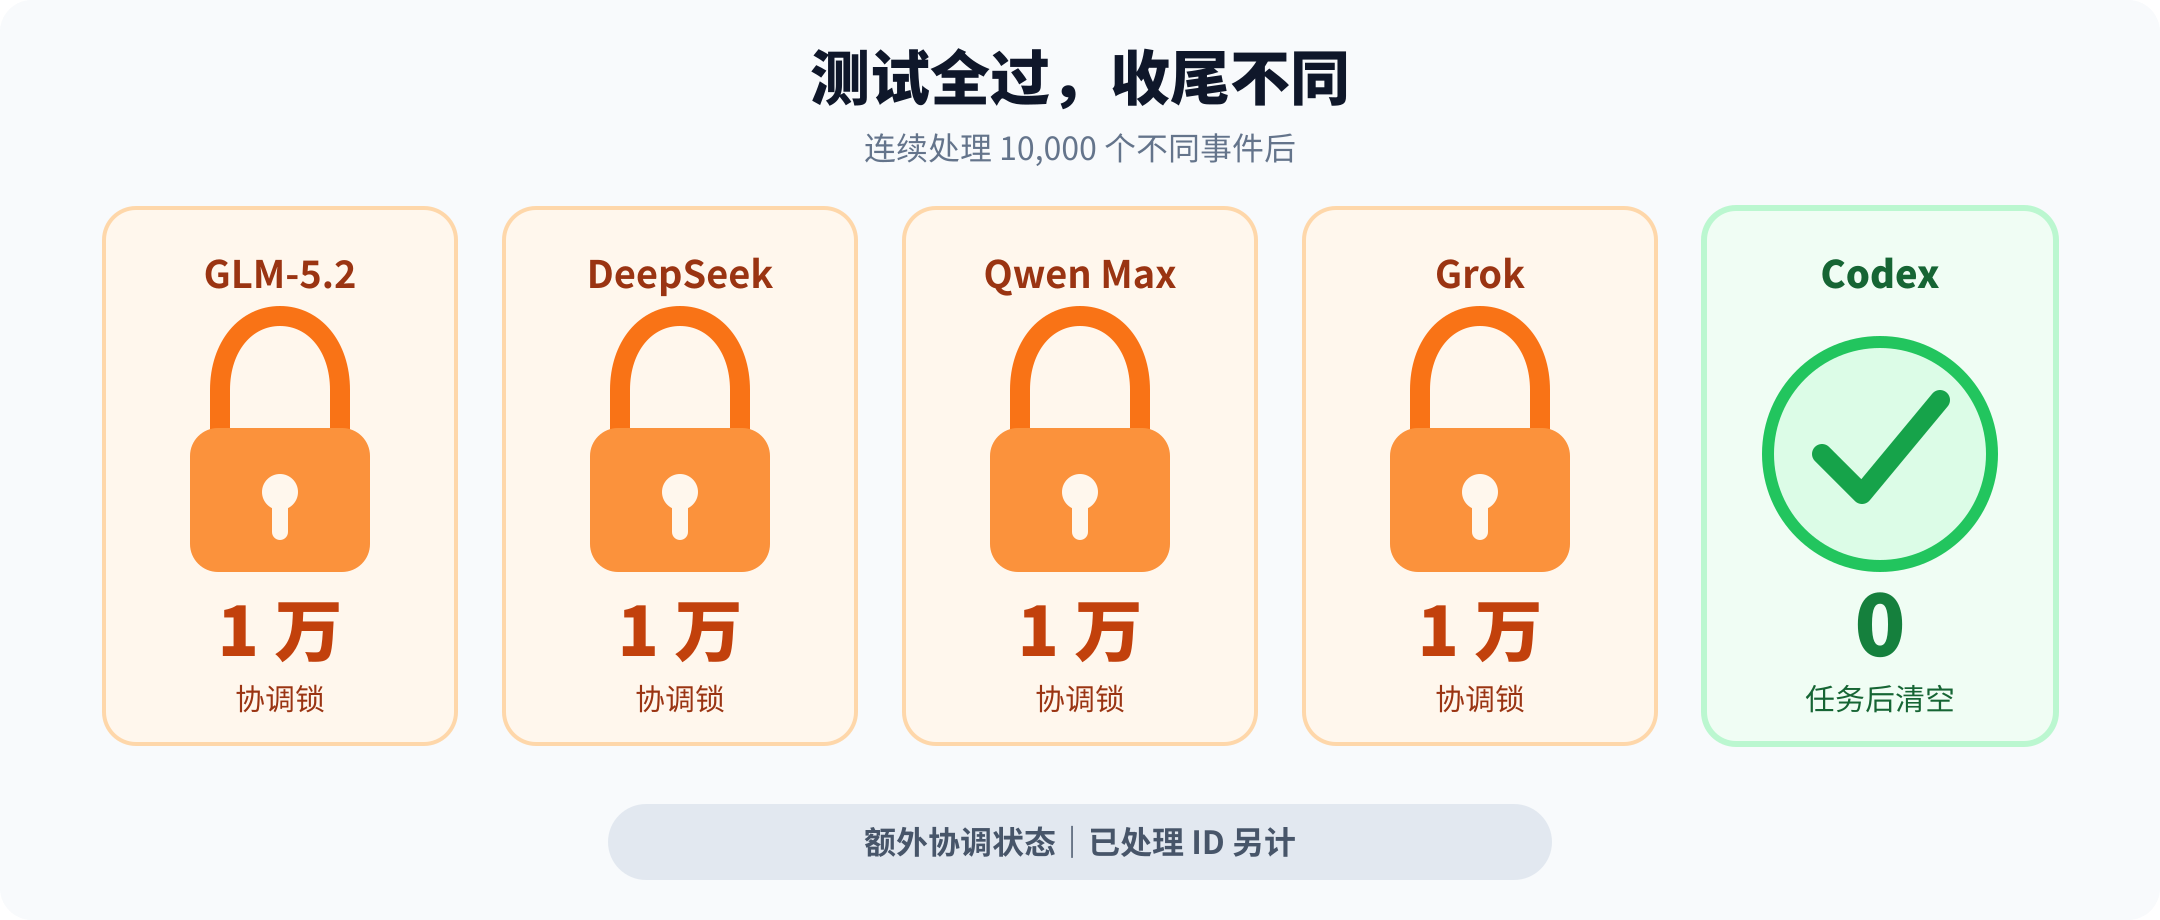
五款实现处理一万事件后的协调状态
前四个版本像给每笔订单发了一把终身制钥匙:订单早已结束,钥匙仍未注销,各留下一万条已经用不到的临时状态。Codex 的处理中记录回到了 0。
我没有把它直接叫内存泄漏。一万把异步锁没有在实验中拖垮服务,而且五个版本为了防重入账,都还保留着一万个已处理订单编号。真实系统仍应把业务记录放进带过期策略的持久化存储。
这里需要区分两类状态:已处理订单是业务记录,保留多久由业务规则决定;协调锁只是执行期间的临时状态,任务结束后通常没有继续留着的必要。题目没问状态回收时,只有 Codex 的实现清掉了临时状态;这就是第六题保留它、而不是另四款版本的原因。
这次怎么选,以后怎么验
这轮实验只覆盖小型 Python 仓库和我当前的账户、网络路线。GLM、DeepSeek、Qwen 跑在指定云机的 OpenCode;Grok 和 Codex 因远端没有可用凭据,改在另一台机器用官方 CLI。表上的耗时是当前系统链路结果,不是裸模型速度榜;预付套餐和订阅账户也排不出价格冠军。
在这个边界里,我的选择很具体:
边界清楚、有测试、改完就走的小任务:继续用已接入、稳定、等待和成本可接受的那款。30 次全过说明正确率不是换模型的理由。
并发、失败重试、准备长期跑的服务补丁:这轮应优先看 Codex 的实现,因为它把临时协调状态收回了零。它不是全能冠军,只是在状态生命周期这一项上有可复现优势。
以后验收任何 Coding Agent,绿测之后固定追加四项隐藏补考:失败后能否重试;相同业务键能否防重;不同业务键能否并行;一万次不同请求后,临时状态有没有回收。Agent 自己写的验证脚本只能当线索,CI 里还要有独立测试。DeepSeek 和 GLM 都已经演示过:业务代码对了,自测脚本仍可能写错。
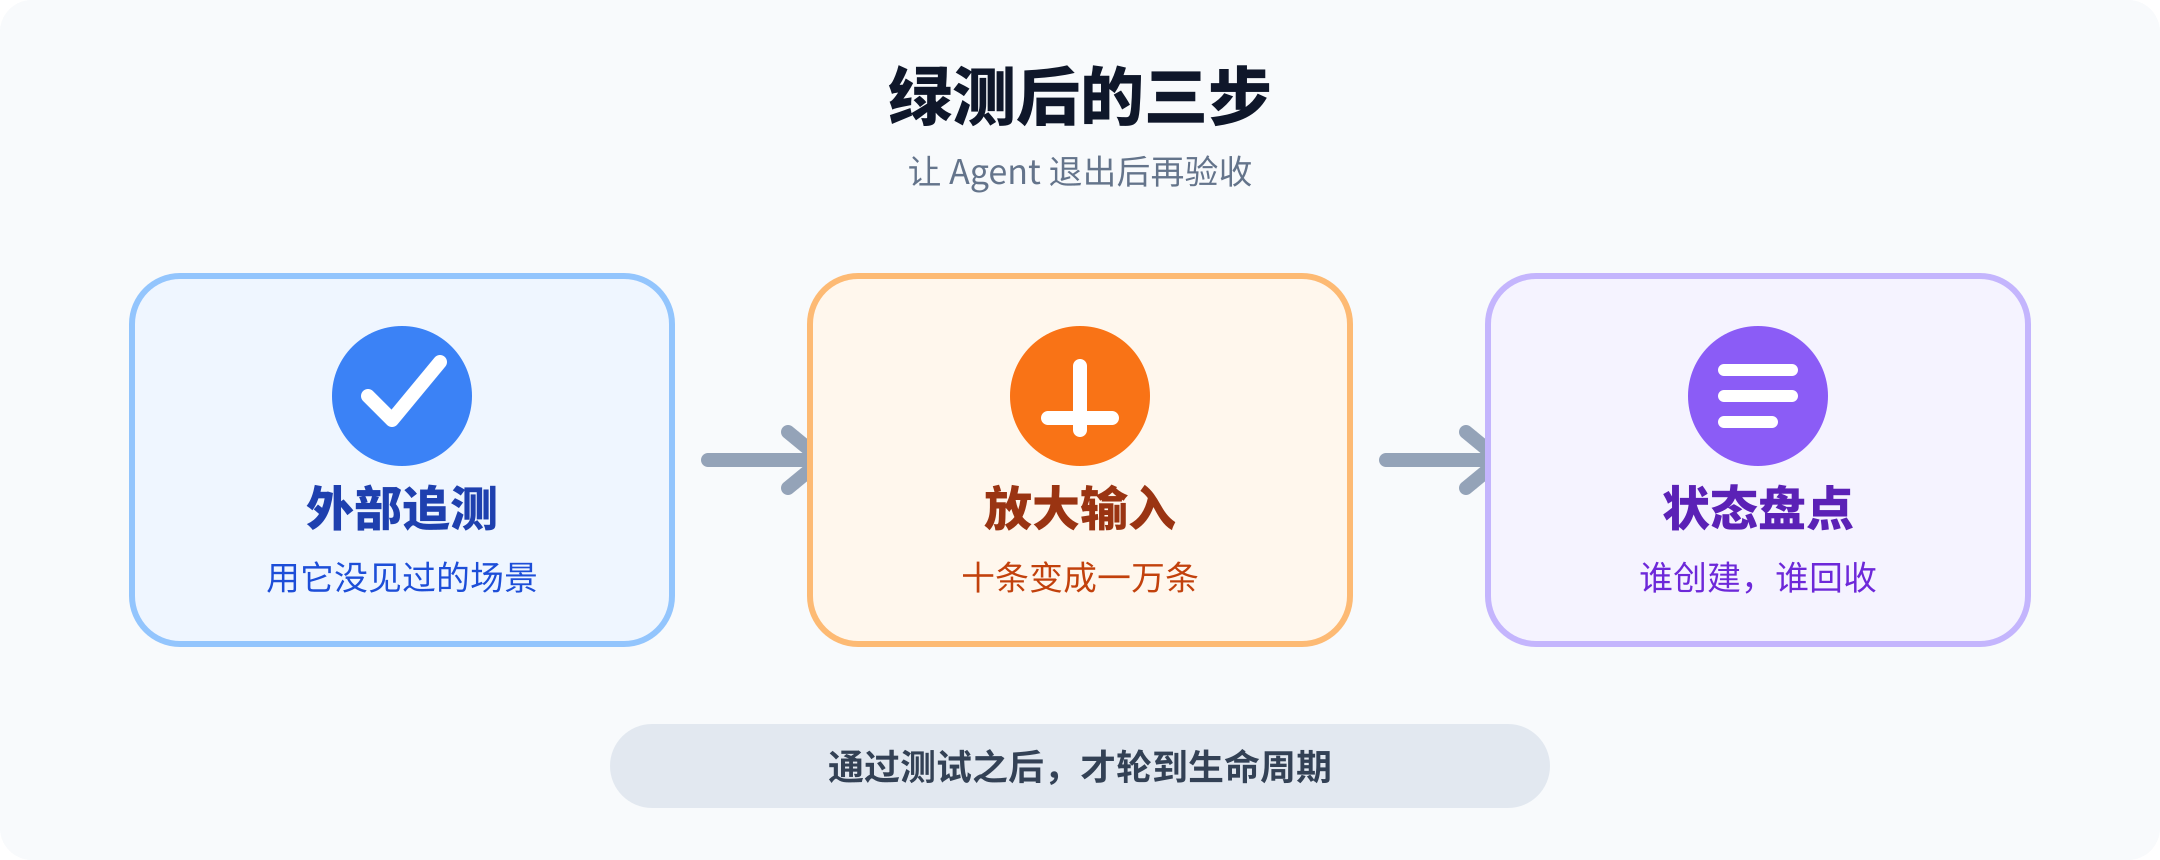
Coding Agent 绿测后的三步验收
小任务选最顺的路线;长期服务补丁,要为失败、并发和状态生命周期补考。模型榜单帮不了你验收一段准备长期运行的代码;能帮上忙的,是你带着这份隐藏清单进 review。