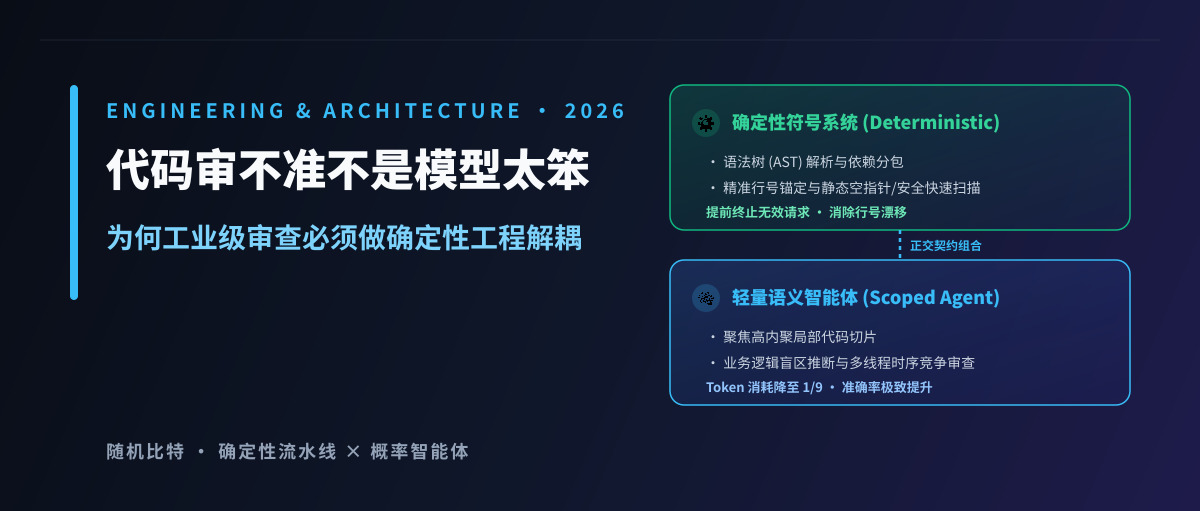
当工程团队尝试引入基于大语言模型的自动化代码审查时,最初的设想往往极为乐观。许多团队直接调遣通用编码智能体,配置详尽的审查提示词,试图让大模型充当资深架构师,对每一次提交的 Pull Request 展开行级质量审查。然而,随之而来的实际运行表现却往往令研发团队大失所望。
在实际流水线中,一旦代码变更规模超过数百行,大语言模型往往会出现明显的选择性忽略,大量潜在缺陷在长上下文的信息稀释中被漏审;模型输出的修改建议经常出现行号严重漂移与跨文件错位,指向已经不存在的变量;伴随而来的是大量模棱两可的风格说教与虚假报警,严重干扰了工程师的研发节奏,甚至迫使团队最终将审查机器人完全移出合并流水线。
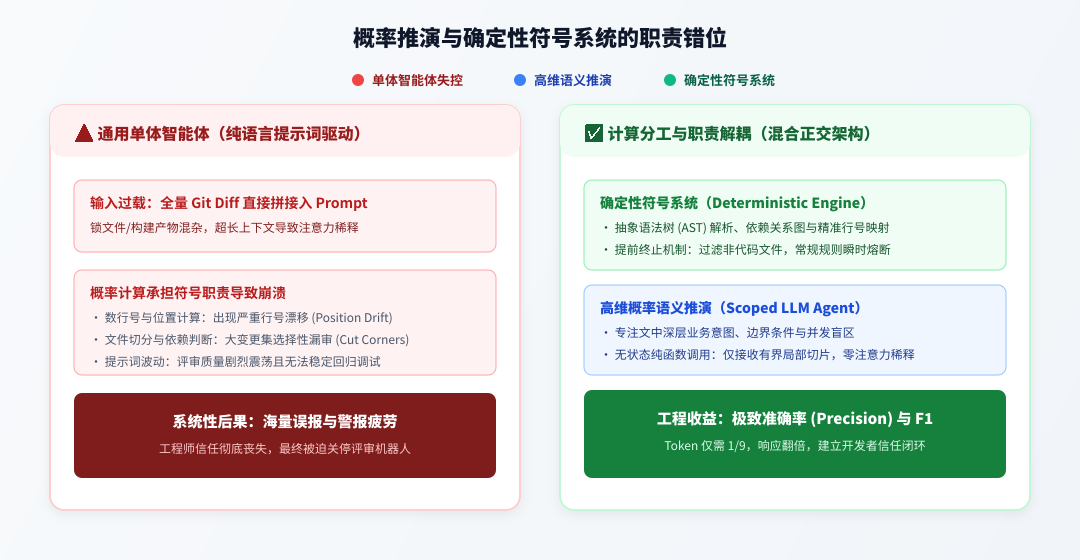
自动化代码审查的根本瓶颈不在于语言模型的推理能力,而在于让概率模型承担了原本属于确定性符号系统的计算职责。
概率推演与确定性符号系统的职责错位
从计算本质审视,大语言模型属于高维语义空间的概率推演系统。模型擅长理解自然语言描述、推断代码背后的业务意图,以及识别深层的逻辑死锁与安全盲区。然而,代码审查并非单一维度的语义理解任务,其底座包含大量高精度的确定性符号计算,涵盖严格的抽象语法树 AST 解析、符号引用跳转、精确字符偏移量计算以及基于分支图的 Git Diff 差异分析。这些计算在传统编译原理中由确定性状态机完成,状态转移过程不允许存在任何统计概率上的扰动。
当系统要求通用智能体仅凭一段自然语言提示词去同时承担文件分包、上下文检索、行号精确定位与逻辑分析时,模型的注意力资源会被极大地分散。面对上千行的复杂代码变更,自回归生成机制在缺乏硬性计算约束的状态下,必然会在长序列依赖中出现注意力漂移。模型出于上下文窗口与计算预算的压力,会自发简化审查路径,导致缺陷漏网与位置偏移。
试图依靠提升基础大模型的参数规模或反复微调自然语言提示词来根治行号漂移,在系统设计上并不成立。在没有确定性状态机硬约束的环境下,让概率模型读取数万 Token 的源码上下文并输出精准字符定位,必然遭遇数学上的精度收敛极限。
静态流水线前置过滤与提前终止机制
解决审查准确率低下的首要工程手段,是在请求进入推理引擎之前引入确定性工程过滤,并坚决贯彻提前终止原则。
在常规的代码变更集中,往往夹杂着大量无需语言模型介入的干扰项,例如依赖锁定文件、编译器自动生成的绑定代码、静态资源以及微小的格式修改。如果将这些内容全量灌入模型上下文,不仅会造成计算资源的严重浪费,更会引入高频的背景噪声。
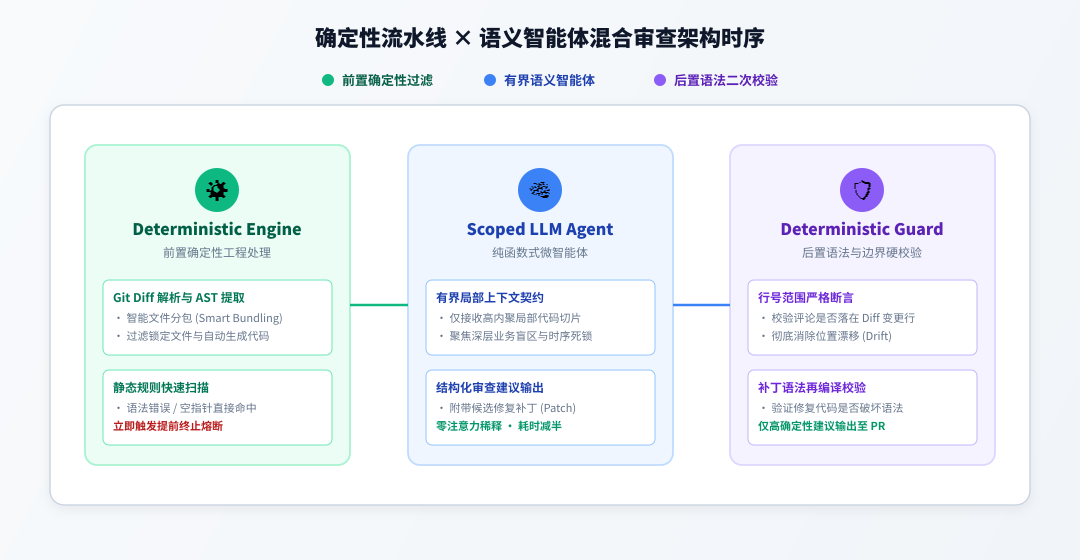
工业级审查系统会在物理接入层构建确定性静态分析流水线。该流水线先行解析 Git 差异树,提取抽象语法树与文件依赖拓扑,将庞大的跨模块变动智能切分为若干高内聚的自治代码切片。在这个阶段,基于确定性算法的常规规则引擎会优先执行快速扫描,针对显式的空指针引用、类型越界以及静态安全特征进行模式匹配。
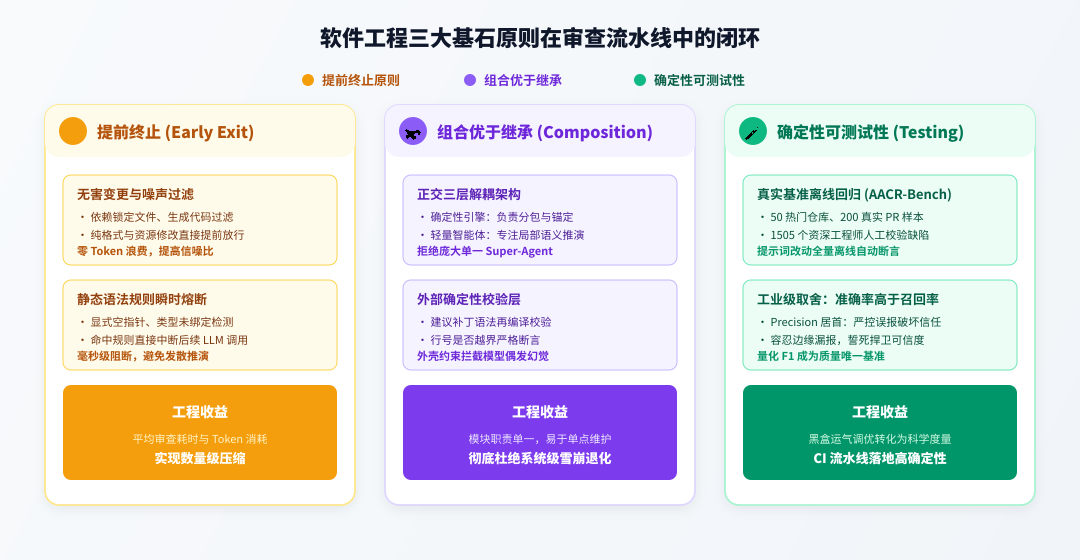
这一设计直接兑现了提前终止原则。一旦前置静态流水线捕获到严重的语法破坏或确定性规则违规,系统便会即刻中断后续流程并直接抛出阻断结论,彻底阻断无效请求向大语言模型扩散。对于那些纯属格式调整或资源增删的无害切片,系统同样会在前置阶段提前终止,避免在无价值任务上空耗大模型的推理预算,使进入大语言模型的有效信息密度得以成倍提升。
正交解耦架构与轻量微智能体组合
在处理真正的业务语义与并发隐患时,系统的核心架构决策应当坚决遵循组合优于继承原则。
许多失败的实践往往倾向于构建一个全知全能的超级智能体,试图通过不断堆叠系统提示词,让单一模型继承语法检查、逻辑验证、性能审查以及安全合规的全部职责。这种单体设计不仅使得提示词极其脆弱,任何局部微调都会引发其他维度的质量退化,而且导致系统的失败原因难以定位。
与其构建一个全知全能却难以调试的单体智能体,不如将确定性静态分析、有界语义微智能体与外部语法校验器正交组合。
在正交解耦的混合架构中,各组件被赋予严格的职责边界。确定性工程引擎充当调度底座,负责代码切片、依赖树装配与精准行号映射。语义推演则由多个针对特定领域的轻量微智能体承担。每个微智能体以无状态纯函数的方式运行,仅接收经过静态引擎提炼的局部代码切片与专项目标契约,例如专门负责识别跨模块时序竞争或复杂状态机转换。
当轻量智能体生成审查意见与建议补丁后,输出结果立即流转至后置的确定性语法与格式校验层。外部校验器会重新编译测试建议补丁的语法正确性,严格校验其行号是否落在 Git Diff 变更行范围之内,并验证修复方案是否破坏原有类型系统。这种正交组合保证了即使概率模型偶发幻觉,确定性的外壳也能在第一时间将异常拦截并过滤。
工业级审查的准确率取舍与确定性评测
在自动化代码审查的工程落地中,衡量系统价值的核心指标与传统学术评测存在显著差异。在真实的研发团队协作中,开发者对自动化审查工具的耐受阈值极低。一旦工具频繁抛出无根据的虚假报警,工程师会迅速产生警报疲劳,进而失去对自动化系统的基本信任。因此在工程取舍上,准确率的优先级必须显著高于召回率。系统宁可主动放过某些模糊的边缘疑点,也绝不能向开发者推送充斥噪音的错误结论。
在工业级代码审查体系中,误报所引发的工程师信任危机远甚于漏报,极致的准确率与确定性测试才是自动化落地的生命线。
为了将审查系统从充满不确定性的黑盒调试演进为可严格度量的现代软件工程,系统必须建立确定性的离线测试基准。在包含 50 个开源代码库、200 个真实 Pull Request 以及 1505 个经由资深工程师严格标注的缺陷评测基准 AACR-Bench 上,确定性工程与轻量智能体正交组合的架构表现出了压倒性的优势。该架构相比全量通用的单一编码智能体,不仅将 Token 消耗压缩至约九分之一,大幅缩减了审查响应延迟,更在准确率与综合评分上实现了决定性超越。
这种离线评测能力赋予了代码审查系统高度的可测试性。任何规则的增删、切片策略的微调或模型版本的切换,都能够在真实的标注快照集中完成自动化回归测试。
当研发团队不再将代码审查寄托于大模型的偶然灵光,而是将其建立在提前终止的过滤闸刀、组合解耦的正交微模块以及可量化回归的 CI 流水线测试基准之上时,人工智能辅助的研发效能提升才真正跨越了概率的迷雾,收敛为严谨可控的工程现实。