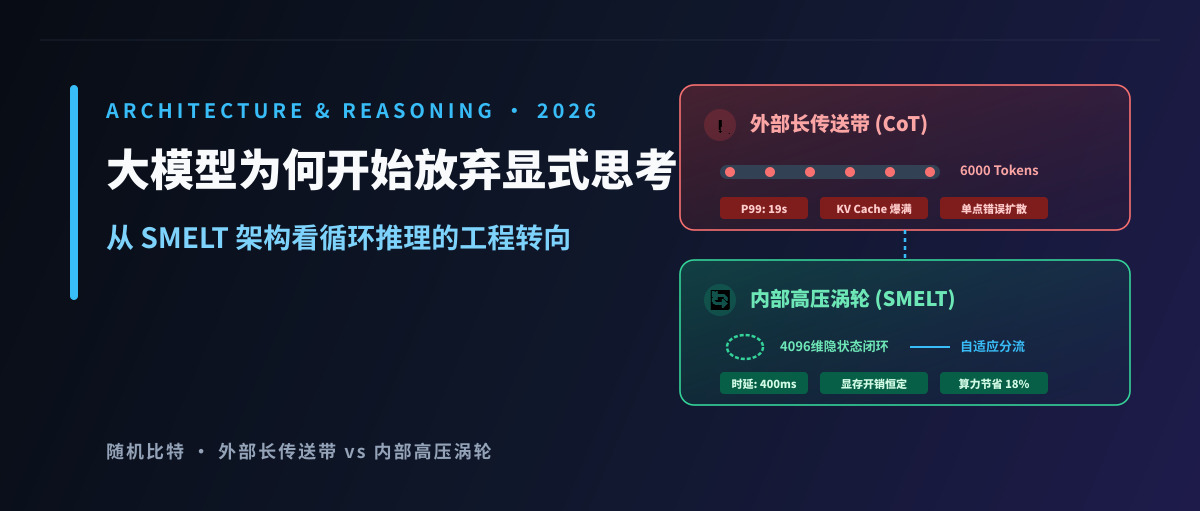
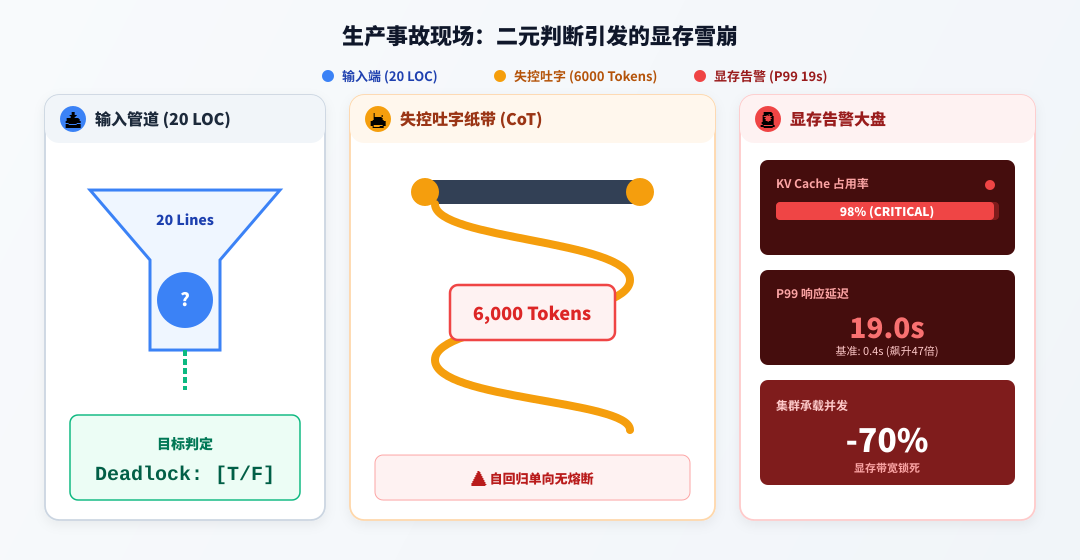
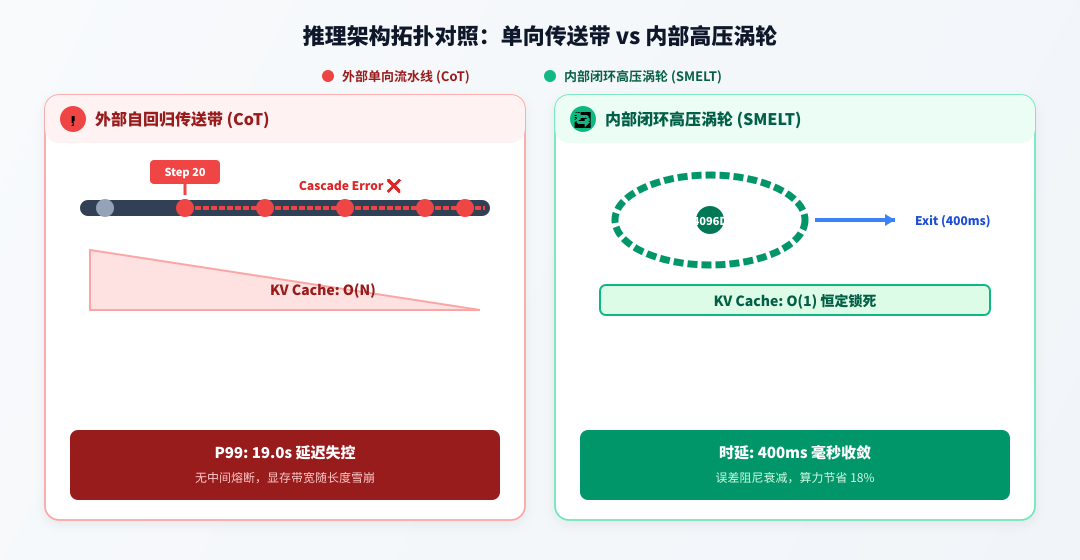
凌晨两点,线上高并发支付服务的监控大盘突发猩红警报,系统第九十九百分位响应延迟在十分钟内从四百毫秒飙升至十九秒。排查发现,模型在对一段二十行退款重试代码进行并发死锁校验时,为了输出一个简单的布尔判定,自发生成了超过六千个推理字符。漫长的自言自语迅速挤爆了键值缓存,导致单机实例并发承载力断崖式下跌百分之七十。
显式思维链在生产系统中的工程荒谬
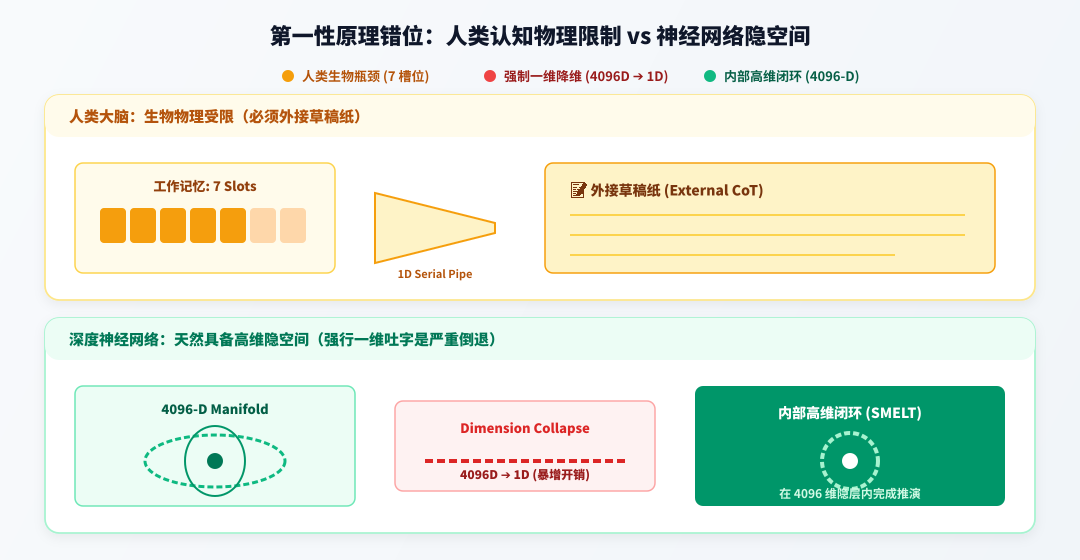
从计算复杂度的第一性原理审视,让模型在外部逐字吐出思维链,实质上是把高维张量演变强行降维投影到一维自回归时间轴上的工程妥协。人类受限于大脑前额叶仅有约七个工作记忆槽位,且语言通道属于一维离散符号,才必须借助草稿纸喃喃自语。然而现代深度神经网络在内部原本就具备四千零九十六维的连续隐状态空间,强行在外部展开数千个字符,构成了高并发系统极其沉重的物理代价。
在单向自回归传送带上,每一次逐字生成都会使键值缓存呈平方级累积。更致命的是缺乏容错机制:一旦前二十步发生逻辑漂移,后续数千步便只能在被污染的状态上继续展开,既无法中途刹车,也无法自适应截断。
大模型推理的演进本质不是无休止地拉长显式思考链,而是通过循环层架构将计算深度收敛回内部高维表征空间。
拓扑重构与张量回路中的物理装置
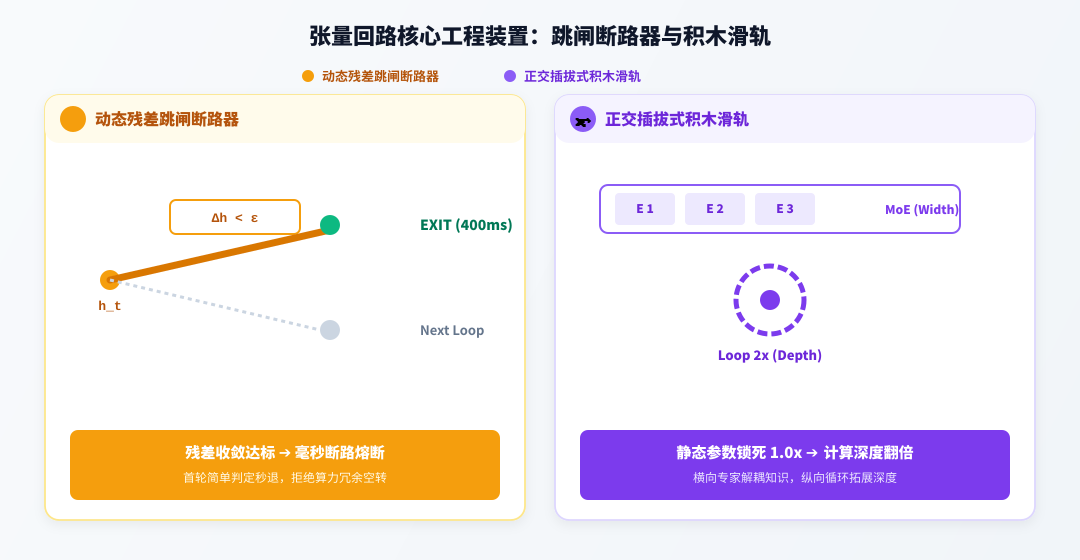
为了从根源上打破长序列带来的显存绞杀,清华大学与字节跳动联合开源的 SMELT 架构展示了内部拓扑收敛的解法。模型不再盲目在外部打字,而是在内部张量回路中重构了确定性的工程装置。
在循环回路中,系统引入了动态残差跳闸机制。每一轮中间层循环结束后,内置探针实时监测残差向量的变化率。当简单逻辑在首轮循环结束时残差已经低于阈值,系统在毫秒内自动跳闸直接切入解码层,将判定耗时压制在四百毫秒以内。
针对复杂推理,SMELT 拒绝粗暴堆叠物理层数,而是采用正交插拔积木设计:横向稀疏门控专家负责解耦知识容量,纵向中间循环层负责拓展计算深度。在保持静态参数与显存缓存严格锁定的前提下,让有效推理深度实现了弹性倍增。
严格算力对齐下的确定性工程收益
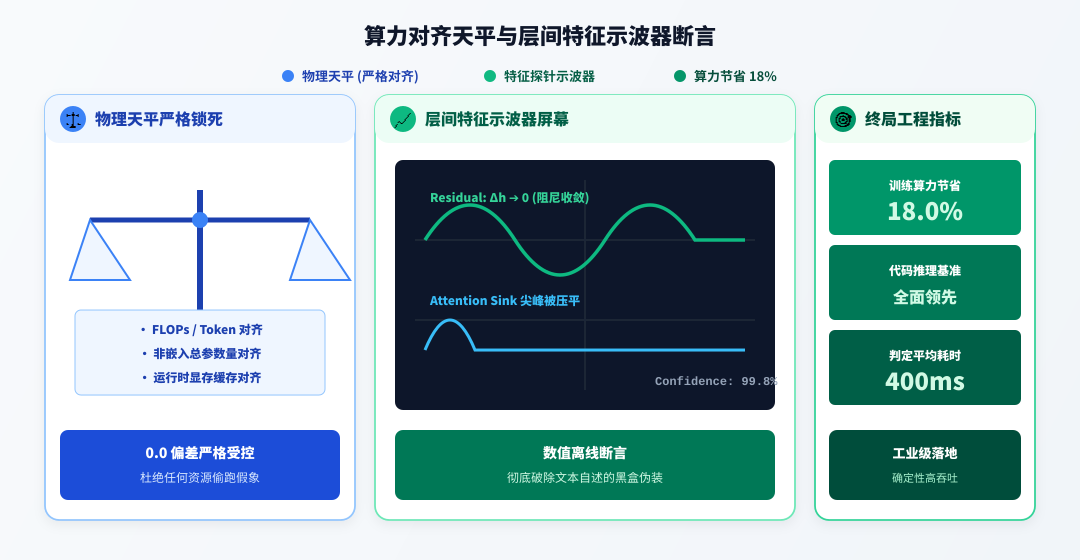
在模型架构评测中,脱离物理算力预算往往会得出虚假结论。SMELT 建立了严格的受控基准,同时锁死每 Token 浮点运算次数、非嵌入参数量与运行时缓存开销三大物理预算。
在物理预算完全对齐的前提下,将网络中间半数层进行两次循环复用的模型,在计算最优前沿上实现了训练算力百分之六点八至百分之十八的显著节省,并在代码生成下游任务中大幅领先。
更重要的是工程断言能力的回归。以往外部思维链充斥着自圆其说的文本黑盒,而隐层循环演变可以直接接驳特征示波器。通过捕捉残差收敛曲线与注意力宿的显著抑制,工程师首次能够在离线测试中建立可复现的数值断言。
与其让大模型在外部时间轴上展开冗长且易错的自言自语,不如在内部网络拓扑中构筑可自适应提前终止的高维循环流。
当深度模型摆脱对显式吐字的依赖,将推理深度收敛至具备毫秒跳闸能力的内部循环拓扑时,智能系统才真正迈向了工业级高吞吐的成熟阶段。