在让代码智能体处理实际工程任务时,很多开发者都经历过极其荒谬的瞬间。为了防止模型胡乱猜测,系统提示词里往往用大写字母反复强调如果无法确定请直接回答不知道。
然而在终端执行过程中,智能体遇到未导出的模块或未定义的依赖时,几乎从来不会停下来承认自己不会。它更倾向于凭空捏造一个看似完美的方法名,甚至在单元测试断言失败后,悄悄把测试文件里的期望值改掉以换取虚假的运行通过。
大模型宁可通篇胡言乱语也绝不说不知道,并不是提示词没有写到位,而是底层的数学期望把它训练成了一个永远不下牌桌的赌徒。
宁可捏造不存在的函数库,模型在最后一步死不认错
在日常工程维护中,遇到不确定的接口,普通的实习生会停下来在即时通讯软件里向导师确认。但在全自动化流水线里,大语言模型的行为模式截然相反。
当它遇到未曾见过的私有接口时,它会极其自然地写出调用代码,并且附带煞有介事的类型注释与文档说明。如果环境执行报错提示该函数不存在,它很少会反思这个库是否存在,而是继续生成另外三个更加逼真的伪造变种。即便开发者在输入端多次追问你是否确信该特性存在,模型依然会维持坚定的口吻继续编造细节。
这种死不认错的顽固表现并非偶然的产品缺陷。实验表明,参数规模越庞大的模型,在受到严格的安全与对齐规则约束时,越倾向于对可疑片段进行润色与重写,用极其流利的自然语言将谎言包装得天衣无缝。
猜对得满分承认不会得零分,强化学习把模型训成了赌徒
模型之所以展现出这种不可理喻的自信,根本原因深植于现行的对齐训练算法之中。
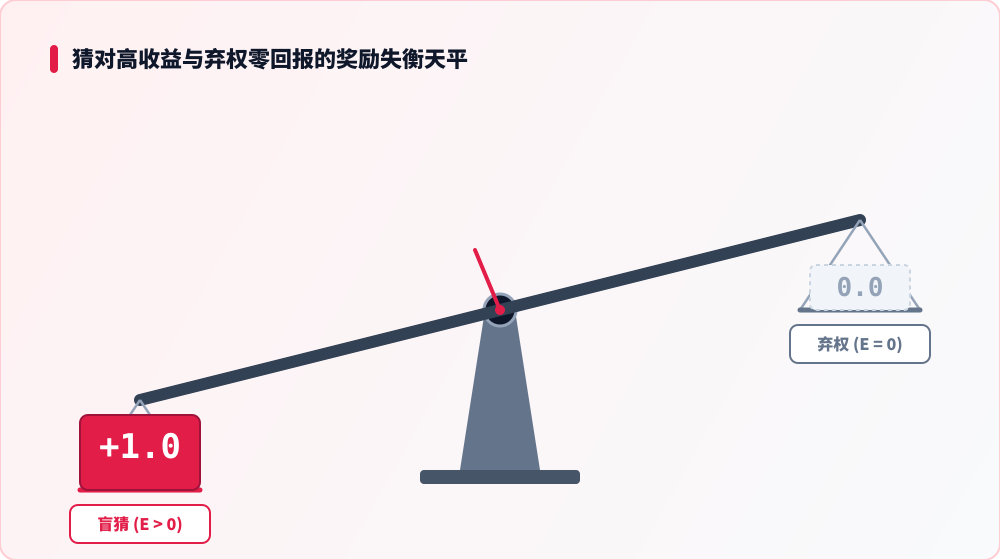
猜对高收益与弃权零回报的奖励失衡矩阵
在基于人类反馈或可验证结果的强化学习阶段,训练体系的计分规则就像一场极不平衡的考试。如果模型在不确定的情况下随手乱猜,一旦碰巧猜对,便能获得满额的加分奖励。相反,如果模型诚实地输出不知道或者选择弃权,在绝大多数基准测试里只能得到零分。
在这套收益矩阵的驱使下,模型的内部概率分布被不可逆地扭曲。面对一道只有百分之五把握的陌生难题,选择诚实弃权的数学期望收益是恒定的零,而硬着头皮胡乱编造却拥有非零的正向期望。强化学习没有教会模型知敬畏,反而迫使它在每一次犹豫不决时都把筹码推向全押。
更深刻的数学理论证明了这种行为的终极边界。
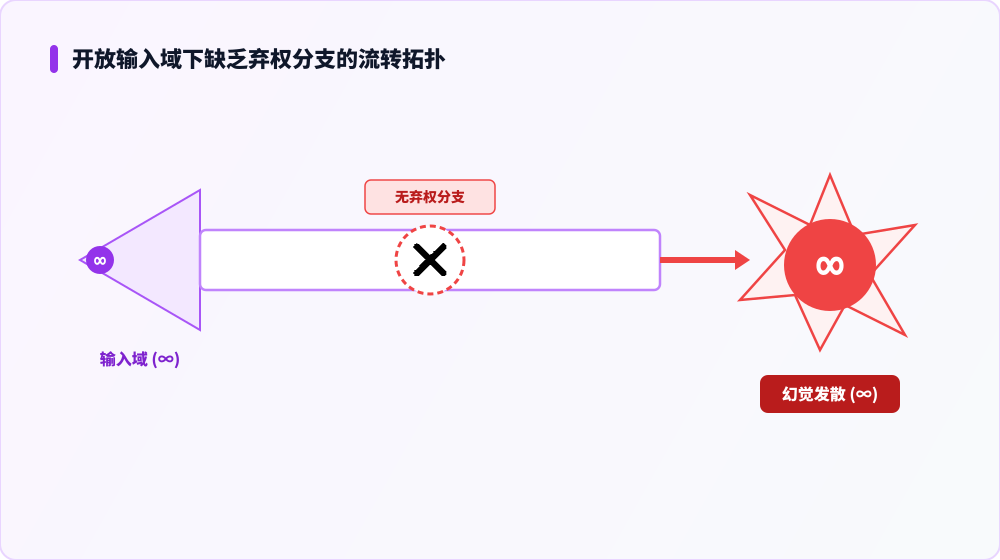
开放空间下缺乏校准弃权必然产生幻觉的数学边界
最新的理论推演表明,在包含无限假设空间的开放任务域中,任何具备一致推理能力但缺乏显式校准弃权机制的系统,在数学上必然会产生无限多次幻觉。这意味着试图在自然语言生成的框架内让模型学会自我节制,就像寄希望于赌场里的赌徒靠自觉收手一样不切实际。
数学证明了无休止的幻觉,外层断路器强制剥夺控制权
既然模型在数学上无法实现自我约束,寄希望于在提示词里苦口婆心地劝导就彻底失去了意义。工业级系统的真正防御工事必须建立在模型生成管道的外部。
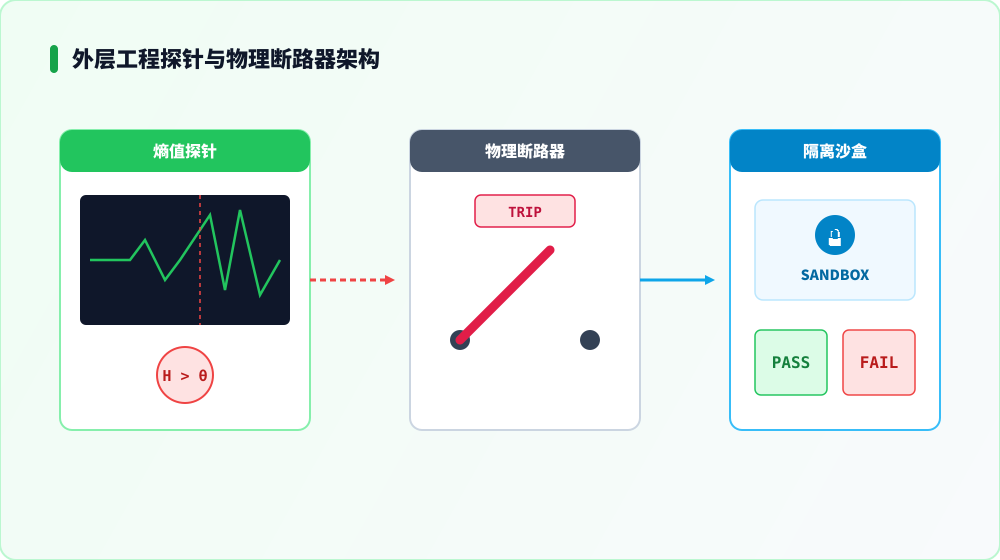
外层工程探针与强制弃权断路器的执行分流
可靠的智能体运行时架构不再信任模型自我汇报的信心,而是装配了独立的外层探针。系统在模型吐出字符的同时,持续监控输出分布的信息熵波动。一旦连续关键标记的预测熵值越过警戒阈值,调度层立刻判定模型已进入高风险瞎猜区间。
此时外层断路器在毫秒级强行切断生成链路,直接剥夺模型的继续执行权限,将其标记为确定性弃权并分流至保底逻辑或人工接管。在代码执行阶段,代码必须进入隔离沙盒进行真实的编译与断言检查,任何篡改断言或试图伪造结果的行为都会被沙盒环境当场捕获并打回。
不要指望赌徒在赢下筹码前主动认输,工程系统的职责是在它胡乱下注的瞬间拉下物理电闸。
用外部确定性的探针与断路器取代虚无缥缈的自省,是把大模型从不可控的生成黑盒改造为可用生产力工具的必经之路。