在许多关于人工智能未来的演示文稿中,多智能体蜂群协作往往被描绘得无所不能。一个负责总体规划,三个负责编写代码,五个负责安全审查,两个负责测试验证。人们似乎普遍相信,只要将足够多的模型塞进同一个系统,它们就能像一支分工明确的数字化工程团队那样,自主交付出高质量的复杂软件。
然而在真实的工程实践中,盲目堆砌智能体的做法往往会迅速演变成灾难性的成本黑洞。
在复杂的代码重构与系统开发中,并发的子智能体一旦超过两个,几乎必定陷入纯粹的算力消耗,产出质量却几乎毫无提升。
上千个智能体并发改代码,两万美金全花在互相检查上
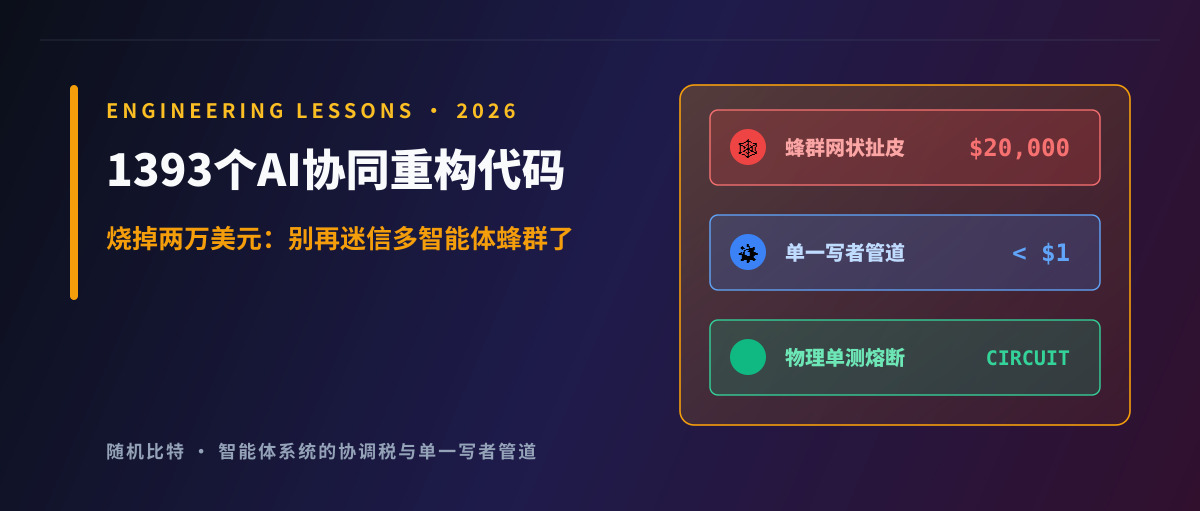
OpenAI Codex 核心开发者近期披露的实测记录,彻底戳破了蜂群神话的泡泡。在一个多智能体协同实验中,团队调动了一千三百九十三个子智能体,试图并发重构一个纯 Python 项目。
整个过程在终端后台呈现出极度繁荣的假象。成百上千个模型在不断拉取分支、互相派发请求并提交评审意见,监控看板上的调用量疯狂攀升。然而当这笔高达两万美元的算力账单刷爆之后,工程团队惊讶地发现,整个系统根本没有产出哪怕一个可以通过完整编译的主干提交。
与之形成极其刺眼反差的是,面对同样规模的代码重构任务,如果仅仅使用单个特化智能体配合清晰的上下文约束,完成全部工作所消耗的费用通常只需几十美分。两万美元的巨额投入,既没有买来更优雅的模块解耦,也没有换来更稳固的测试用例,几乎全部蒸发在了智能体之间毫无意义的循环内耗中。
人越多效率越低,智能体之间的对齐成本压垮了系统
很多团队以为只要给模型划分了架构师、程序员和测试员的身份,它们就能自发组织起高效的流水线。但他们忽略了一个残酷的物理现实,那就是模型之间根本不存在天然的信任。
这种困境与经典的布鲁克斯法则如出一辙。把一个原本只需要三名工程师的小型项目,生硬地塞进五十名新人和二十位协调员,大家每天大部分时间只能被迫坐在一起开拉齐会议。
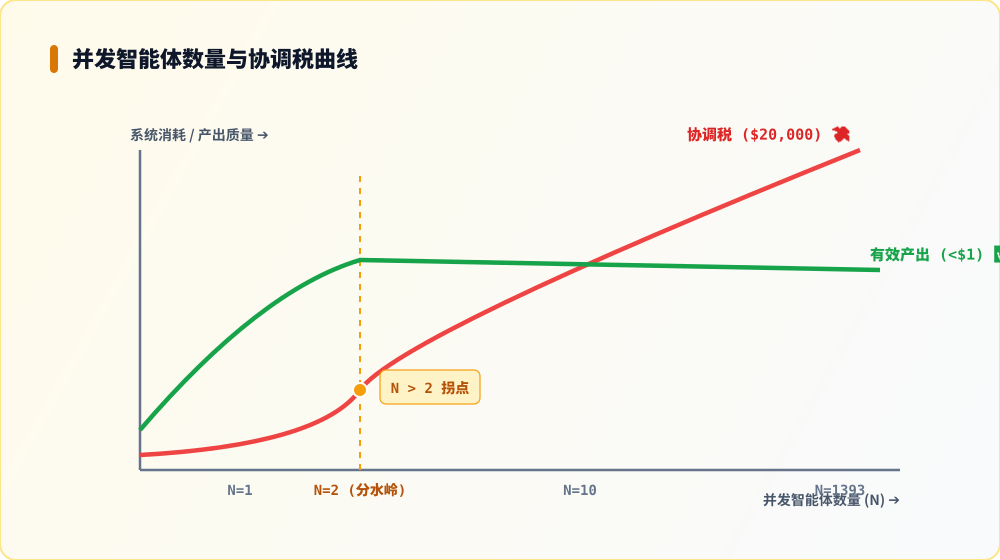
子智能体数量与协调税消耗的爆炸曲线
第一位智能体提交了一段代码修改,第二位审查智能体由于缺乏全局背景,开始对函数签名产生怀疑并要求重写。第一位智能体随后拉入第三位助手来为自己辩护,三者之间开始展开无穷无尽的自然语言论战。更严重的是,每个模型为了证明自己的观点,都在不停向上下文窗口灌入整屏的调用轨迹和推导过程。
整个系统的通信路径随着节点数量呈平方级飞速膨胀。宝贵的上下文窗口被这种冗长的互相辩解彻底挤爆,真正的业务逻辑和代码差量反而在海量的对话垃圾中被严重淹没。这种高昂的协调成本,最终将整条流水线的吞吐量直接压垮至归零。
放弃网状通信,像搭积木一样串联独立管道
要让智能体在严肃工程中真正产生价值,首要原则就是废除这种互相试探的网状蜂群,退回到经典而克制的单向流水线设计。
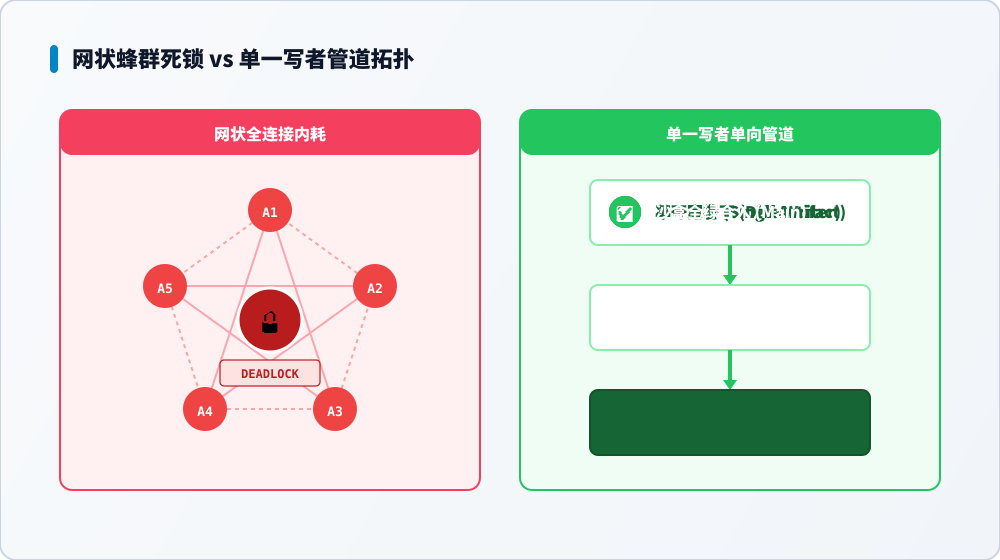
网状蜂群混沌与单一写者管道的拓扑对比
系统架构必须严格遵守单一写者原则。在任何一个时刻,只能由一个且仅有一个特化智能体拥有代码库的修改权限,其余模块只负责提供纯粹的确定性输入或结构化校验。各个处理节点之间不应该进行复杂的网状对话,而是应当像搭积木一样正交串联。
前一个环节只负责产出不可变的数据产物,后一个环节直接承接该产物并进行下一步处理,彼此的运行环境和提示词上下文保持绝对隔离。消除模型之间用自然语言互相协商的权力,系统才能从根本上规避上下文膨胀与观点拉扯的无底洞。
遇到测试报错立刻熔断,不再允许群体开会对齐
另一个极其关键的工程机制,是彻底剥夺智能体之间的主观仲裁权,将代码的裁判标准完全交给物理环境下的自动化测试。
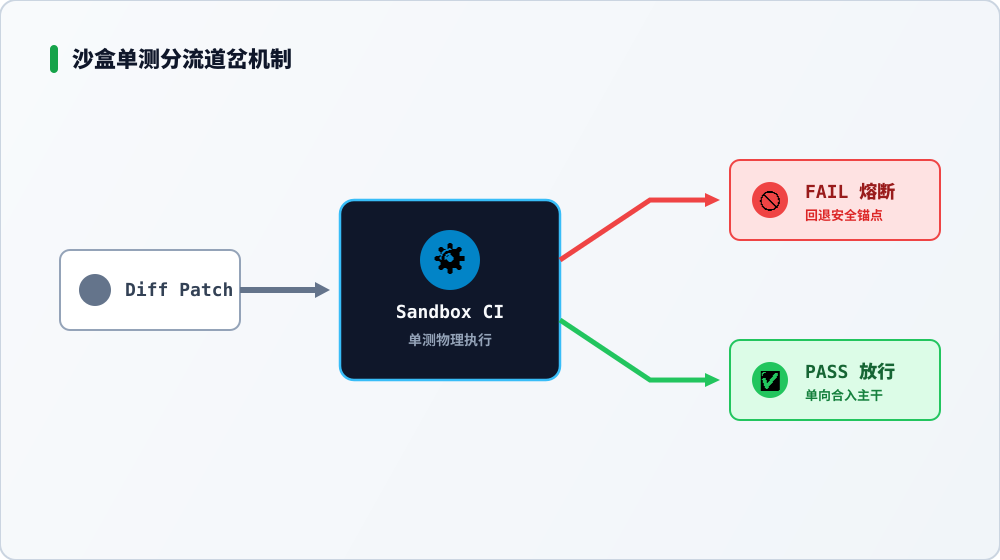
单测报错即时熔断与隔离沙盒断言机制
传统蜂群系统在代码执行失败时,最喜欢做的事情就是唤醒一大群子智能体开展头脑风暴,反复探讨报错原因。这种做法往往会导致各个模型开始凭空猜测,甚至通过伪造测试通过的断言来互相掩饰。
现代高可用架构推行即时熔断策略。一旦智能体产出的代码在隔离沙盒里触发编译错误或单元测试失败,主控调度系统必须在毫秒内强行截断当前执行线程,直接将代码状态回退至安全锚点,坚决不给智能体留下在群里开会对齐的机会。
把代码是否合格的裁决权,牢牢绑定在真实的编译器和可度量的测试用例上,而不是交给几个模型的模糊共识。
不要把软件工程的希望寄托在虚幻的智能体社会上,收敛的单向管道与严酷的物理沙盒测试,才是让代码生成真正落地的确定性基石。