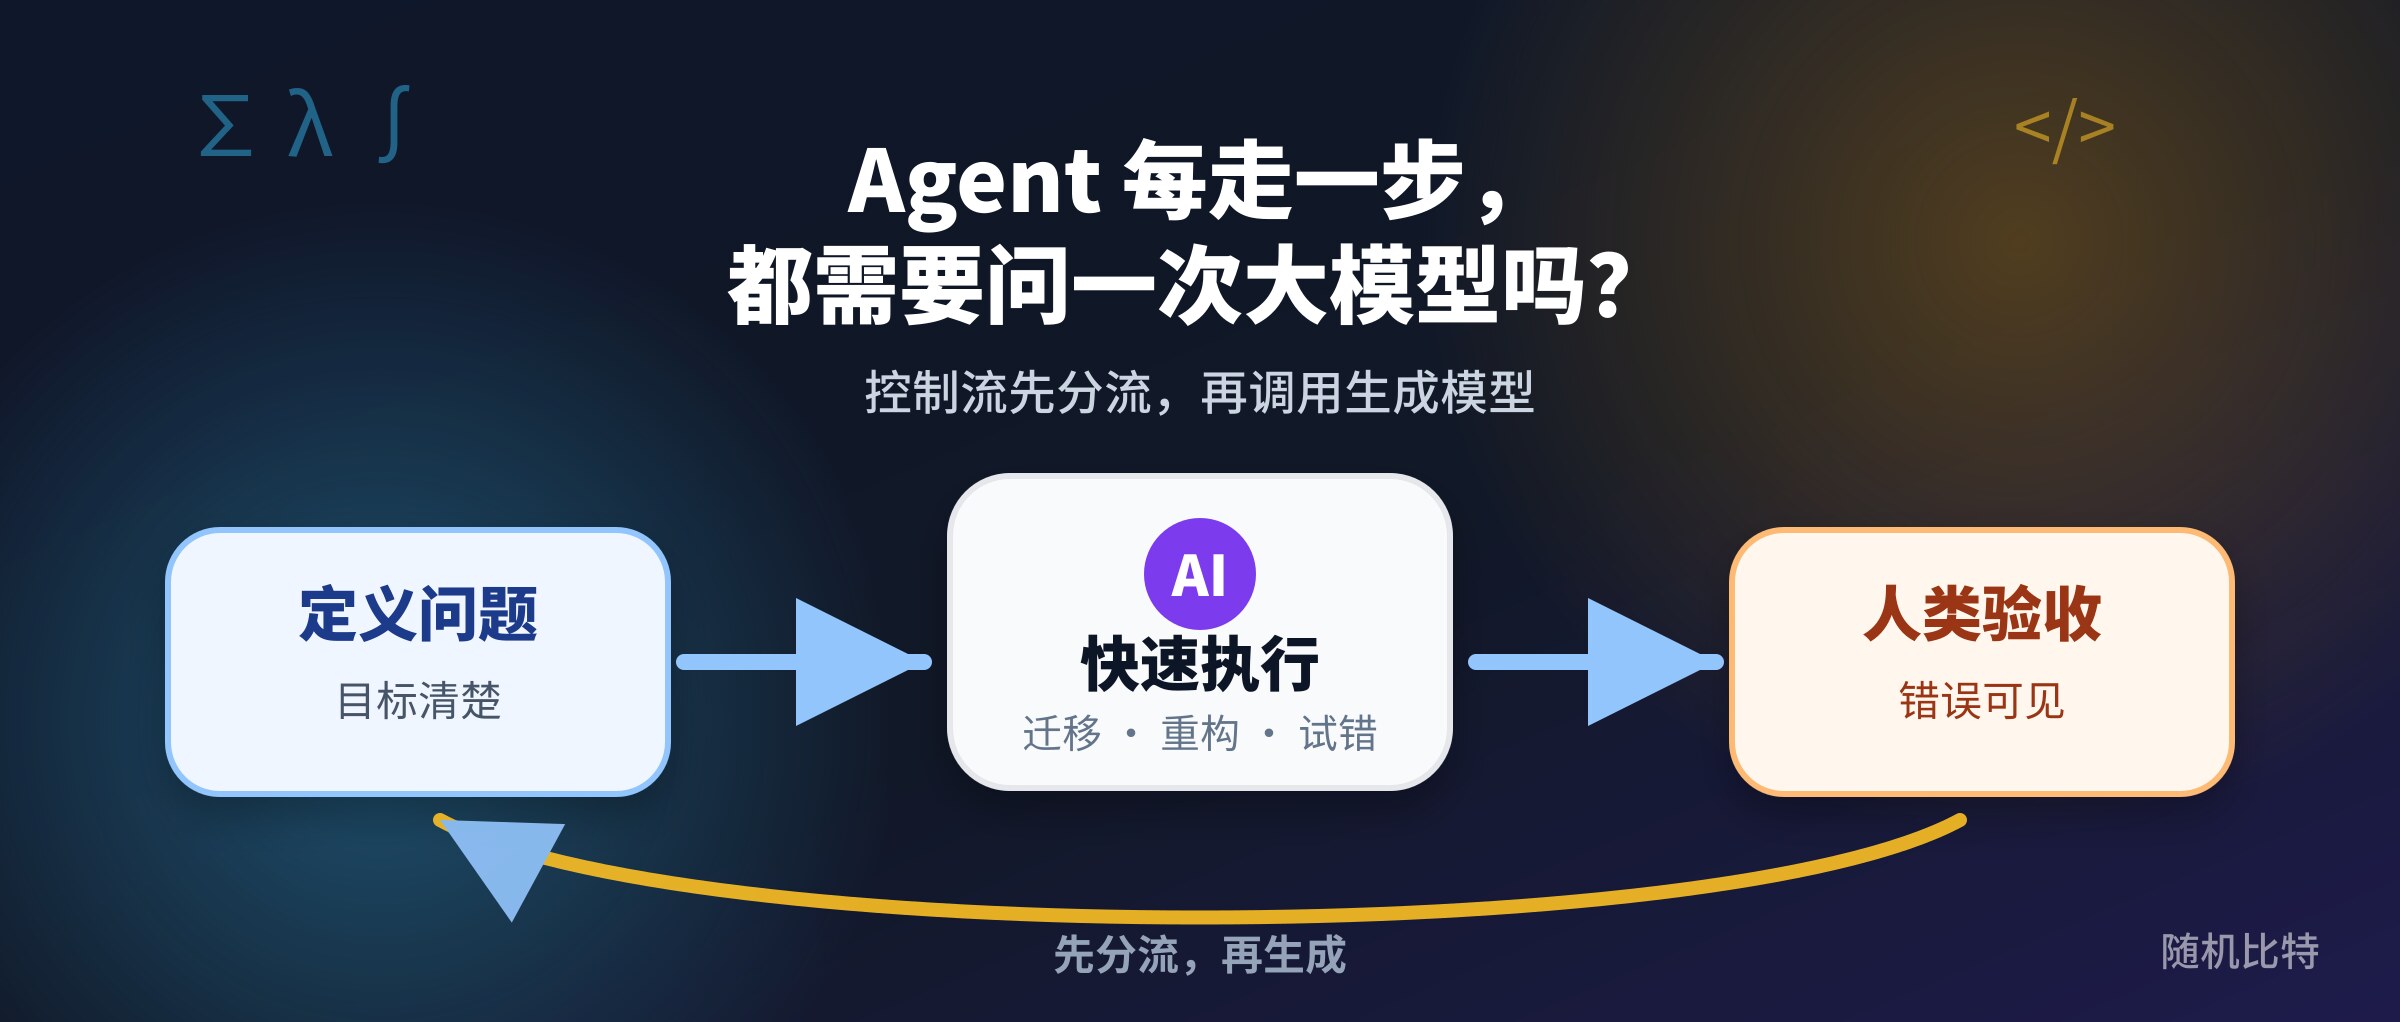
在一种“动作前单独调用生成模型检查”的编码 Agent 实现里,智能体刚执行完一条命令,控制台可能出现额外停顿;准备重试时还要再次检查;准备删除临时目录时仍需重新确认。这里的等待来自额外检查调用,工具执行和主模型规划的耗时应单独计算。
为什么会有这些额外等待?在这种 Agent 循环实现里,系统每推进一步,都要把当前环境状态、终端输出和历史记录打包成一段 Prompt,发给通用大模型,重复执行命令风险判断、错误类型识别和重试条件检查。
这一步可能成为系统的隐蔽瓶颈。每一次状态检查,都在发起一次完整的自回归文本生成。即使后台加入结构化输出约束,大模型仍然要逐个标记解码,网络往返与首字延迟也无法省略。在一种每次动作前另调生成模型做分类的实现里,额外的开放式问答可能成为延迟来源。
命令检查的分流路径
大模型擅长开放式推理和长程文本生成。但在真实的工程循环中,大量高频决策本质上只是有限状态机的流转。它们只需要一个二值判定,或者一个固定集合内的枚举选择。
LangChain 在 2026 年 9 月披露的一项架构实践,提供了一个对应的工程案例。他们尝试将 TypeSafe 推出的 Jev 模型(即所谓的 System One 模型)接入 Agent 的中间件与控制回路。这类模型与通用大模型有本质不同,它不生成自然语言文本,只接收当前程序状态和预设的类型化问题,直接输出枚举值、评分或布尔概率。由于不采用逐标记的自回归输出,系统还能在单次请求中并行评估同一个状态下的多个问题。
厂商将这类结构化决策模型定位为软件内的快速判断组件。由于缺乏独立多方实测基准,厂商的速度或成本主张只能作为厂商口径,不能直接外推。状态检查、路由分发和高危动作拦截不必默认进入自然语言生成路径;实际收益仍要在目标任务上分别测量延迟、准确率和误判代价。
未知输入的回退边界
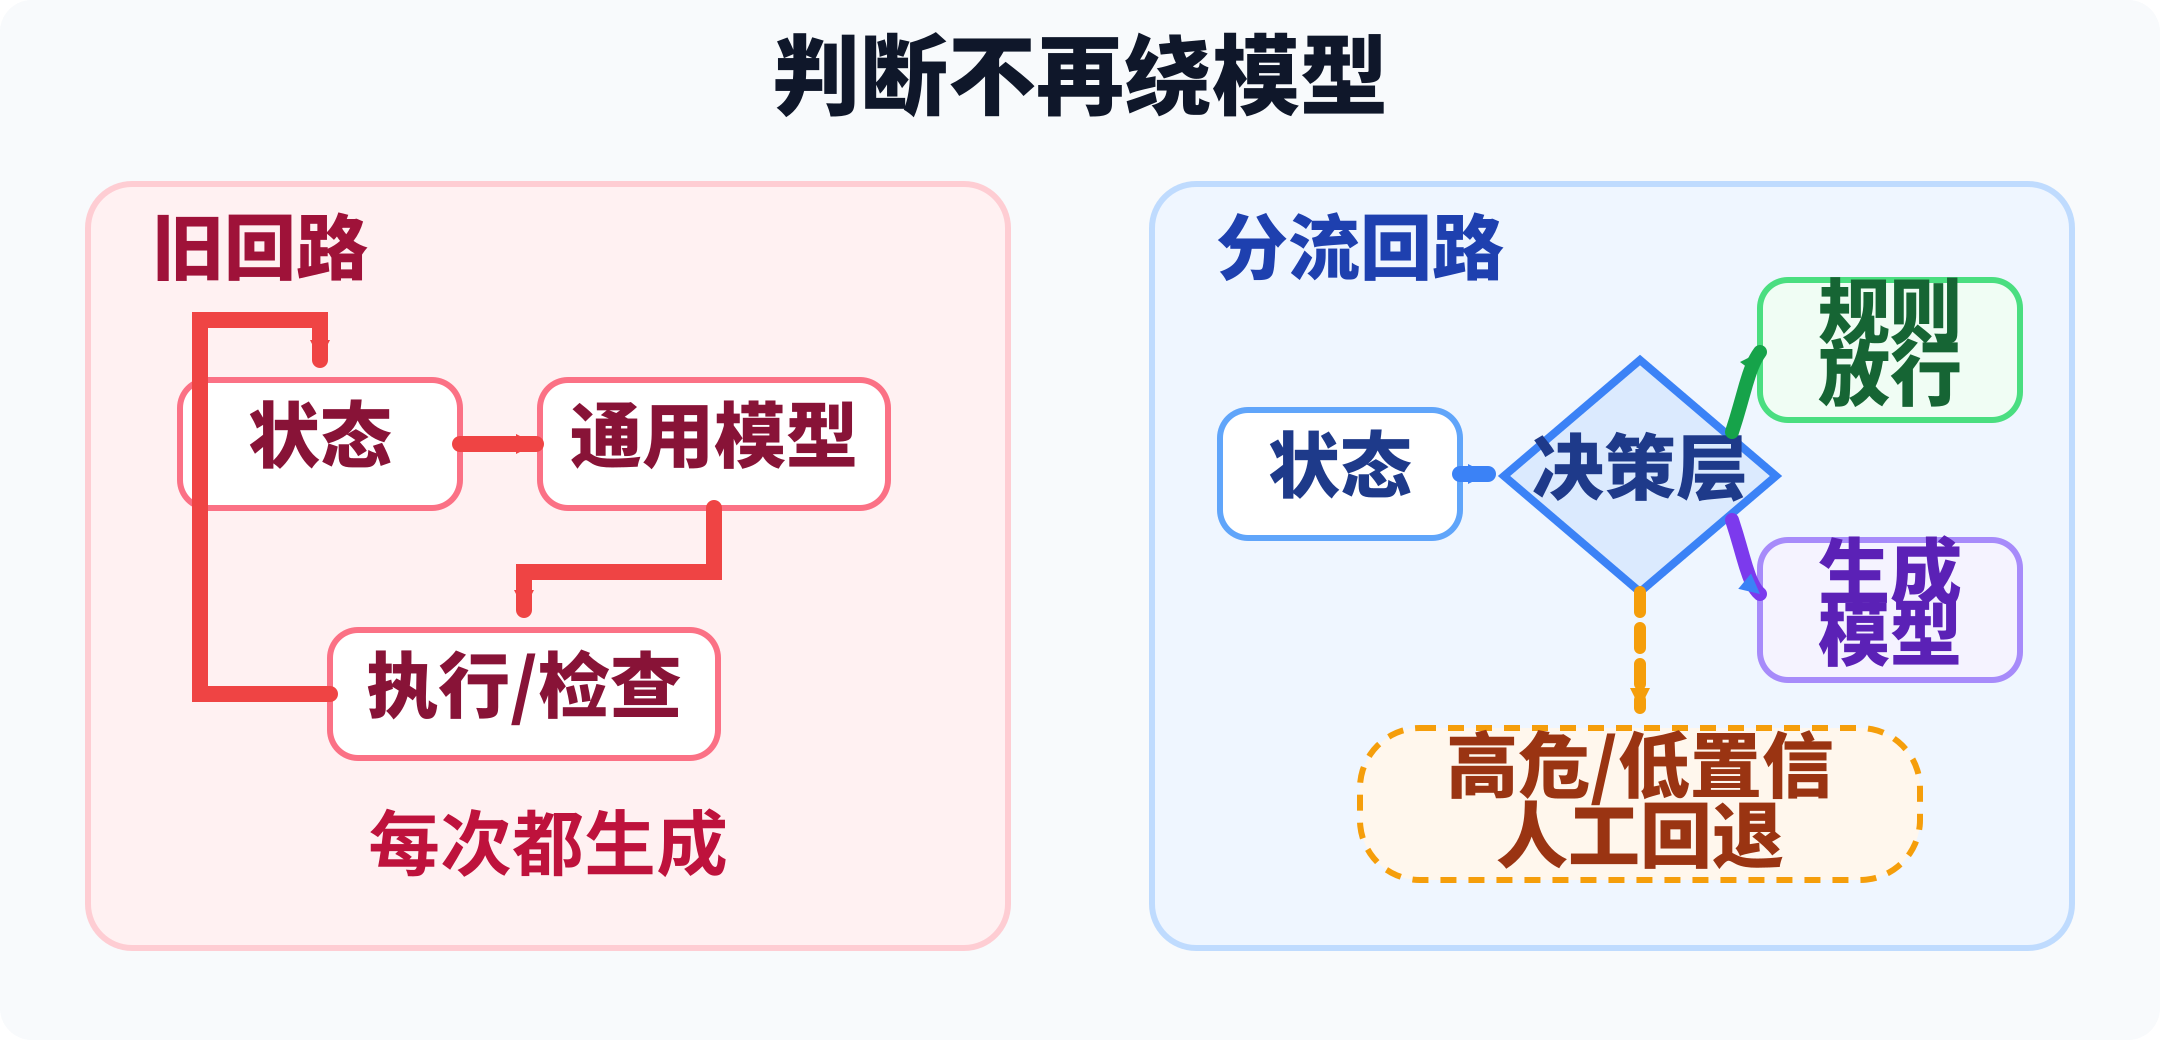
优化 Agent 循环的关键在于,让动作前检查先分流。规则直接决定可验证的硬约束,轻量决策层处理有样本覆盖的结构化判断,通用模型或人工处理开放、高危和未知问题。
在实际工程中,分水岭不在输出是布尔还是枚举,而在于是否存在可验证的判定依据、代表性样本,以及可接受的误判代价。有限输出空间只是接口特征,不代表任务本身简单。
假定开发者是当前工作区的授权人,请求编码助手清理本次构建产物;执行器只拥有该工作区的写权限。Agent 读取到工作目录为 /repo,目标解析为 /repo/build,目录属于可重建产物,命令不含 ..、绝对根路径或外发管道,于是规则返回放行,执行器删除 ./build。若目标解析到 /、工作区之外,或命令包含 curl | sh,规则返回阻断,执行器不执行;若路径可解析但目录性质不在样本覆盖范围,轻量决策层只提供辅助分数,低置信或高风险结果转人工。这个假设示例只说明策略边界,不是生产事故复盘;真实放行还依赖规范化路径解析、工作目录、符号链接处理和权限隔离。类似的模型路由、单测失败类型初筛、偏离目标的快速重试控制,都可以沿用这条边界。
但这种方法存在严谨的工程边界,不能直接套用。一个不可照搬的典型案例,是复杂重构后的代码语义等价性裁决。表面上看,“这段改动是否破坏了原有系统的业务契约”也是一个是非题,但它的判定极度依赖对跨文件调用图、隐式依赖和业务边界的深层推导。这个场景需要跨文件证据与验证,不能仅凭分类概率确认语义等价;遇到未覆盖的代码分布时,高置信度也可能对应错误结论。
因此,健壮的工程回路必须有清晰的回退机制。置信度高也可能因分布漂移而误判,回退条件不能只看一个分数。遇到高危动作、未覆盖输入或置信度处于模糊区间时,系统应停止执行并进入人工审批或补充验证;必要时再将上下文提升至通用强模型进行全量推演。
在高频、规则可覆盖的状态检查中,先测量去掉一次生成调用后的延迟与误判代价。根本不需要生成的步骤,不应调用大模型。大模型可以专心推导架构和编写复杂代码,状态检查、路由和拦截则由规则、轻量决策层与人工回退共同承担。