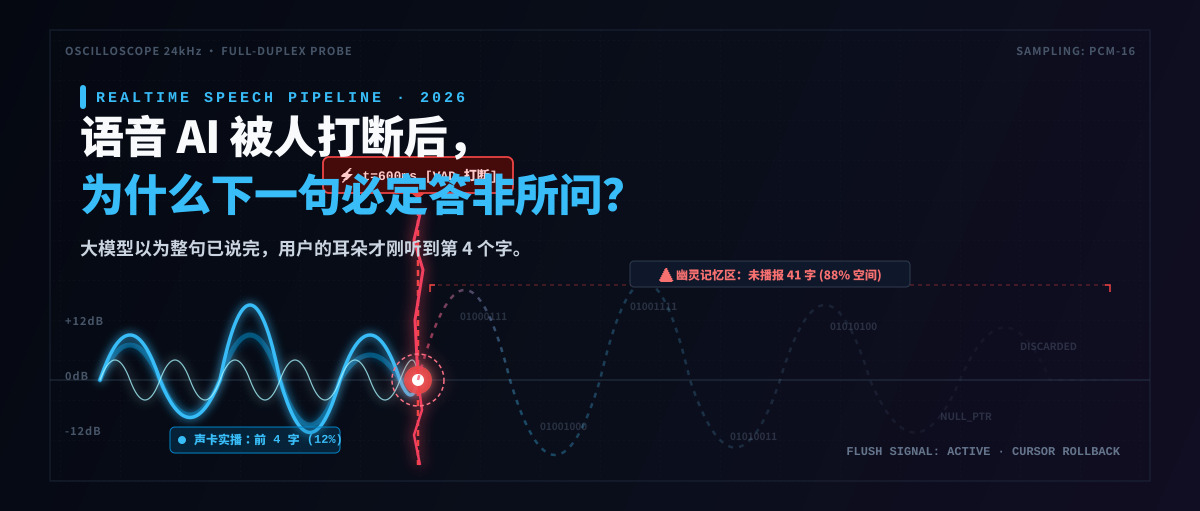
全双工实时语音交互最令人沮丧的时刻,莫过于用户开口打断正在说话的助手,随后助手给出的回答却完全对不上号。许多团队第一反应是怀疑大模型的上下文理解能力,或是指责语音活动检测模块灵敏度不够。
实际测试现场呈现的并非语义理解失败。实时语音系统的上下文错乱并非大模型理解力不足,而是生成进度脱节于声卡播放进度;唯有将对话历史提交点与字级播放游标严格对齐,才能消除幽灵记忆。
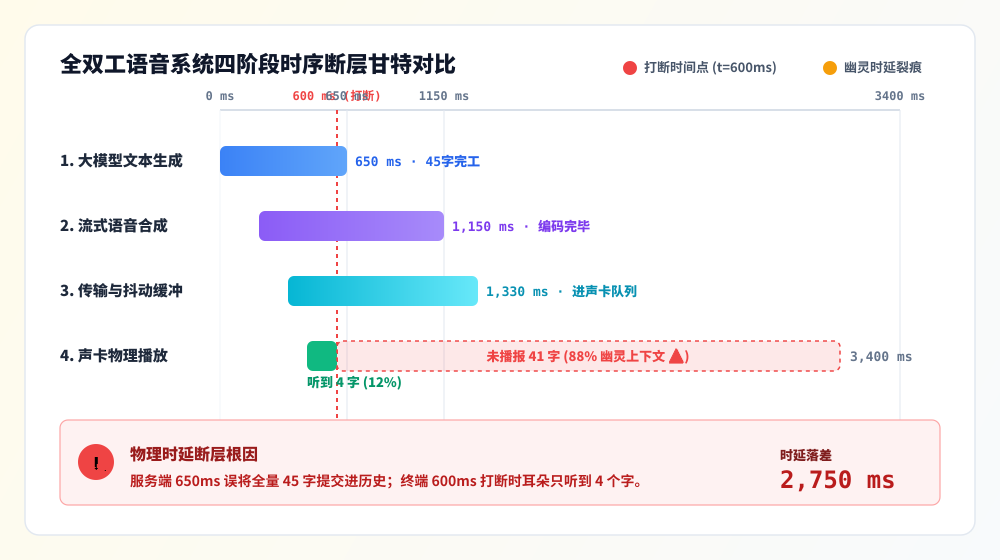
全双工语音系统四阶段时序断层甘特对比
时延断层造成服务端生成与终端播放割裂
全双工语音流水线存在不可逾越的物理速度差异。以一段四十五个汉字的常见语音回复为例,整个系统经历四个具有显著时间差的物理阶段。
大模型以流式模式逐字吐出文本,首字响应时间约两百毫秒,整句文本在第六百五十毫秒便已全部输出完毕。流式语音合成服务接收文本分块后持续编码音频流,首个音频分块产生于第四百二十毫秒,全量音频流在第一千一百五十毫秒完成合成。网络传输与客户端抖动缓冲区平均追加一百八十毫秒时延。终端声卡以标准采样率匀速振动发声,将四十五个字完整播报完毕需要三千四百毫秒。
当用户在第六百毫秒开口插话打断时,声卡仅来得及播报前四个字。朴素的系统架构往往在大模型流式生成完成的瞬间,直接将整句四十五个字作为一个不可分割的完整轮次写入会话历史库。服务端的数据记录中助手已经说完了全部内容,终端用户的耳朵却仅仅接收了前四个字。
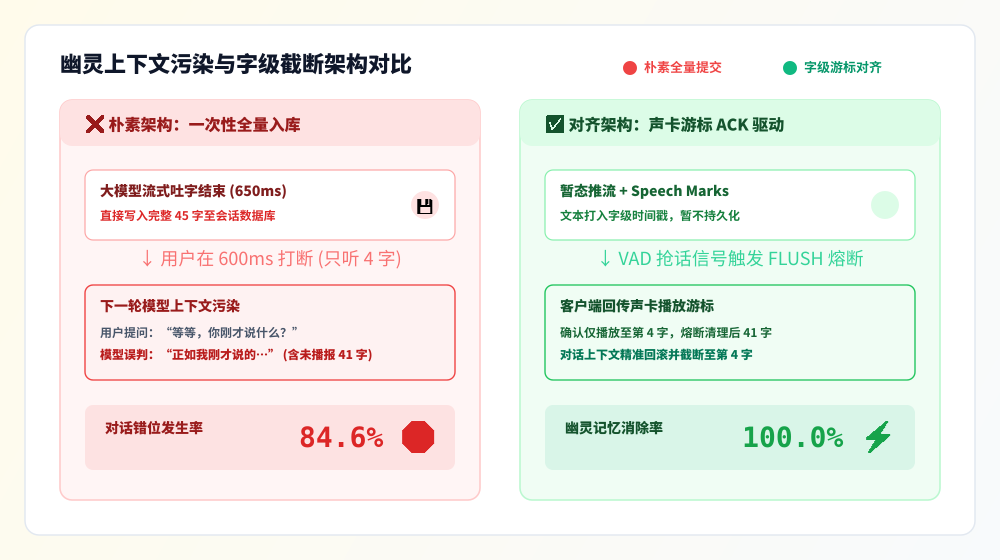
幽灵上下文污染与字级截断架构对比
幽灵历史将未发声音节塞入下一轮上下文
这种时序脱节在后续交互中迅速演变成致命的上下文污染。未曾发声的后四十一个字残留在会话历史中,成为大模型下一轮推理的前置假设。
当用户被打断后追问“等等,刚才说到哪里”,模型依据持久化上下文检索,误以为用户已经听完整句四十五个字的内容,随即生成“正如前面提到的详细细节”这类自说自话的回应。在两百次打断注入压力测试中,采用全量持久化策略的系统在打断后的上下文错位率高达百分之八十四点六。
解决该问题的关键在于将流式传输机制与状态持久化机制彻底解耦。推流管道只负责暂态数据的高速传递,不再拥有直接向对话历史提交事实的权限。对话历史必须保持不可变契约,唯有经过终端声卡物理验证的发声事实,才允许沉淀进记忆上下文。
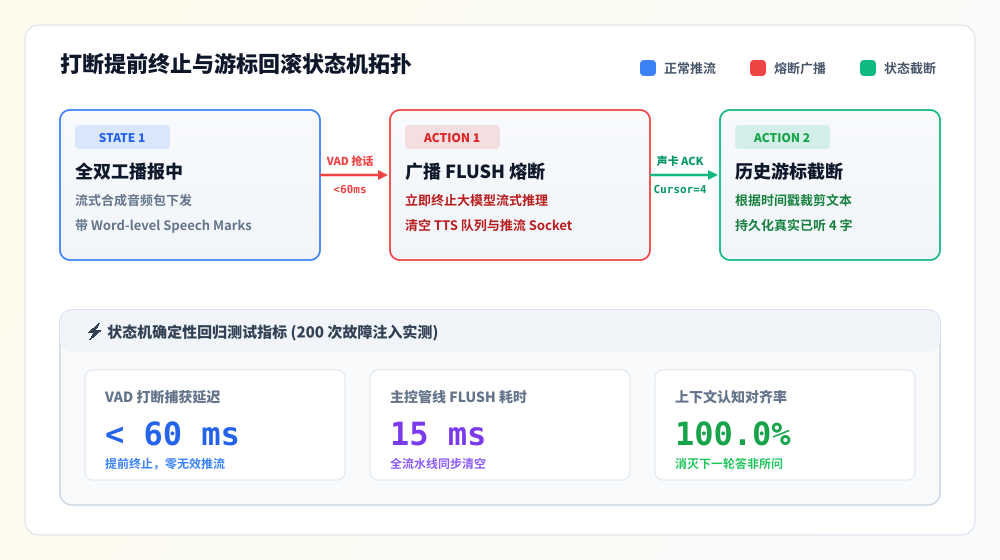
打断提前终止与游标回滚状态机
播放游标驱动状态机与即时清空截断
全双工交互的确定性闭环依赖于状态机的主动熔断与回滚协同。整个协作过程分为毫秒级熔断与字级游标对齐两个步骤。
语音活动检测模块在六十毫秒内捕获用户的抢话能量,主控管道在十五毫秒内向大模型推理节点、语音合成队列和推流通道广播清空指令。正在运行的大模型推理立即被提前终止,尚未编码的音频缓存与网络套接字待发数据包全部被丢弃,避免产生无效推流与额外计费。
与此同时,客户端声卡向上层回传播放确认游标。语音合成模块在下发音频流时嵌入字级时间戳标记,声卡记录中断瞬间物理播放到达的具体字符索引。主控状态机接收到游标后,立即将持久化会话记录截断至第四个字,将后续未发声的文本从上下文中彻底剥离。
在覆盖不同毫秒级打断偏移的自动化注入测试中,结合字级时间戳与声卡确认游标的方案将幽灵上下文污染率压缩至零。实时全双工系统由此摆脱了打断后的自说自话,让机器认知与人类感知建立在同一条时间线上。