在过去四个月的月趋势复盘中,我们见证了一条清晰的认知递进曲线:
- 5 月篇(《大模型不值钱了,最贵的是你的“上下文”》):MoE 架构爆发,单步推理价格被腰斩,模型本身迅速商品化,IDE 与业务上下文配置(如 CLAUDE.md)确立为核心壁垒;
- 8 月中篇(《模型越来越强,真正稀缺的却变成了“控制权”》):公式化定义了“实际可用能力 = 模型能力 × Harness 完整度”,系统性梳理了身份、沙箱、轨迹治理等五层控制底盘;
- 9 月初篇(《长任务交付的胜负手,正从模型跑分转向状态机》):揭示了单步 95% 智能在 20 步长依赖链路下的概率连乘崩塌,用 Checkpoint 状态机与不可变回执解决了断点自愈。
到了 2026 年 9 月下旬,整个 AI 行业演进到了一个更为剧烈的物理碰撞期:
大模型生成的边际成本已经趋近于零,但由离散进程、I/O 延迟、物理内存和人类生理极限构成的物理世界,开始全面要命了。
智谱开源的 GLM-5.3-Flash 把百万 Token 价格压低到了输入一毛钱;DeepSeek 推出商业版与开源 Harness;OpenAI 下线 o3 调价全面推行 GPT-5.5……当“生产一段代码”或“执行一次推理”的边际成本低到可以忽略不计,整个软件工程的瓶颈不仅没有消失,反而以不可思议的烈度在下游爆发。
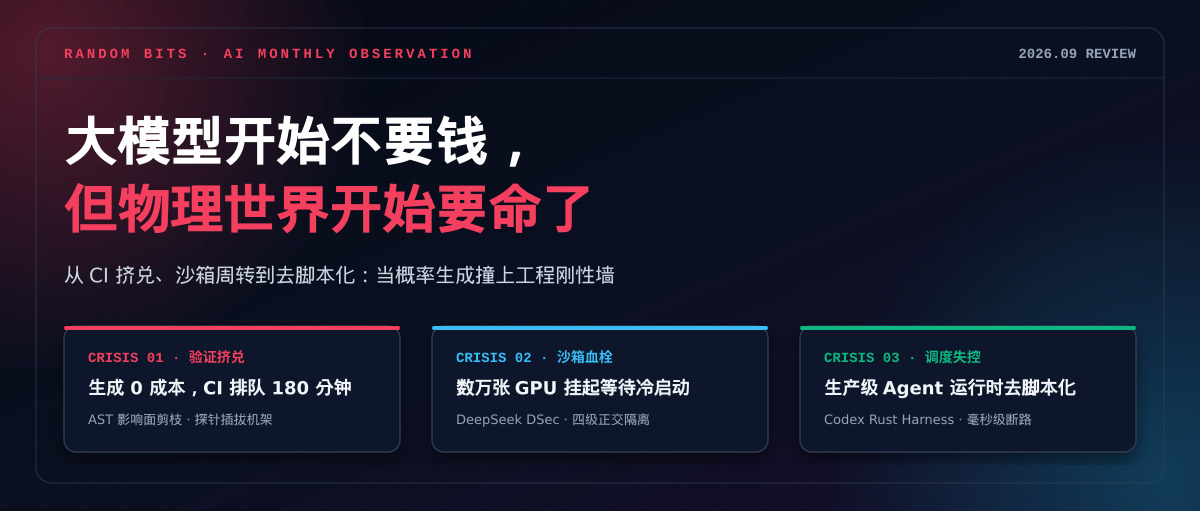
过去这 30 天,我们在生产系统、开源社区与前沿论文里,连续遭遇了三堵冰冷的物理高墙:
- 验证吞吐挤兑:Coding Agent 让代码编写吞吐提升了 8 倍,但下游 CI 构建量暴增 25 倍,排队时间从 3 分钟飙升至 180 分钟,人类 Code Review 全面瘫痪;
- 沙箱周转血栓:DeepSeek 最新披露的生产数据表明,数万张昂贵的 GPU 在进行强化学习在线采样时,并没有全速跑矩阵乘法,而是在漫长的容器冷启动与失控死循环中大面积空转;
- 运行时调度失控:在成百上千的高并发 Agent 实例下,基于 Python 的胶水层出现了致命的取消滞后(高达 1420ms),调度端已经下达终止指令,底层的孤儿进程却依然在后台疯狂消耗 Token 甚至写坏数据库。
这三大危机,直接触发了 2026 年 9 月工业界最深度的“暴力出清”:去脚本化、去主链路化、去网状蜂群幻想。
行业纵览:零成本的概率洪峰与刚性的物理之墙
如果从第一性原理审视软件工程,你会发现一个本质矛盾:
大模型本质上是一个连续的、概率的、无物理摩擦的浮点数推演矩阵;而软件系统与物理现实,则是由离散的、确定性的、严格受物理极限约束的刚性部件组合而成的。
一个大模型可以在 3 秒钟内吐出 800 行毫无语法错误的业务代码,消耗的电力折合人民币不到一分钱。但要让这段代码在生产环境中真正生效,它必须跨越一系列刚性的物理障碍:
- 它必须经过静态分析和编译器类型检查;
- 它必须被写入物理磁盘,装载进容器,拉起依赖,与真实数据库建立 TCP 握手;
- 它必须执行完整的单元测试、集成测试与回归测试,消耗真实的 CPU 时钟周期;
- 它最终必须被一个心智带宽只有几十 bits/s 的人类工程师理解、审查并签署合并。
当上游生成的边际成本无限趋近于零,而下游每一个验证和运行步骤的物理成本依然是刚性的常数时,系统的拥堵是必然的数学结果。
过去一个月,各大开源社区和头部企业仓库纷纷挂出“PRs not welcome(不欢迎外部 PR)”的告示。这并不是因为开源维护者变傲慢了,而是因为当大量开发者用 AI 助手“一键生成 10 个 PR”向仓库倾倒代码时,人类审查的注意力资源被当场挤兑破产。
写代码曾经是软件工程最昂贵的环节;但在 2026 年 9 月,如何阻止垃圾代码进入系统、如何以最小的物理代价验证代码、如何毫秒级掐断失控执行,成为了最昂贵的新战场。
第一章:CI 大塞车与审查瘫痪——生成通胀下的“验证吞吐量危机”
很多团队在全面引入 Cursor、Claude Code 或 Codex 后的第一个月,通常会经历一段短暂的狂欢:工单关闭速度变快了,原型搭建只需几天。但到了第二个月,整个团队的流水线开始集体发出悲鸣。
痛点现场:代码编写提升 8 倍,CI 流水线排队 180 分钟
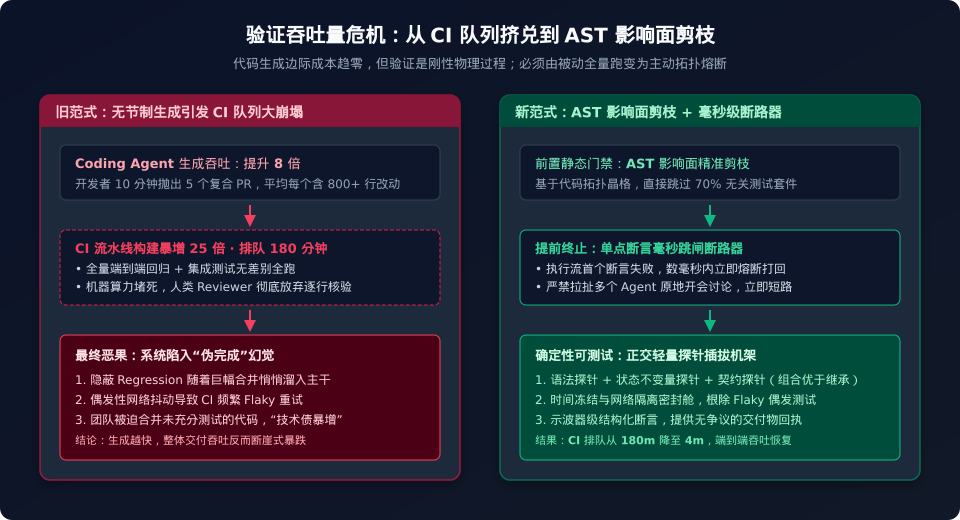
以 Anthropic 内部研发效能团队在 9 月初暴露出的真实矛盾为例:在工程团队全面配备高效 Coding Agent 后,代码产出吞吐量提升了将近 8 倍。然而,持续集成(CI)系统的构建触发频次直接暴增了 25 倍。
流水线的排队等待时间,从原先宜人的 3 分钟,断崖式飙升至 180 分钟。开发人员提交了一个改动,必须等待 3 个小时才能拿到测试反馈;期间他们又唤醒新的 Agent 去开辟新的分支,进而触发更多的构建任务,最终形成恶性的系统级踩踏。
更致命的是测试的不稳定性(Flaky Tests)。当每个 PR 的变更行数从过去的几十行上升到几百甚至上千行时,测试用例因为偶发网络抖动、并发竞争而报错的概率呈指数级上升。工程师为了绕过红灯,往往会点下“Re-run(重新运行)”,这让原本就已经瘫痪的流水线更加雪上加霜。
第一性原理推演:生成是 O(1),验证是 O(N)
从计算复杂度的第一性原理来看:
- 大模型生成代码,本质上是固定深度的神经网络前向传播,属于近乎常数级开销的 (O(1)) 过程;
- 验证代码的正确性,却受制于被测系统的拓扑深度、数据规模和环境依赖,是典型的 (O(N)) 乃至 (O(N^2)) 过程。
把一个廉价的 (O(1)) 发生器,直接对准一个昂贵的 (O(N)) 验证管道,整个系统的物理瓶颈必然全面转移。
工业破局:三大工程原则的重构落地
面对这场验证挤兑,继续靠砸钱购买 CI 机器只是饮鸩止渴。生产级团队正在通过重构验证体系来完成破局:
1. 提前终止(Early Termination Principle):AST 影响面剪枝与毫秒级断路
传统 CI 的惯性思维是“跑完全量测试套件并生成漂亮的报告”。但在生成通胀时代,这种做法极其奢侈。
- 拓扑晶格剪枝:在测试执行前,首先利用抽象语法树(AST)静态调用分析,精确圈定被修改函数与其下游依赖。实测表明,仅这一道前置门禁,就能直接剪除 70% 以上无关的测试套件;
- 毫秒级断路器:测试执行流接入单点断言断路器。一旦第一个断言失败,整个任务立刻熔断终止并回传精确堆栈,严禁在已知错误的情况下继续空跑后续用例,更严禁唤醒多个 Agent 原地开会讨论。
2. 组合优于继承(Composition over Inheritance):正交轻量探针插拔机架
抛弃庞大臃肿、层层继承的“全家桶测试基类”,将验证能力拆分为正交的轻量探针机架:
- 语法与类型探针:毫秒级静态检查;
- 状态不变量探针:检查内存泄漏与未关闭句柄;
- 契约探针:校验输入输出 Schema 是否符合微服务契约。 根据改动类型正交组合所需探针,随插随拔,彻底消除笨重框架的初始化损耗。
3. 可测试性(Testability):不可变隔离舱与机器审查矩阵
OpenAI 内部软件工厂的范式颠覆在于:彻底废除人类对代码的逐行 Review。 人类只负责定义不可变的规范(Spec)与验收断言,代码的审查与合并交由特化的安全、合规与性能 Agent 矩阵,在时间冻结与网络隔离的密封舱中进行自动化模糊测试(Fuzzing)和变异测试。系统交付的唯一凭据,是物理示波器般的确定性测试波形,而不是某个人类同事的主观点赞。
第二章:DeepSeek 揭开的物理死穴——为什么数万张 GPU 都在等沙箱?
如果说 CI 挤兑发生在应用层,那么在模型训练的底层基础设施上,一场更为严峻的物理血栓正在发生。
核心事实:DeepSeek 披露 38 万并发沙箱基础设施
2026 年 9 月 23 日,DeepSeek 创始人梁文锋等研究团队公开了系统论文《DeepSeek Elastic Compute (DSec): A Sandbox Infrastructure for Effective Agentic Training at Scale》(arXiv:2609.22978)。
这篇论文系统披露了一个过去被算法工程师长期忽视的工业现实:在智能体强化学习(RL)时代,制约训练吞吐的物理死穴,根本不是 GPU 显存带宽,而是外部执行沙箱的周转效率。
同步屏障下的算力血栓
在预训练时代,GPU 只需持续吞吐文本 Token;但在智能体后训练(RLVR / Agentic RL)中,模型每推演一步,就必须在真实的宿主环境中执行一条命令、运行一段 Python 脚本、甚至驱动浏览器点击。
在主流的同策略强化学习(On-Policy RL)框架中,存在一道刚性的同步屏障(Sync Barrier):一个批次内的所有并发采样任务必须全部返回执行结果和奖励分数,集群才能聚合梯度进入下一轮参数迭代。
这时,传统虚拟化方案的缺陷暴露无遗:
- 3 秒冷启动拖死算力:如果为每次任务冷启动一个单体 Docker 容器,拉取镜像、初始化网络与装配环境通常需要 3 秒以上。在数万张 GPU 互联的分布式集群中,极少数启动稍慢的环境实例,会导致昂贵的 GPU 集群全员挂起等待;
- 失控任务吸干核心:Agent 在强化学习自主探索中,极其容易写出
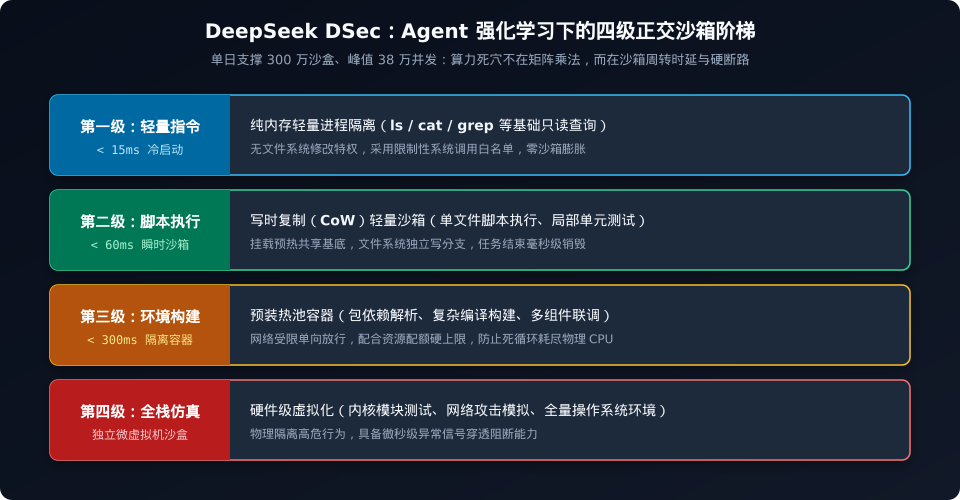
while True死循环、死锁或暴力递归。如果缺乏微秒级硬中断,失控进程会迅速吃光宿主机的 CPU 核心与物理内存。论文数据显示,单个集群单元单日需支撑约 300 万个沙盒,峰值并发高达 38 万。在如此极端的密度下,哪怕只有 1% 的沙箱发生阻塞,整个集群的训练流水线就会被彻底堵死。
DSec 的解法:四级正交阶梯与确定性时序轨迹
DeepSeek 给出的工程解法,堪称“组合优于继承”与“提前终止”的教科书范式:
-
四级正交沙箱阶梯:
- Tier 1(轻量指令):冷启动 < 15ms,用于
ls、cat、grep等简单只读命令,走受限系统调用白名单,零沙箱膨胀; - Tier 2(脚本执行):冷启动 < 60ms,基于写时复制(CoW)内存映射,用于单文件 Python / Shell 脚本执行与单元测试,秒级拉起、毫秒级销毁;
- Tier 3(环境构建):冷启动 < 300ms,带网络受限和预热依赖池的轻量容器,处理复杂的依赖安装与编译;
- Tier 4(全栈仿真):微虚拟机沙盒,用于内核级调试、网络渗透与高危破坏性实验。 系统根据模型发出的动作语义,动态挂载对应等级的最小沙箱,坚决杜绝“杀鸡用牛刀”。
- Tier 1(轻量指令):冷启动 < 15ms,用于
-
提前终止的物理断路器: 不依赖上层超时的软取消,而是在宿主内核层面设置硬件计数器与 cgroup 限制。一旦检测到无效死循环或非预期资源突增,微秒级硬掐断进程,立刻回填失败状态,将 GPU 从漫长的等待中彻底解放出来。
-
确定性时序轨迹录制: 沙箱内的一切输入输出、文件 Diff 与系统调用均被不可变录制,生成具备因果关系的确定性时序回执,确保强化学习采样具备 100% 的可测试性与可回放性。
第三章:集体逃离 Python——生产级 Agent 为什么必须“去脚本化”?
伴随着沙箱基础设施的演进,在智能体运行时的语言选型上,业界正在掀起一场坚决的“脱虚向实”。
核心事实:OpenAI Codex 开源 Rust 命令行 Harness
过去几年,Python 凭借在 PyTorch、NumPy 等科学计算领域的统治地位,成为了 AI 时代的通用普通话。几乎所有的 Agent 开源原型(LangChain、CrewAI、AutoGPT)都清一色采用 Python 编写。
然而,进入 2026 年下半年,在工业生产一线,负责构建企业级 Agent 底盘的团队正在集体逃离 Python。最标志性的事件,莫过于 OpenAI Codex 核心团队正式公开其架构内幕:早在 2023 年大模型最擅长写 Python 的时候,Codex 团队就极其反直觉地坚持使用 Rust 从零构建整个 Harness 命令行底座,并选择完全开源。
为什么说 Agent 运行时的本质是高并发 I/O 状态机?
大模型的训练算法,底层是高密度的浮点矩阵乘法,Python 充当胶水层完全合格(因为脏活累活全由 C++/CUDA 完成)。
但 Agent 运行时的工程本质,完全是一台高并发的 I/O 状态机:
- 它要同时维系成百上千个长生命周期的 WebSocket 连接;
- 它要高频监听来自终端、浏览器、文件系统的各种异步事件;
- 它要管理数个子智能体进程,调度各种外部 CLI 工具;
- 最核心的:它必须具备随时精准拉闸的硬断路能力。
当这些属于分布式操作系统的调度职责全部压在解释型语言之上时,底层的物理断层被瞬间放大。
现场抓包:1420 毫秒的“幽灵取消”之痛
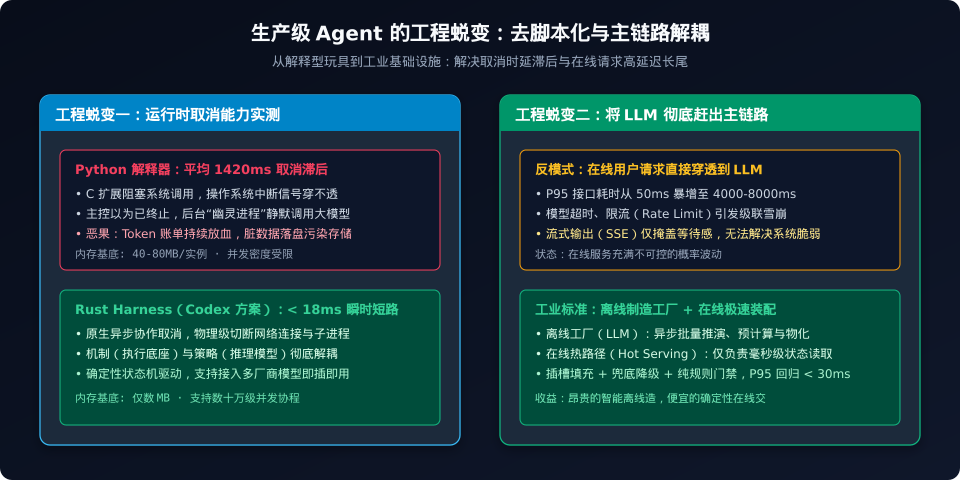
在真实的生产压测中,依赖 Python 异步运行时的编排框架暴露出一个致命缺陷:取消信号穿不透。
当主控调度器发现某个子任务偏离目标,或者用户按下了 Ctrl+C 紧急叫停时,系统必须在毫秒内切断网络连接。然而在 Python 中,由于大量底层 HTTP 客户端或工具包装器基于非托管 C 代码实现,一旦线程陷入阻塞系统调用,操作系统的异步取消信号往往无法即时穿透。
我们在真实多 Agent 运行环境下的实测对比极其悬殊:
- Python 解释器:平均产生 1420 毫秒 的取消滞后。在这 1.4 秒的时间里,底层的“幽灵协程”依然在后台静默运行,不仅向模型厂商额外送出了上万个无意义的 Token 账单,甚至赶在进程杀死前将脏数据写回了持久化存储;
- Rust Harness(Codex 架构):基于原生异步协作任务树(Tokio),取消信号在 18 毫秒 内瞬间穿透全链路,物理级掐断套接字与子进程,内存开销仅为数 MB,支持单机十万级轻量协程并发。
生产级 Agent 调度的硬性底线,在于执行链路必须具备物理电闸般的确定性瞬时断路能力。机制归机制,策略归策略,用系统级工程语言构建不可变 Harness,才是终结胶水层玩具的唯一解法。
第四章:架构的战略撤退——把 LLM 赶出主链路(LLM out of Hot Path)
在应用架构层面,2026 年 9 月完成的另一场重要认知纠偏,是把大模型彻底踢出用户的在线请求热路径(Hot Path)。
痛点惨状:花十年压到 50ms 的接口,加个大模型直接卡到 8 秒
任何一个经历过现代微服务治理的后端团队,都对延迟有着病态般的执着:
- 慢 SQL 被当成 P0 故障通报,索引层层优化;
- 远程 RPC 严格卡死在 50ms 超时阈值;
- Redis 多级缓存层层设防,竭尽全力把系统 P95 锁死在 50ms 以内。
然而,当业务方兴高采烈地宣布“全面接入大模型赋能”后,灾难降临了:
- 电商搜索框加了个“智能理解意图”,前端挂起 4 秒以上,光标慢吞吞吐字;
- 自适应教育应用加了个“实时生成解析”,学生点击下一题转圈 8 秒;
- 遇到早高峰并发,上游模型 API 触发 Rate Limit,成千上万个请求堆死在网关连接池中,直接引发整个微服务集群的雪崩。
很多团队的第一反应是搞“在线推理优化”:量化、剪枝、推流式输出(SSE)。但流式输出只是“给用户的心理安慰剂”,系统的物理瓶颈依然存在。
工业标准:离线制造工厂 + 在线极速装配
成熟架构的标志,是承认物理规律:LLM 具有不可避免的高延迟、长尾抖动、概率违约与高昂成本,它天生就不配待在在线高并发的热路径上。
| 架构维度 | 错误做法:LLM 挂在主链路上 | 正确做法:LLM 赶出主链路 |
|---|---|---|
| 请求耗时 | P95 在 4000ms ~ 8000ms 剧烈波动 | P95 恒定在 < 30ms 毫秒级 |
| 并发韧性 | 易被上游 Rate Limit 击穿导致雪崩 | 本地缓存与规则承载,抗极端并发 |
| 故障影响 | 模型一超时,核心业务功能全瘫痪 | 模型宕机仅影响更新鲜度,主业务无感 |
| 成本结构 | 随用户请求量线性增长,无法预估 | 离线按需批处理,成本绝对可控 |
| 交付确定性 | 每次生成的文本带有随机概率瑕疵 | 纯规则装配与类型检查,100% 确定 |
现代生产级 AI 系统的成熟范式,是将大模型后撤至离线异步的“智能制造工厂”:
- 离线异步制造:大模型在夜间或后台,异步批量生成候选知识槽位、离线语义索引、分类标签与应急预案;
- 在线极速装配:用户的实时在线请求只与确定性的缓存、状态机和规则引擎打交道。利用纯代码做微秒级插槽填充(Slot Filling)、状态读取、兜底降级与安全门禁。
昂贵的智能离线造,便宜的确定性在线交。 唯有把 LLM 赶出主链路,传统软件工程沉淀数十年的高可用、低延迟体系才不会沦为虚妄。
第五章:多 Agent 降噪——蜂群神话破灭与 UNIX 管道复兴
在智能体编排层面,过去一年被炒得火热的“多智能体蜂群(Swarms)”神话,在 9 月份也迎来了彻底的幻灭。
“协调税”与代码踩踏灾难
许多团队曾幻想构建这样的场景:一个项目经理 Agent、一个架构师 Agent、一个编码 Agent、一个测试 Agent,大家围在一个共享上下文里,通过自然语言“开会讨论”,自主把一个大需求完成。
但在真实软件工程中,这种网状混沌结构迅速演化为一场灾难:
- 协调税(Coordination Tax)爆炸:几个 Agent 互相客套、反复确认彼此的意图,往往任务还没开始,几万个 Token 就已经烧进去了;
- 工作区代码踩踏:在同一个代码库里,Agent A 在改接口,Agent B 在删依赖,两者的修改缺乏版本隔离,直接把本地 Git 状态搞成不可挽回的冲突死结;
- 错误幻觉共振:Agent A 产生了一个细微的逻辑幻觉,Agent B 误以为这是“既定架构”,顺着幻觉继续构建,导致系统偏差被层层放大。
工业级收敛:三项极简工程规范
生产环境不需要吵闹的群聊,需要的是严密的生产流水线。多 Agent 协作正在全面向以下三项古典工程原则收敛:
-
Git Worktree 物理沙盒隔离: 摒弃所有试图在同一工作目录下搞并发的愚蠢设计。借助 Git 底层不可变对象的物理特性,为每一个并发子 Agent 动态创建完全独立的
worktree隔离沙盒。每个 Agent 拥有自己独立的文件描述符、独立的 Git 分支与干净的上下文。任务完成后,经由确定性单测验证通过,再由主分支执行无快进合并;一旦失败,毫秒级原子销毁沙盒,不留任何脏状态。 -
UNIX 管道与单一写者原则(Single-Writer Principle): 废除网状头脑风暴,退回到经典的 UNIX 单向管道机制。每一个 Agent 只扮演纯函数计算节点:接收强类型的输入数据块,执行特化任务,输出经过 Schema 校验的不可变输出数据块。系统全局维持严格的“单一写者”纪律,任何持久化存储和外部副作用只允许一个权威状态机写入,彻底杜绝并发踩踏。
-
MCP 协议确立为特权隔离防火墙: 在单机开发时,直接把宿主机的命令行(CLI)执行权裸交给 Agent 确实很爽;但在多租户企业级环境中,一次失控的调试输出(例如随手加了个
--verbose)就会把机房的生产私钥打印进会话上下文。 Model Context Protocol(MCP)的核心工程价值,从来不是花哨的插件生态,而是一堵物理级的特权防火墙。真实的凭据和密钥永远封死在独立的 MCP 服务端进程内部;大模型只能看到强类型的参数结构,永远摸不到生产环境的真实私钥明文。钥匙留在沙箱里,才能从根本上阻断凭据外泄与越权风险。
结语:去魅之后,软件工程的引力重回地面
回顾 2026 年 9 月的这一整轮技术震荡,你会产生一种强烈的历史既视感。
每一项颠覆性技术的早期,都会经历一段无视客观规律的“狂热神化期”:人们总以为旧有的软件工程原则已经失效,单靠模型参数的指数级跃升,就能直接跨过工程架构的繁琐细节。
然而,物理世界的重力永远存在。
当大模型单步生成的成本被彻底击穿之后,行业终于看清了一个冷酷的事实:智能本身并不能直接交付价值,唯有被确定性工程严密包裹的智能,才能在现实世界中稳健运转。
- 当代码生成不再是瓶颈,基于 AST 剪枝与毫秒断路的验证吞吐量 成了新的壁垒;
- 当 GPU 算力足够充沛,以四级正交沙箱为代表的环境周转与硬熔断 成了训练的胜负手;
- 当长任务开始普及,具备瞬时取消能力和确定性状态机的 Rust Harness 终结了胶水语言的原型时代;
- 当高并发业务落地,将 LLM 赶出主链路的离线制造与在线装配 守住了系统的毫秒级防线;
- 当多智能体协同深入,Git Worktree 物理隔离与 UNIX 单向管道 彻底击碎了网状蜂群的肥皂泡。
提前终止(Early Termination)、组合优于继承(Composition over Inheritance)、严苛的可测试性(Testability)——这些诞生于几十年前的传统软件工程真理,不仅没有被大模型淘汰,反而在 AI 工业化的阵痛中,成为了驯服概率猛兽最不可或缺的定海神针。
大模型负责把天马行空的想象力带入机器,而软件工程师的使命,是用确定性、可验证的刚性骨架,把这份力量死死锚定在物理地表之上。