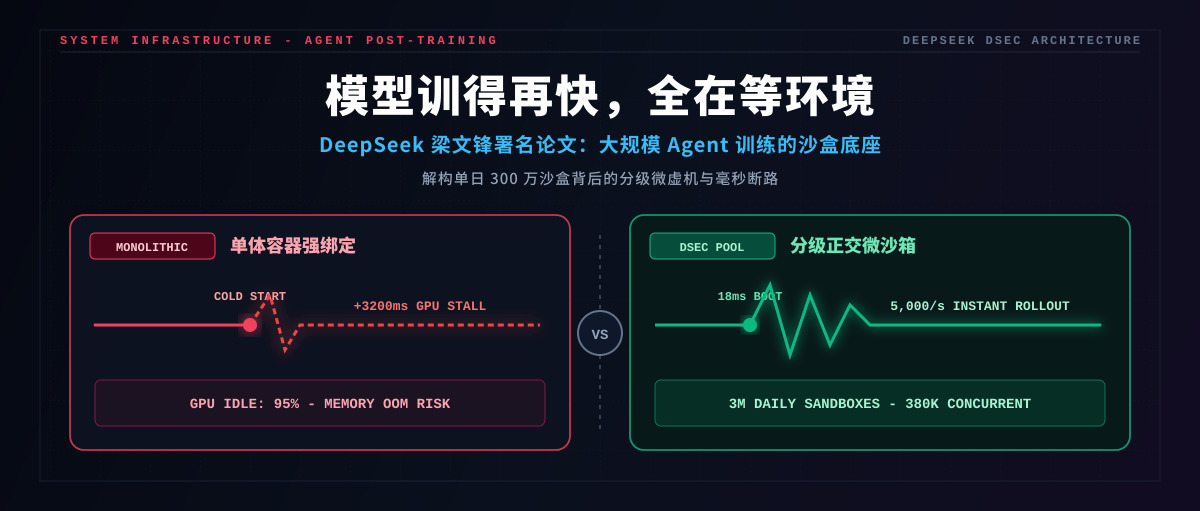
训练大模型写代码,和教它背书完全不同。模型不仅要想出答案,还要在真实系统里动手执行。它每写出一行代码,都要丢到宿主环境里跑一次。系统需要验证代码能否运行,并立刻返回输出结果。如果启动一个运行环境需要几秒钟,整个流程就会直接卡住。此时制约训练速度的瓶颈,根本不在模型算得快不快。真正的阻碍,卡在外部沙箱的环境启动与调度开销上。
2026 年 9 月 23 日,DeepSeek 创始人梁文锋等团队公开了系统论文《DeepSeek Elastic Compute (DSec): A Sandbox Infrastructure for Effective Agentic Training at Scale》(arXiv:2609.22978)。这篇论文披露了支撑智能体后训练的沙箱基础设施 DSec。在大规模强化学习中,智能体演变成了一台高频交互的状态机。它整日都在调用外部工具、编译代码和执行系统命令。训练集群的设计重心,也因此发生了深刻转移。工程团队不仅要堆叠算力,更要解决数以万计沙箱的快速周转。
外部代码还没运行,容器初始化先拖垮了集群
智能体强化学习依赖大规模在线采样。在主流的同策略训练流程中,系统存在严格的同步机制。整个计算批次必须收齐所有子任务的反馈结果。只有拿到全部执行输出,算法才能聚合梯度并更新参数。
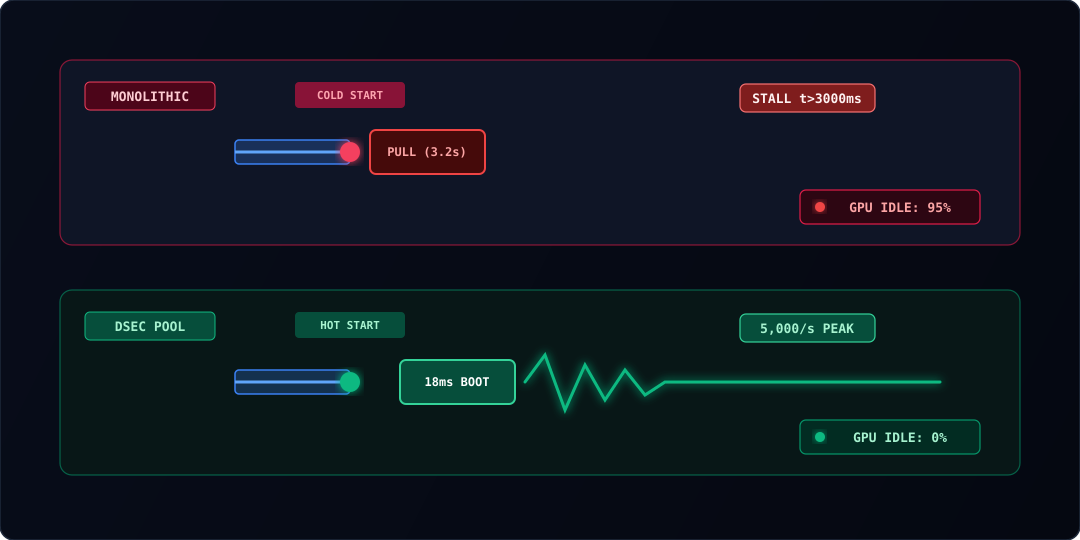
如果每次任务都启动一个完整容器,系统开销会极其沉重。以常见的代码修复任务为例。宿主机器需要拉取镜像层,建立虚拟网络,还要装配语言运行环境。这一套初始化流程走完,单体容器的启动时间往往超过 3 秒。
但这 3 秒钟对计算芯片来说是巨大的浪费。在分布式训练的同步等待下,短板效应被急剧放大。哪怕几千路任务中只有几个容器启动迟缓,整批算力也必须原地干等。昂贵的计算节点无法继续推演,全部堵在等待队列里。
更严重的损耗来自于任务异常。模型在探索编写脚本时,经常写出死循环或高负载代码。如果环境缺乏快速切断机制,失控的脚本就会一直霸占 CPU 与内存。论文披露的数据显示,DeepSeek 单个生产单元每天要跑约 300 万个沙盒。系统峰值并发超过 38 万个,任务密度极高。未被及时掐断的异常调用一旦堆积,调度队列就会彻底瘫痪。
在多路并行的同步采样中,环境启动的时延直接决定了整个计算集群的等待上限。
任务特权按需解耦,轻量沙箱实现毫秒级就位
为了搬开挡在算力前面的物理墙,系统不能用同一种重型容器去硬扛所有任务。工程团队必须拆解环境,按需分配最小特权。
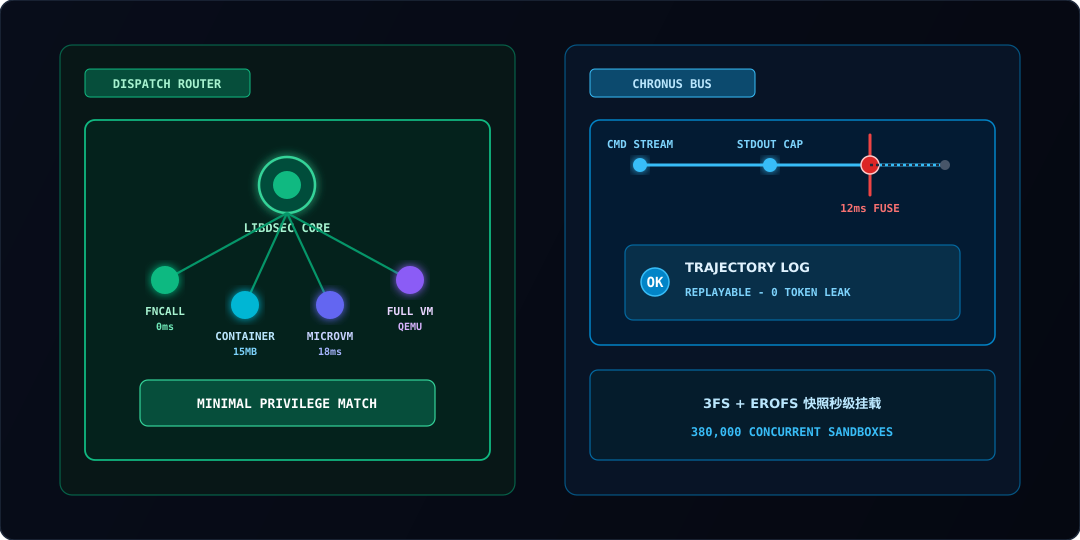
DSec 的破局思路是构建细粒度的四级隔离阶梯。不同复杂度的操作,交给不同量级的运行单元执行:
| 执行层级 | 隔离技术 | 启动时延(典型值) | 内存增量开销 | 适用任务场景 |
|---|---|---|---|---|
| FnCall | 进程内函数执行 | <1ms | 0MB(无额外沙箱) | 无状态数据清洗与格式转换 |
| Container | 容器命名空间隔离 | ~40ms | ~15MB 独立进程 | 依赖明确的标准化脚本测试 |
| MicroVM | Firecracker 轻量虚拟化 | ~18ms | ~18MB 内存快照 | 高并发代码测试与多租户隔离 |
| Full VM | QEMU 全系统虚拟化 | ~120ms | ~80MB 基础镜像 | 涉及内核编译与完整操作系统调用 |
在这个阶梯中,简单的无状态计算直接当作普通函数运行,耗时不到 1 毫秒。对于需要安全隔离的高频代码测试,系统调用轻量微虚机。结合底层分布式存储与写时复制快照,微虚机能在约 18 毫秒内热启动。它的增量内存只有约 18MB,比传统容器轻巧得多。这种解耦让沙箱调度彻底跟上了模型推理的速度。单集群因此扛住了每秒超过 5000 次沙盒创建的高峰冲击。
除了快速启动,生产环境还必须具备毫秒级的中断与审计能力。沙箱内部部署了轻量探针,对所有输入指令与输出内容进行抓包。一旦发现脚本陷入死循环或超时,探针会在 12 毫秒内硬切断进程。系统迅速收回计算核心与内存,不让异常任务持续蔓延。与此同时,Chronus 总线将执行痕迹完整固化,方便离线排查复现。
生产级智能体训练的本质,是用最轻的环境跑代码并对异常执行施加毫秒级熔断。
智能体训练已经走出单纯堆砌算力的单点竞争。当上万张计算芯片都在等待外部反馈时,系统的胜负手就变成了沙箱周转。把环境做轻,把熔断做快,算力才能真正持续流动起来。