月初拉出模型调用账单时,研发负责人的心跳漏了半拍。上周团队刚把线上智能体的默认模型切到名义单价更低的新版本。官方宣称输入输出标价降了五分之四。大家原本预期本月的算力支出能大幅压缩。财务报表上的最终扣费却不仅没有下降,反而直接翻了三倍。工作区里的服务日志没有报错,业务吞吐量也没有明显激增。这笔凭空多出来的昂贵开销,彻底打碎了团队对低价模型的简单幻想。
2026 年 9 月,OpenAI 与 Anthropic 密集调整了模型定价。OpenAI 发布了全新的 GPT-6.1 Sol 模型。官方声称其在编码与电脑操作上接近旗舰主力,标准输入输出标价却只有后者的五分之一。缓存输入更是低至每百万词一角钱。几乎在同一时期,Anthropic 发布了 Claude Sonnet 5.5。官方宣称单项任务成本最多可以降低三成。很多工程师被这些诱人的折扣数字吸引,迅速在主干代码中替换了模型参数。然而一旦进入真实的自动化任务流水线,看似廉价的标价立刻遭遇了残酷的现实反弹。
推理轮次拉长击穿静态标价幻觉
多数人评估大模型成本时,习惯沿用传统无状态接口的思维定式。这种认知基于单次调用的静态假设。单词输入标价便宜八成,任务开销自然跟着打折。然而自主智能体的运行机制彻底颠覆了这个简单的线性公式。
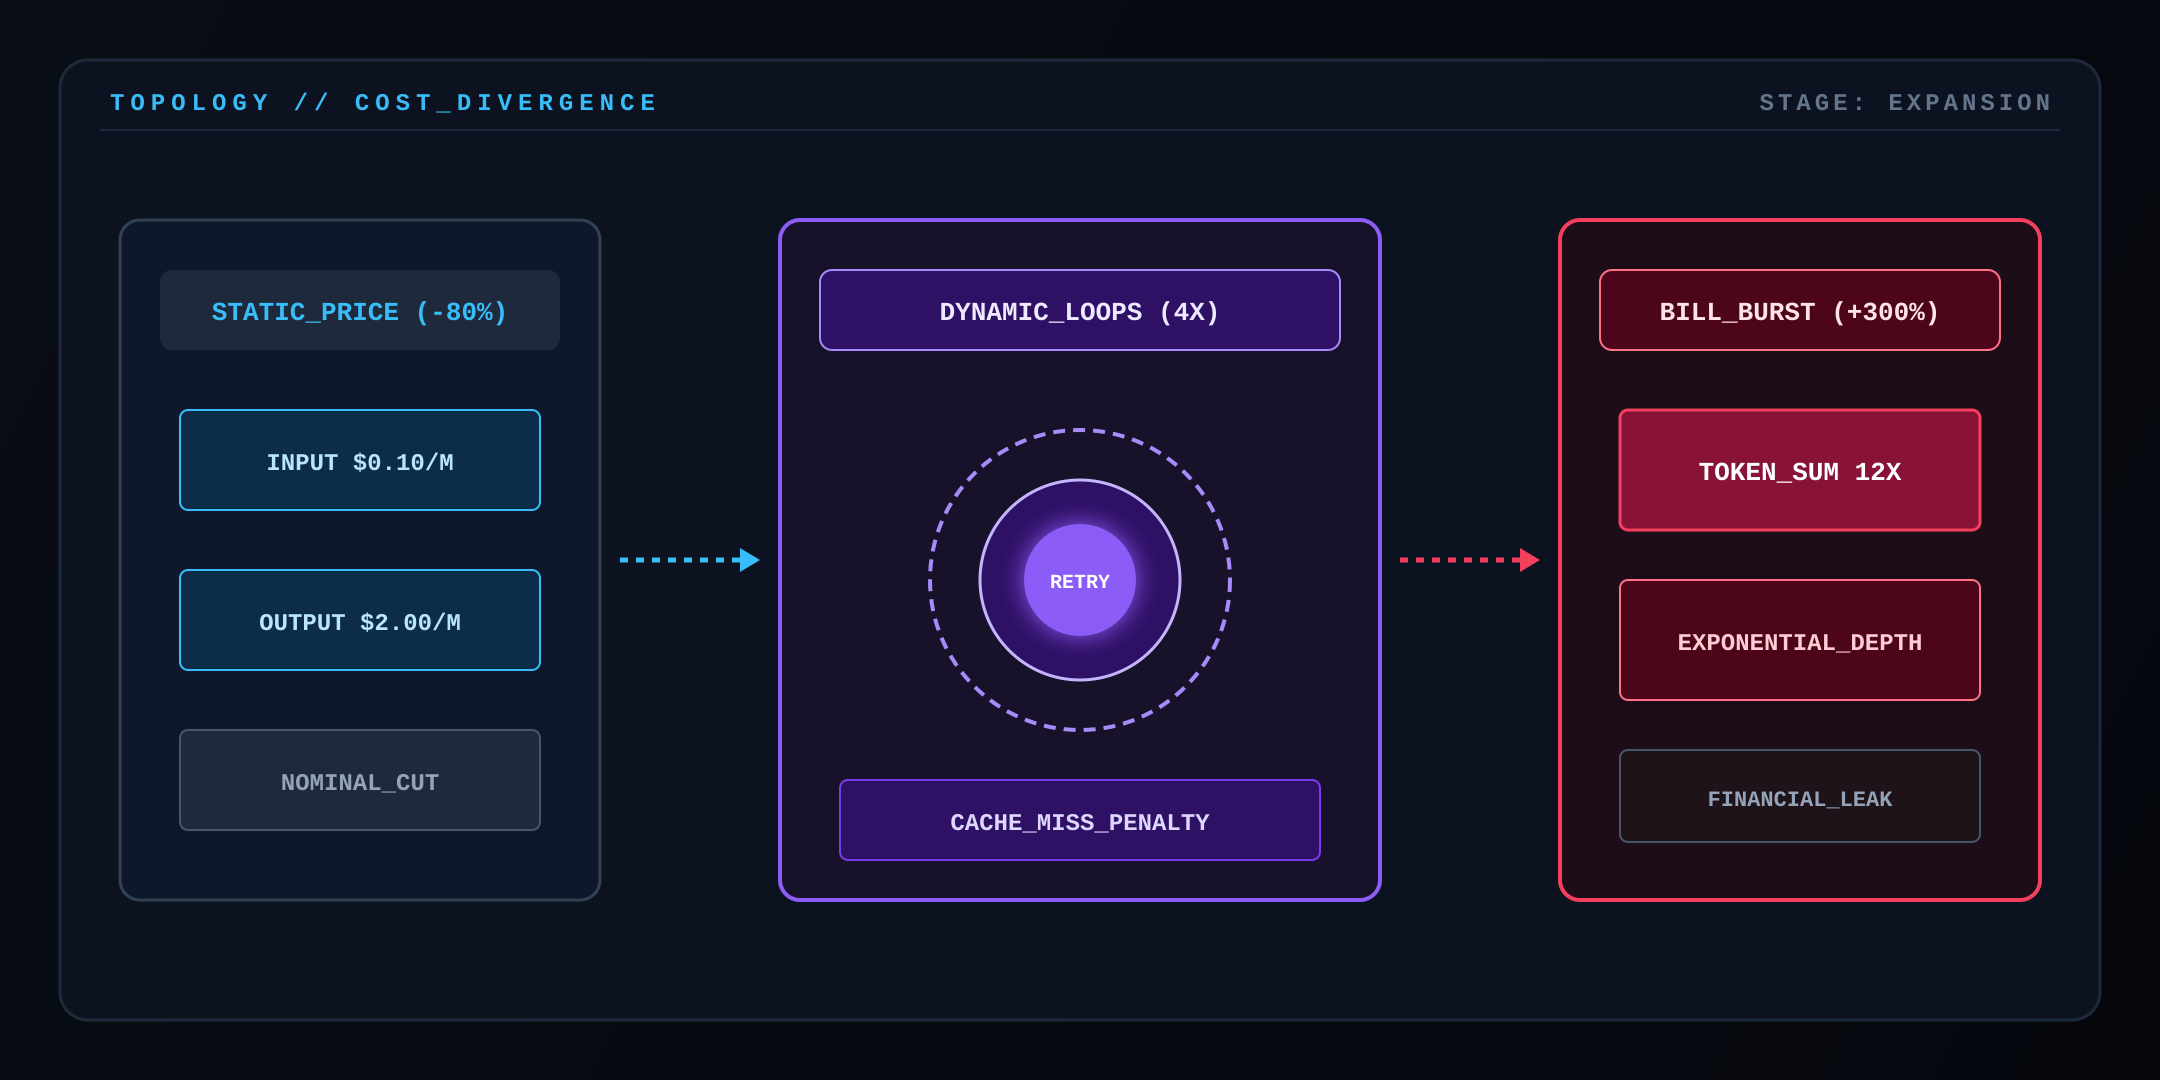
新一代模型在编程基准测试中跑分大幅提升。这种能力的跃升主要依赖推理深度的扩展。模型在面对复杂工程任务时,表现出极强的探索执念。旧版本遇到难以通过的单元测试,通常在调用三轮工具后便直接放弃。新模型却为了寻找正确解法,自发开展十几轮深入排查。它一遍遍读取相关源码文件,反复修改断言并重新触发编译测试。
单次任务消耗的词元总量发生了指数级膨胀。更严重的财务漏洞隐藏在提示词缓存的频繁失效中。长程会话每前进一步,历史记录都在迅速累加。一旦工具在早期轮次输出了动态时间戳或临时日志,后续所有的前缀缓存便全部被破坏击穿。模型每次发起重新推理,宿主都要把膨胀后的海量上下文以全额价格提交给服务端。标价上的轻微让利,在十倍以上的上下文累加面前瞬间蒸发殆尽。
标价降低只代表单次采样的廉价,循环发散的推理轮次才是吞噬预算的真正黑洞。
外部宿主用预算墙切断贪婪循环
要阻止智能体在后台无节制地吞噬算力资产,工程架构必须建立不可逾越的物理防线。
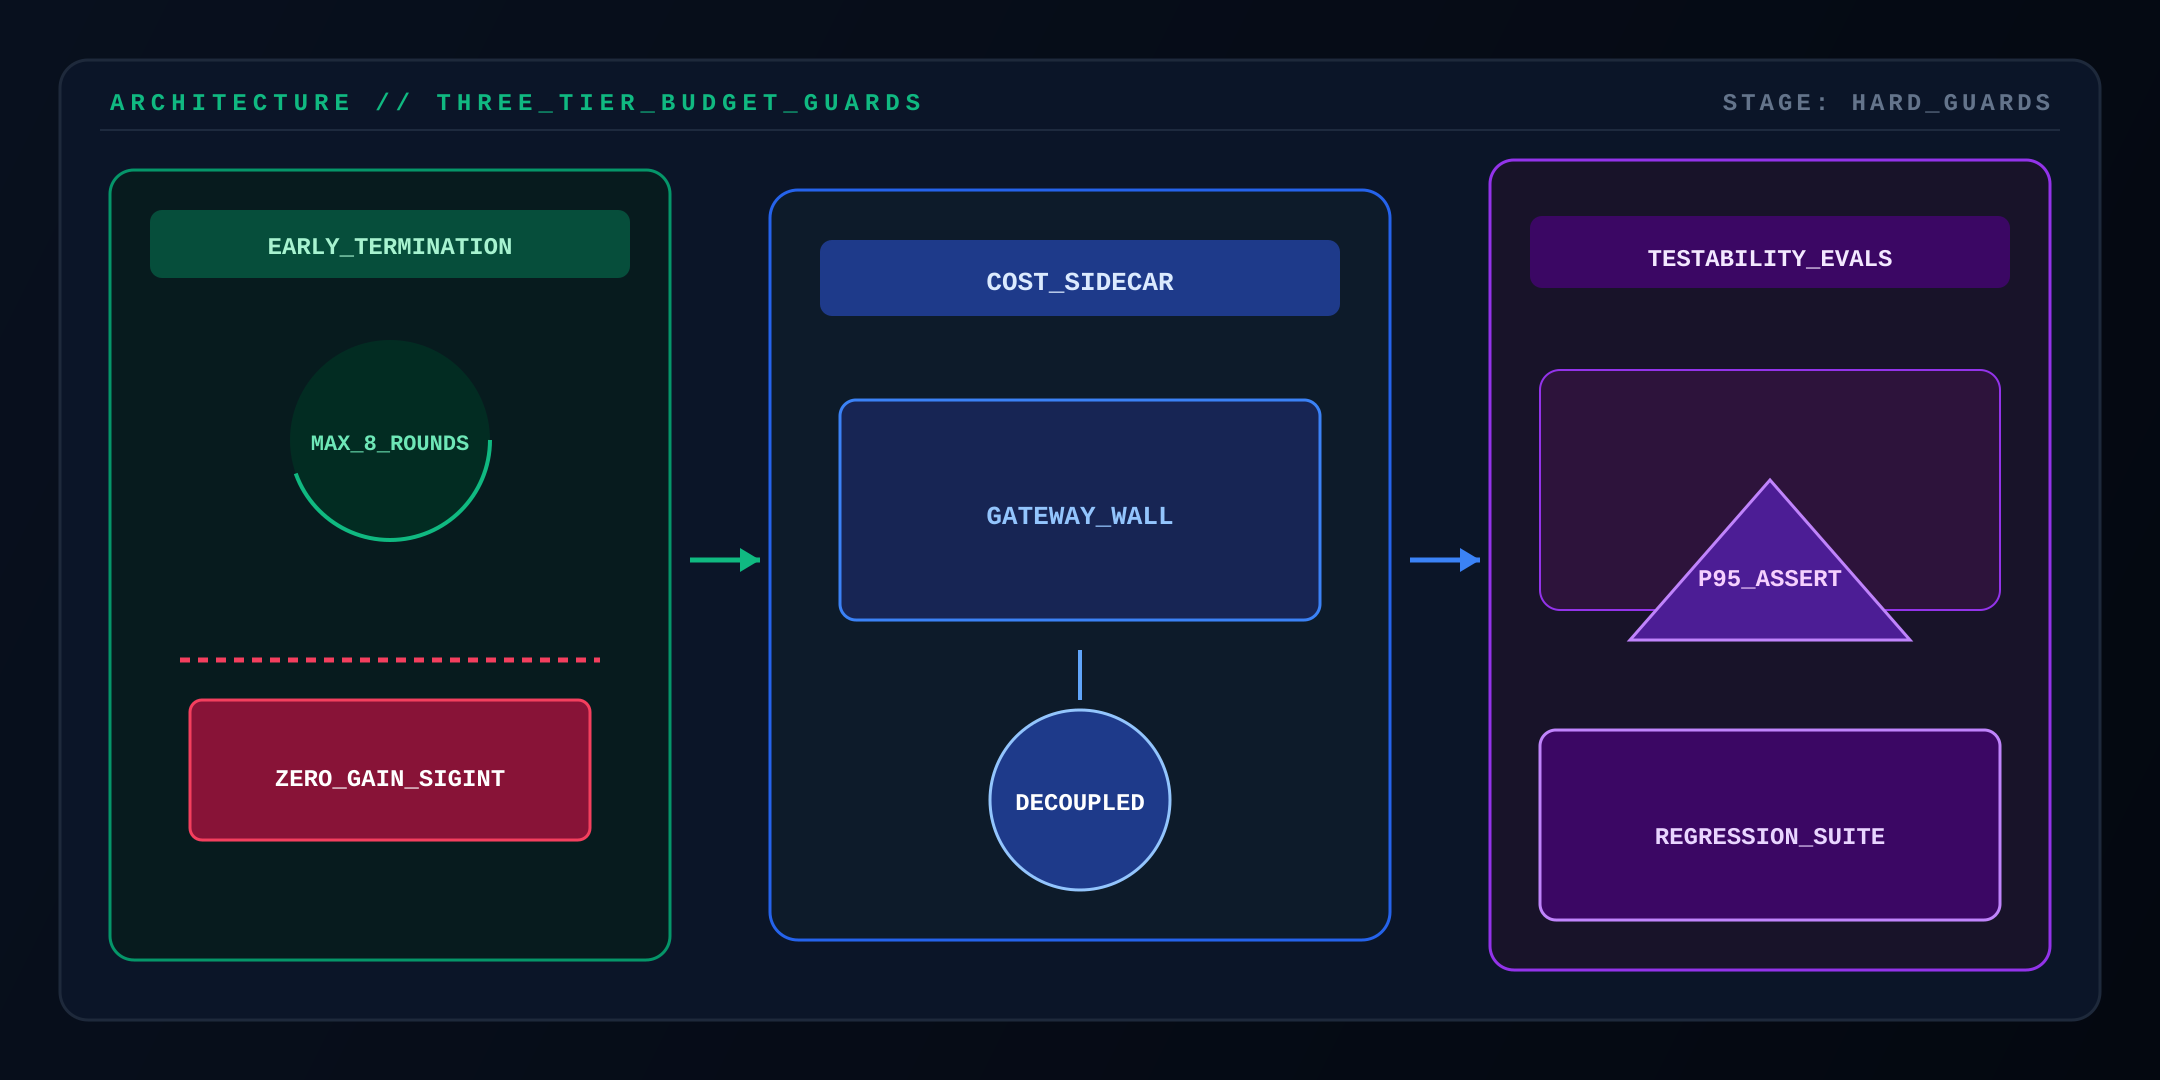
首先是坚定落实提前终止原则。智能体不具备对财务成本的内在感知。外部宿主程序必须在调度层设置刚性的轮次硬上限。单个任务最多允许循环探索八轮。宿主还要持续监控每一轮工具调用的有效信息增益。如果检测到智能体连续两轮都在重复检索相似目录,或者在相同的报错堆栈上死磕,宿主立刻强制中断进程。在前置节点掐断无效尝试,才能守住单任务的基础开销。
其次是坚持组合优于继承。很多团队试图通过系统提示词叮嘱模型节约开支。这种做法本质上是让业务逻辑继承模型的不可靠自律。稳健的做法是在调用链外侧装配正交的计费网关。网关只负责拦截进出流量并累计消费金额。当累计消耗达到预设的美元阈值时,网关直接向客户端下发物理熔断指令。控制逻辑完全独立于模型之外,确保无论模型内部如何发散思考,外部财务底线永远不会被击穿。
最后是引入具备确定性的成本回归测试。技术团队在升级或替换模型版本时,不能仅仅关注用例通过率。持续集成流水线必须把词元消耗区间作为硬性断言。每一次改动都要测算长程任务的消耗分布。如果新模型的平均消耗超出既定预算上限,合并请求在测试阶段就必须被直接拦截。
长程智能体的经济学底线,必须依靠外部宿主在出口处的确定性断路器来守卫。
大模型时代的研发治理,正在经历从提示词调优到严密系统工程的深刻转变。只有用确定性的基础设施约束概率模型的发散天性,自动化智能体才能安全可靠地服务于一线业务。