在开发长链路浏览器智能体时,许多工程团队遵循着一套看似天经地义的成本直觉。
程序每在网页上完成一次点击、输入或跳转,开发者就会主动执行上下文清理逻辑。陈旧的屏幕截图被即时剔除,冗余的文档对象模型节点被层层过滤。大家本能地认为,只要把每一轮发往大模型的字词元数量压到最低,就能帮团队省下真金白银的推理开销。
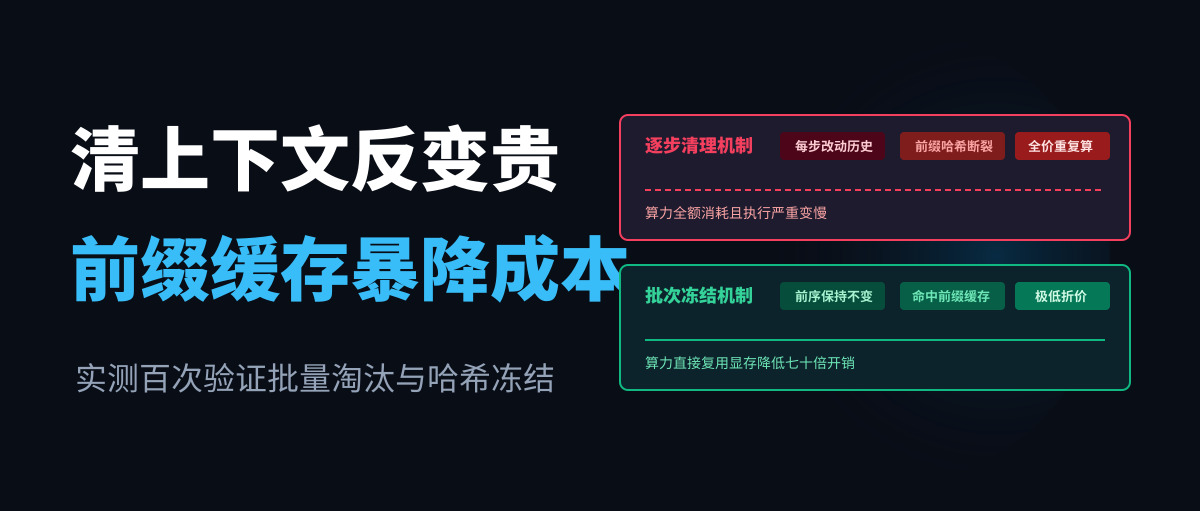
真实的基准测试给出了完全相反的物理事实。这种看似勤勉的逐步清理策略,反而亲手制造了惊人的资损黑洞。
每步裁剪历史反导致底层全价重复计费
为了评估真实生产环境下的资源消耗,研发团队针对复杂的企业级网页操作任务,进行了累计一百四十四次基准对照测试。
在未优化的基线流程中,智能体执行单次全自动业务流平均耗时达到二十余分钟,模型推理成本高达三十六美元。更严重的是,由于执行链路过长且频繁超限,大量复杂任务在半途中就遭遇超时熔断。
导致账单爆炸的根因,并非来自模型本身的单价昂贵,而在于每一次调用都在进行昂贵的重复全价结算。
现代大模型服务商为了降低推理延迟与计算成本,在底层基础设施中普遍引入了前缀缓存机制。只要前后两次请求的前半段字词元完全保持一致,显存就可以直接复用已经计算完毕的注意力键值缓存。在主流云端接口中,命中缓存的输入单价通常只有全量计算的百分之五到百分之十。
然而,前缀匹配在底层硬件中遵循着极度严苛的单向字节流哈希规则。
只要变动一个字符整段注意力重新计算
一旦请求的前半部分出现任何细微修改,底层的缓存索引链条就会在变动发生的位置瞬间断裂。
传统代码在每个执行步骤中动态修剪截图的逻辑,恰恰踩中了这个致命的物理陷阱。智能体为了省下几千个字词元的传输量,在第二步删掉了第一步的高清截图,或者微调了某一段提取出来的页面文本。
从大模型推理集群的视角来看,显存面对的是一段完全陌生的全新前缀。
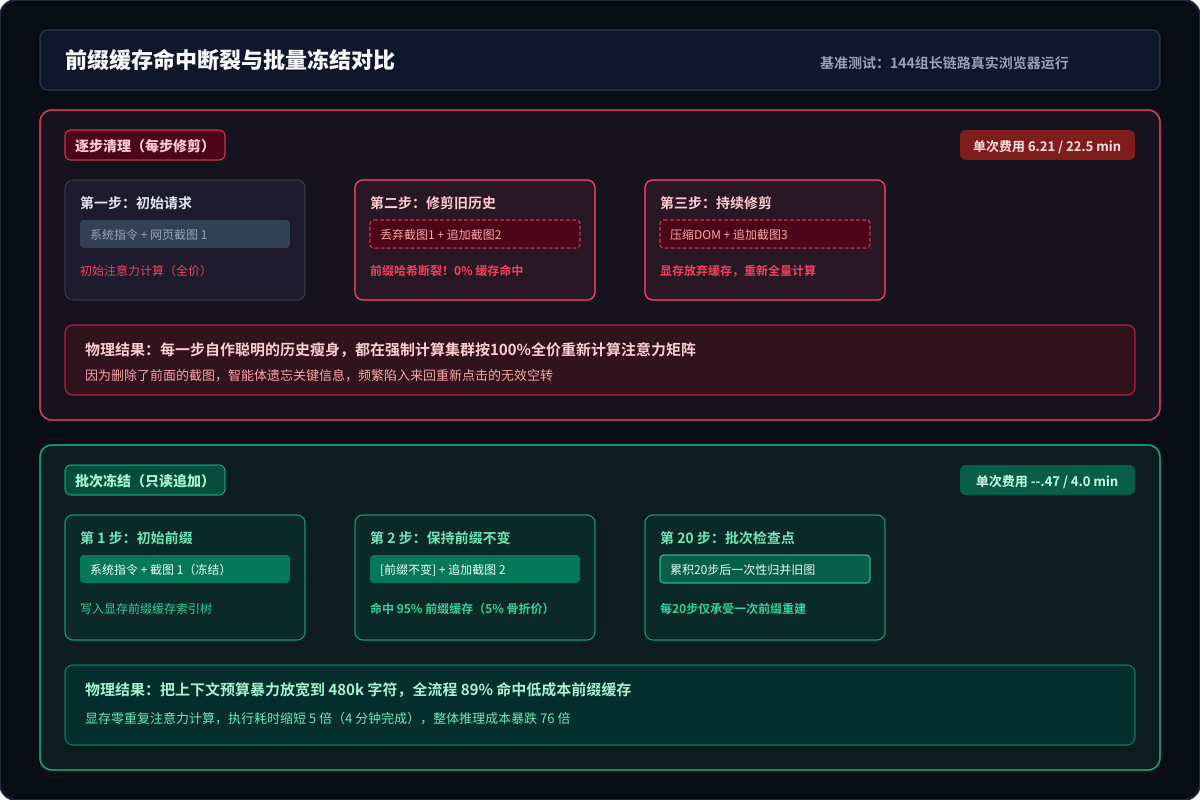
显卡必须放弃之前所有步骤积累的注意力缓存,重新为数万个字词元计算庞大的注意力矩阵。每一轮自作聪明的历史瘦身,都在迫使计算集群按百分之百的原价重新烧显卡。
更糟糕的是,过早丢弃历史上下文还会引发严重的认知遗忘。智能体因为失去了前序页面的关键信息,不得不反复回跳已经抓取过的网址,进一步加剧了步骤的冗余与调用的浪费。
放宽四倍历史预算账单反而暴跌七十倍
认清了底层算力流转的物理法则后,研发团队彻底颠覆了传统的优化直觉。
新架构不再纠结于每一步的微观瘦身,而是反其道而行之,将智能体的历史上下文容量直接从十二万字符暴力放宽到四十八万字符。
系统允许长链路执行中的屏幕截图在历史记录中自然堆叠,最长可以连续保留二十个操作步骤而不做任何修剪。在连续执行的过程中,前序生成的每一个字词元与图像数据都被牢牢冻结在请求序列的头部。
长链路智能体的成本瓶颈在于显存复用,保持前缀稳定远比微观剔除几个字符更关键。
测试数据显示,这一反常识的改动让请求的前缀缓存命中率直接飙升至接近百分之九十。
单次完整业务流的执行时间从原先的二十多分钟缩短至约四分钟,推理总费用更是从三十六美元暴跌至零点四七美元。
积攒二十步再清理把前缀缓存命中拉满
为了在有限的上下文窗口与长链路任务之间取得平衡,系统建立了一套清晰的批次淘汰流水线。
智能体在执行日常操作时,请求前缀保持绝对只读与不可变追加。所有新产生的页面截图与动作响应按顺序追加至尾部,确保云端服务能够持续命中低成本的缓存数据。
只有当连续步骤累积达到二十步的检查点上限时,流水线才会触发一次批量的上下文归并。此时系统一次性丢弃旧批次的冗余截图,仅保留最新的页面状态与核心事实摘要。
这种批次跳跃的方式,将原本频繁发生的缓存断裂从每一步一次,大幅压缩到了每二十步一次。
走出微观节俭的思维误区,顺应底层硬件与前缀缓存的物理特征设计流水线,才是规模化降低智能体落地成本的成熟路径。