在很多研发团队的持续集成流水线里,自动化代码审查正在变成一场信息灾难。
当开发者向仓库推送一段新的代码变更,触发流水线上的审查智能体,几分钟后合并请求下方会堆积数十条自动评论。模型礼貌地指出变量命名不够优雅,建议将函数拆分成小片段,或者在无关键逻辑的位置补齐注释文档。但在这些密密麻麻的排版建议下方,一段没有初始化的空指针引用正悄悄穿透检查,并发切片上的数据竞争也毫无阻拦地滑入了主干分支。
把全量代码差异直接送入大模型,是当下最普遍却也最昂贵的设计误区。
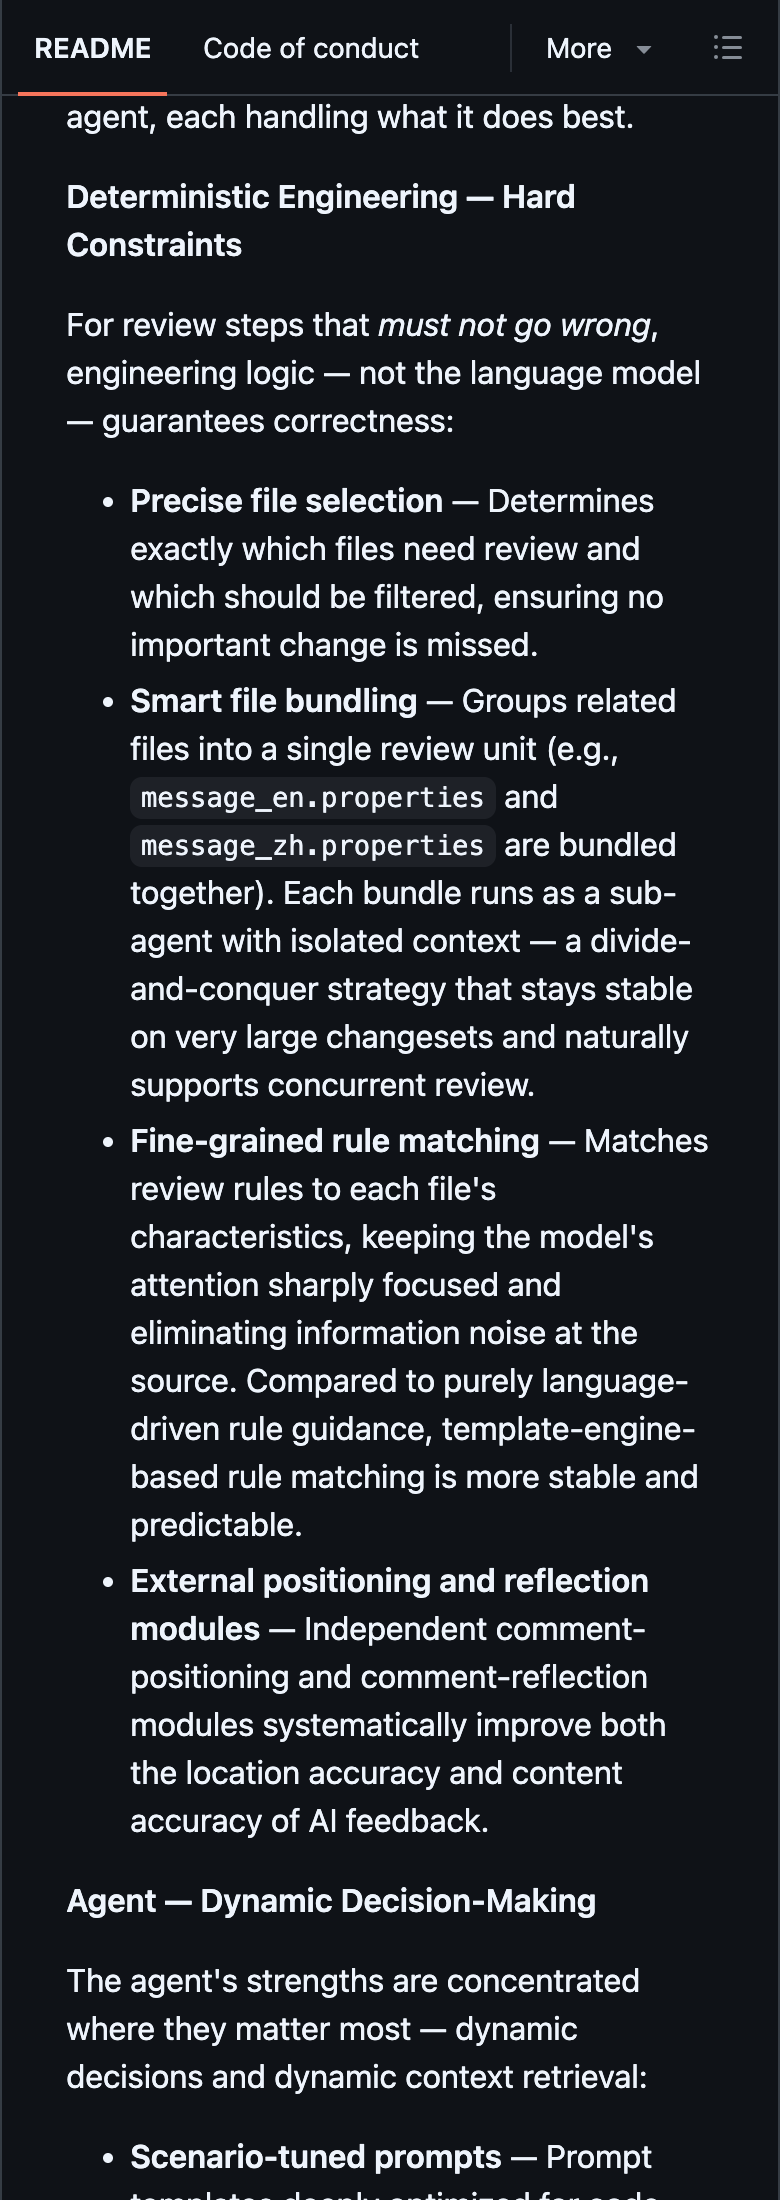
官方 README 对确定性工程与智能体分工的说明。来源:alibaba/open-code-review(网页实拍)。
满屏排版客套建议漏掉了致命空指针
大模型的物理本质是基于上下文窗口的概率序列预测器。
当它阅读一段代码文本时,注意力机制在所有词元之间建立关联权重。这种机制擅长揣摩代码片段的自然语言意图,推测开发者的业务诉求,却无法对代码结构执行严格的符号断言。一段代码是否存在空指针引用,取决于变量在所有执行路径上的定义与状态流转;一个并发竞态问题,取决于读写操作在时间片上的交叉锁争用。
面对这种严密的有限状态机逻辑,大模型只能凭借训练语料里的概率统计进行猜测。
这就导致了极其尴尬的审查现场。当模型面对几百行复杂的业务差异时,由于缺乏全局符号解析能力,它倾向于挑出最容易形成文本回复的浅层问题。格式排版、变量命名风格、注释完整度,这类表层文本特征占据了几乎全部的回复配额。
团队不仅为此支付了高昂的词元推理费用,研发人员更被迫在几十条低价值噪声中辨别有效信息。长此以往,开发者开始对所有审查结果产生疲劳麻木,习惯性地直接点击合并。
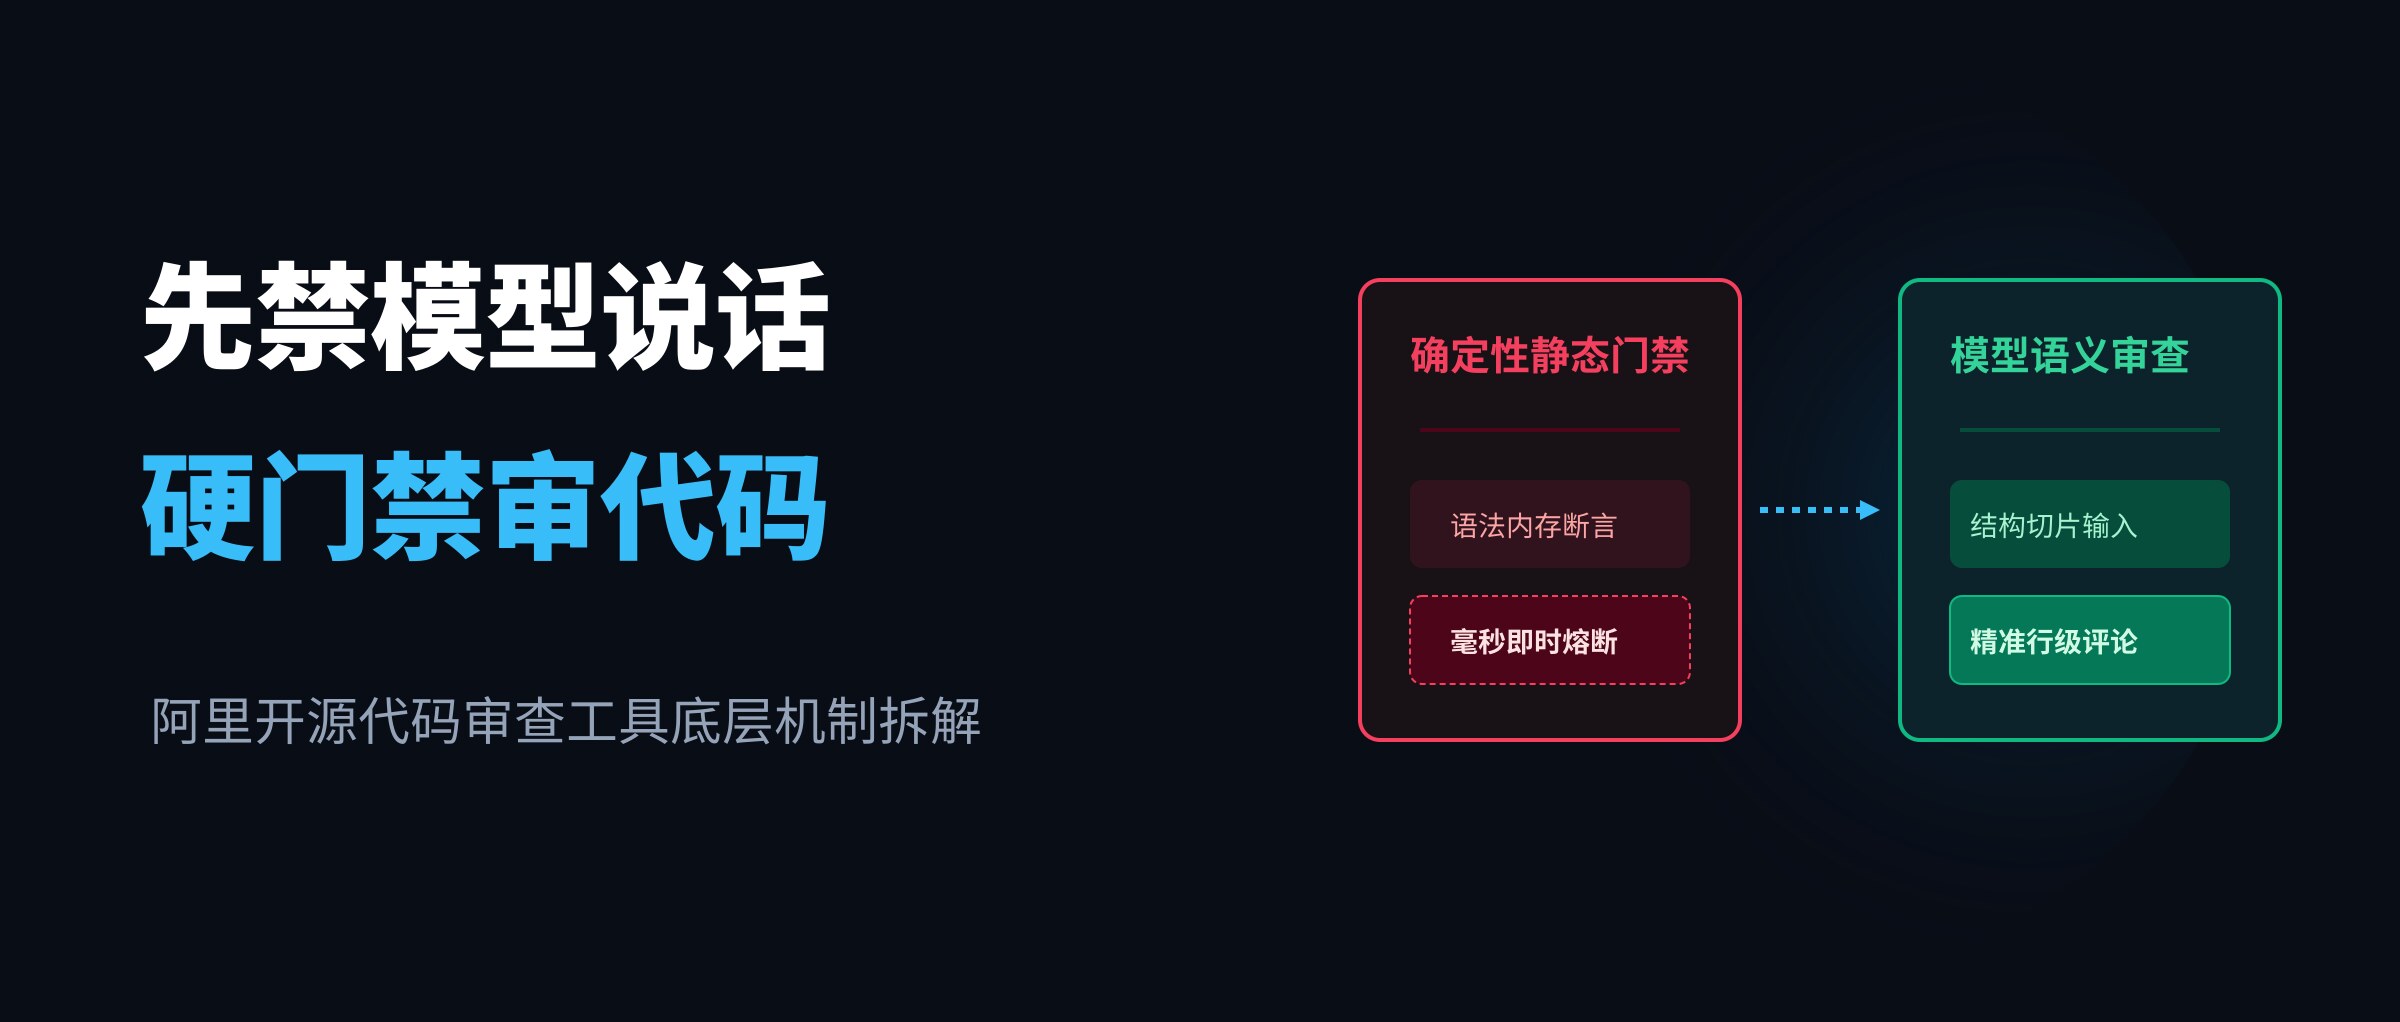
最硬核的代码审查流水线,第一步必须是禁止大模型说话。
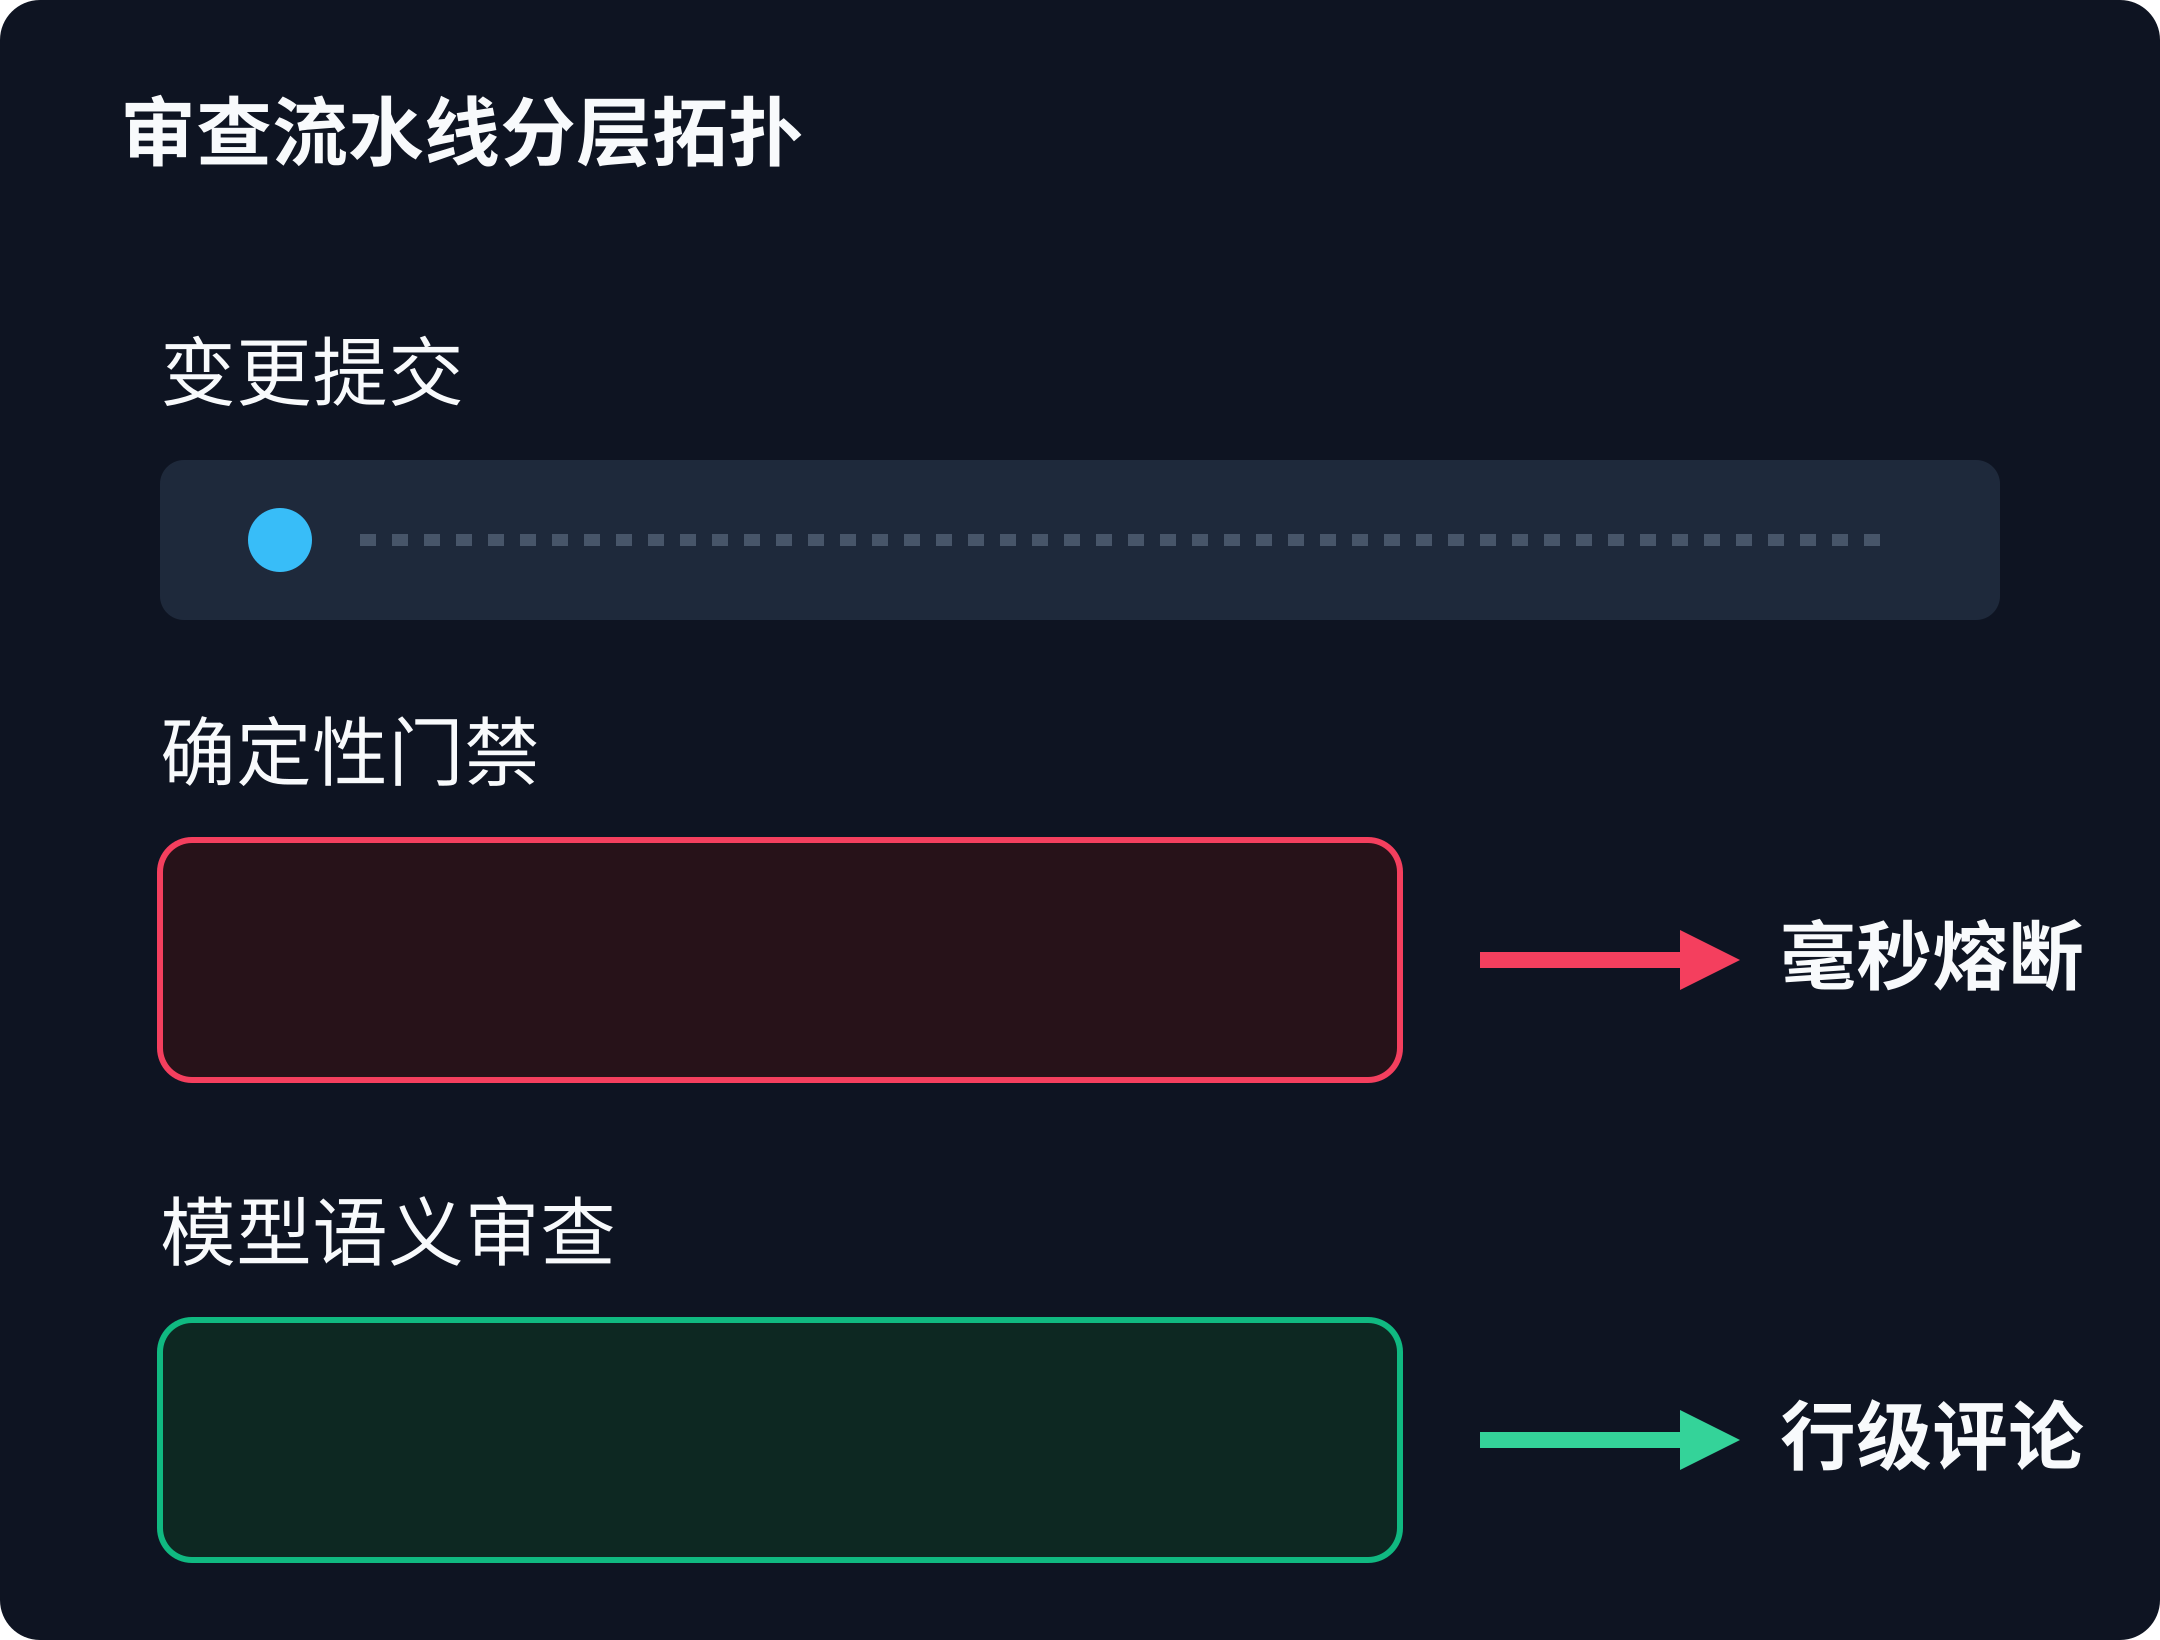
确定性规则前置门禁与模型分层审查拓扑
确定性静态规则在毫秒内掐断无效拉取
阿里在近期开源的代码审查工具中,选择了一条截然不同的技术路线。
这套系统没有盲目堆叠大模型提示词,而是用高效的底层语言构建了一道确定性硬门禁。当代码提交到达网关,系统执行的第一步不是发起云端大模型调用,而是直接启动本地的抽象语法树分析器与静态安全探针。
在极短的十几毫秒时间内,静态分析引擎会遍历全部变更路径。
系统内置了针对多语言环境的数十条硬规则,覆盖空指针解引用、线程安全读写、数据源输入转义等确定性故障点。静态符号检查器沿着函数调用栈顺藤摸瓜,一旦发现可能导致服务崩溃的显式缺陷,流水线立刻执行提前终止策略。
整个检查过程消耗的中央处理器算力微乎其微,更不需要消耗任何云端模型推理额度。
如果一份代码变更连基础的语法完整性和确定性内存安全都无法通过,它根本不配被打包成提示词去打扰大模型。这种物理级的快速熔断,将海量低级代码缺陷在入库的第一秒直接拦截,同时也把后续的审查算力消耗压缩了近八成。
语义模型只在最后一步核对业务意图
只有通过全部确定性探针的代码切片,才会被允许进入智能体审查阶段。
此时,大模型的职责边界被收敛到了一个极其精确的区间。系统不会把成千上万行未经处理的代码文本全盘抛出,而是根据抽象语法树解析出的影响范围,提取出核心接口契约变更与依赖切片。
在这个阶段,大模型不需要再去核查括号有没有配对、指针是否为空。
语法与并发靠编译器绝对断言,大模型只看业务边界与契约。
模型开始执行它真正擅长的任务:理解两处模块之间的参数约定是否合理,判断接口变更是否破坏了向后兼容性,评估业务异常流的处理逻辑是否闭合。由于输入上下文剥离了琐碎的语法噪声,大模型吐出的内容不再是无关痛痒的客套排版建议,而是直击业务逻辑核心的精准行级评论。
审查结果的假阳性误报率由此直接从四成以上跌落到了个位数。
机器负责绝对断言人类盯紧业务契约
代码工程从来不需要一个无所不知却漏洞百出的全能模型。
在持续集成的物理现实面前,不同工具天然有着明确的职责边界。编译器与抽象语法树工具是逻辑世界中的铁律执行者,执行确定性规则的成本最低、速度最快、确定性最高。大语言模型是语义世界里的泛化理解器,负责处理模糊的自然语言与模块契约关系。
真正的工程质量体系,来自确定性硬规则与语义模型的正交组合。
当团队搭建自动化代码审查流水线时,最重要的设计不是给智能体编写多么复杂的系统提示词,而是在前面修筑一道坚固的确定性闸门。让静态规则在毫秒级断言一切客观语法,让大模型只在最后一步核验主干契约。
唯有让编译器守住底线,大模型在代码审查现场的价值才能真正释放。