一边在炉灶前准备晚饭,一边通过桌面端语音模式指挥代码模型,半个小时构建出博客系统的往期通讯归档功能。
开源作者 Simon Willison 最近进行了一场真实的端到端开发实验。在厨房做饭的三十分钟里,作者全程依赖语音对话生成了 Django 数据模型定义、数据库迁移脚本、视图函数与前端模板,并完成了多源外部数据的抓取逻辑。然而晚饭结束后,作者坐回书桌前打开拉取请求界面,重新花费了三十分钟敲击键盘,重构接口调用并修复样式细节,才最终将代码合入生产主干。
这场耗时一小时的实验,清晰勾勒出了当前智能体语音交互的真实边界。
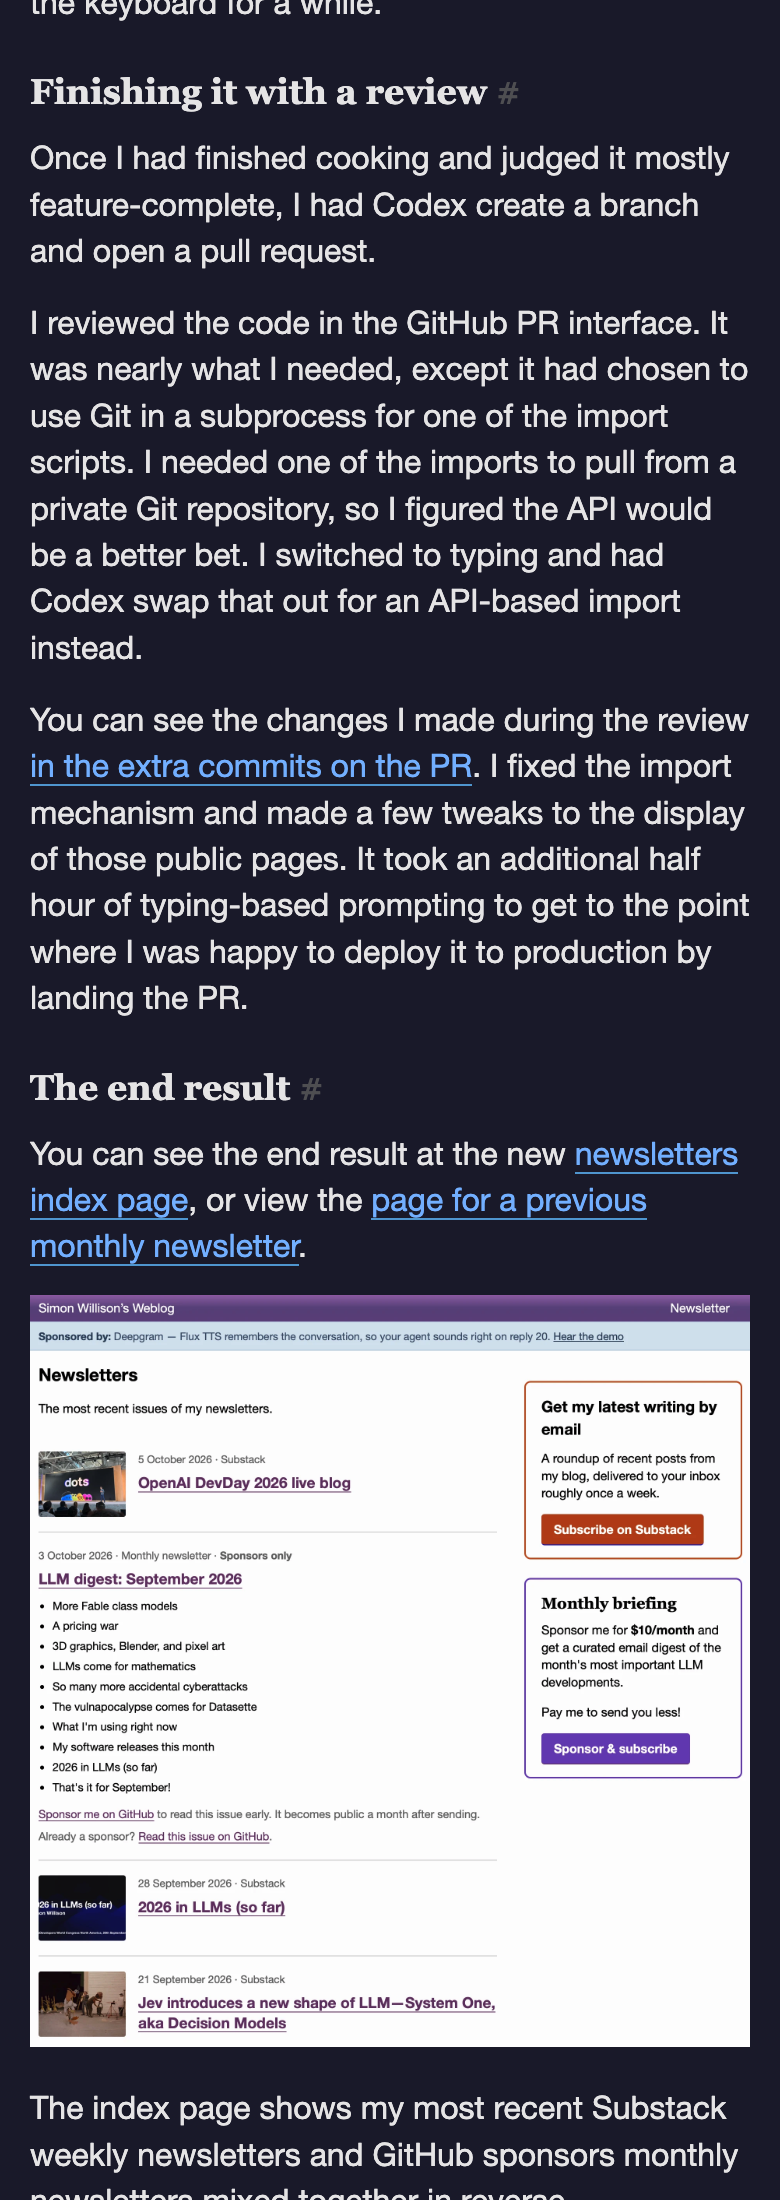
作者实验原文:做完饭后回到键盘审查代码,并继续用打字修改半小时。来源:Simon Willison(网页实拍)。
口述迅速生成基础业务逻辑与数据模型
在不需要精确物理输入的探索阶段,语音交互展现出了极高的容错能力。
口述过程不可避免地伴随着大量口语冗余、停顿与自我纠正。当作者口头表达“先建好数据表,不对,先加一个布尔字段标记公开状态”时,底层模型顺利理解了上下文演进,直接生成了结构准确的 Django 迁移文件。针对四个不同内容平台的抓取需求,口述流转规则也显著省去了手动编写样板代码的繁琐。
在双手被占用的场景下,语音非常适合推进发散性的系统构思。
缺少凭据导致调用机制滑向子进程妥协
当任务深入到系统底层与安全凭证时,纯语音交互出现了明显摩擦。
为了从私有仓库抓取赞助者专属数据,系统必须读取个人访问令牌。然而在厨房口述长达数十位的加密凭证不仅极易出错,在物理空间朗读密钥也存在安全泄露隐患。
由于无法在对话中直接注入凭据,智能体选择在子进程中直接调用本地 Git 命令替代标准接口。这种实现机制虽然在本地环境能够运行,但在缺少环境认证的生产集群中极易引发不可预期的进程阻塞。
视觉扫视代码差异与听觉线性等待的落差
两种交互介质在信息带宽与审查效率上存在显著差异。
代码从来不是单向流动的自然文本,而是具备多层级引用与边界约束的高维语法树。在代码差异审查界面中,人类视觉系统具备高并发扫描能力,能够在数百毫秒内跨行捕捉到悬空引用与边界漏洞。
声音则属于一维时序流。音频信号只能以每秒数个单词的恒定速率播放,工作记忆容量受限。要求模型逐行读出生成代码,听者必须忍受极低的信息密度与线性等待。
代码并非线性文本,高密度语法依赖与上下文核对决定了视觉审查效率远高于线性听觉等待。
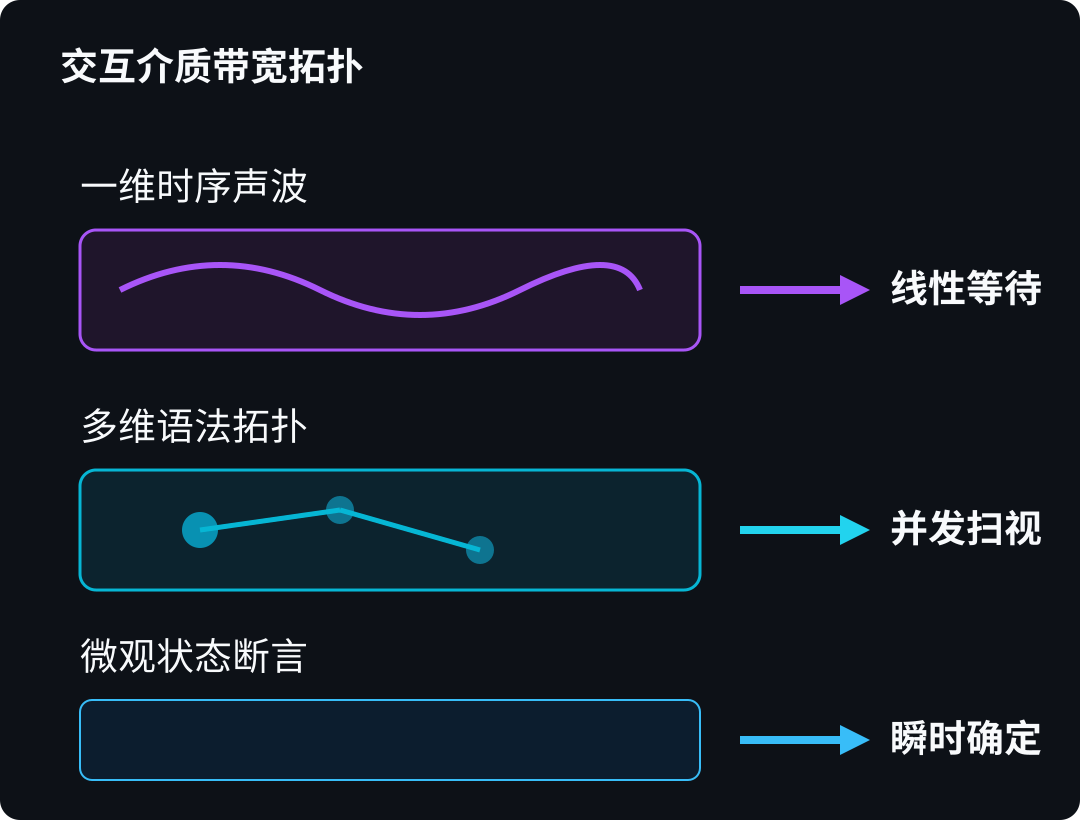
一维时序声波与多维语法树拓扑差异
关键凭据与行级审查依然依赖屏幕与键盘
这场实验最终以清晰的分工收尾。
做完晚饭后,作者坐回工作台打开拉取请求。键盘输入提供了确定的字符断言,作者迅速将子进程命令重写为官方客户端调用,并对前端模板的间距完成了行级微调。
语音交互能够快速推进宏观意图展开,但涉及精准凭据与细粒度差异审查依然离不开屏幕与键盘。
对于现代开发工作流而言,语音输入适合在构思与粗粒度框架搭建阶段充当加速器。而严谨的边界测试、敏感凭证配置与差异审查,依然必须依托高密度屏幕与物理输入设备。