一行代码进入大模型,先会变成什么?很多模型接收的是分词器输出的编号。函数名、标点和缩进,未必各自对应一个编号。
这里的切分规则由词表和算法决定。给定相同的分词器版本与输入,结果是确定的;换一种分词器,结果可能不同。“几个空格一定拆成几片”不能当成通用规律。
字节模型研究想改变的是这层输入表示。它更接近原始字符细节,仍要面对计算成本,也不会自动获得代码正确性。
子词切分改变字符可见性
子词分词把常见片段合成一个标记。常见词能用较短的序列表达,但标记边界并不是程序语法树的边界。
例如,Python 用缩进界定代码块,挪动一个空格就可能改变程序是否合法。模型需要理解这些细节,分词方式会影响它看到的信息粒度。不能因此推断,所有代码错误都由分词器造成。
判断自己的工具是否受影响,要看目标分词器对具体输入的结果。不能只凭空格数估算消耗,也不能把换行和缩进的切分例子推广到所有模型。
字节表示与分块计算的成本
中文字符通常由多个 UTF-8 字节表示。输入单位变细,序列也可能变长。逐字节运行完整的大模型,计算开销可能更高。
BLT 提供了一条处理路线:根据下一字节的不确定程度,形成大小不同的 patch。局部模块处理字节,全局模块主要处理这些分块。把算力放在哪儿,成了架构的一部分。
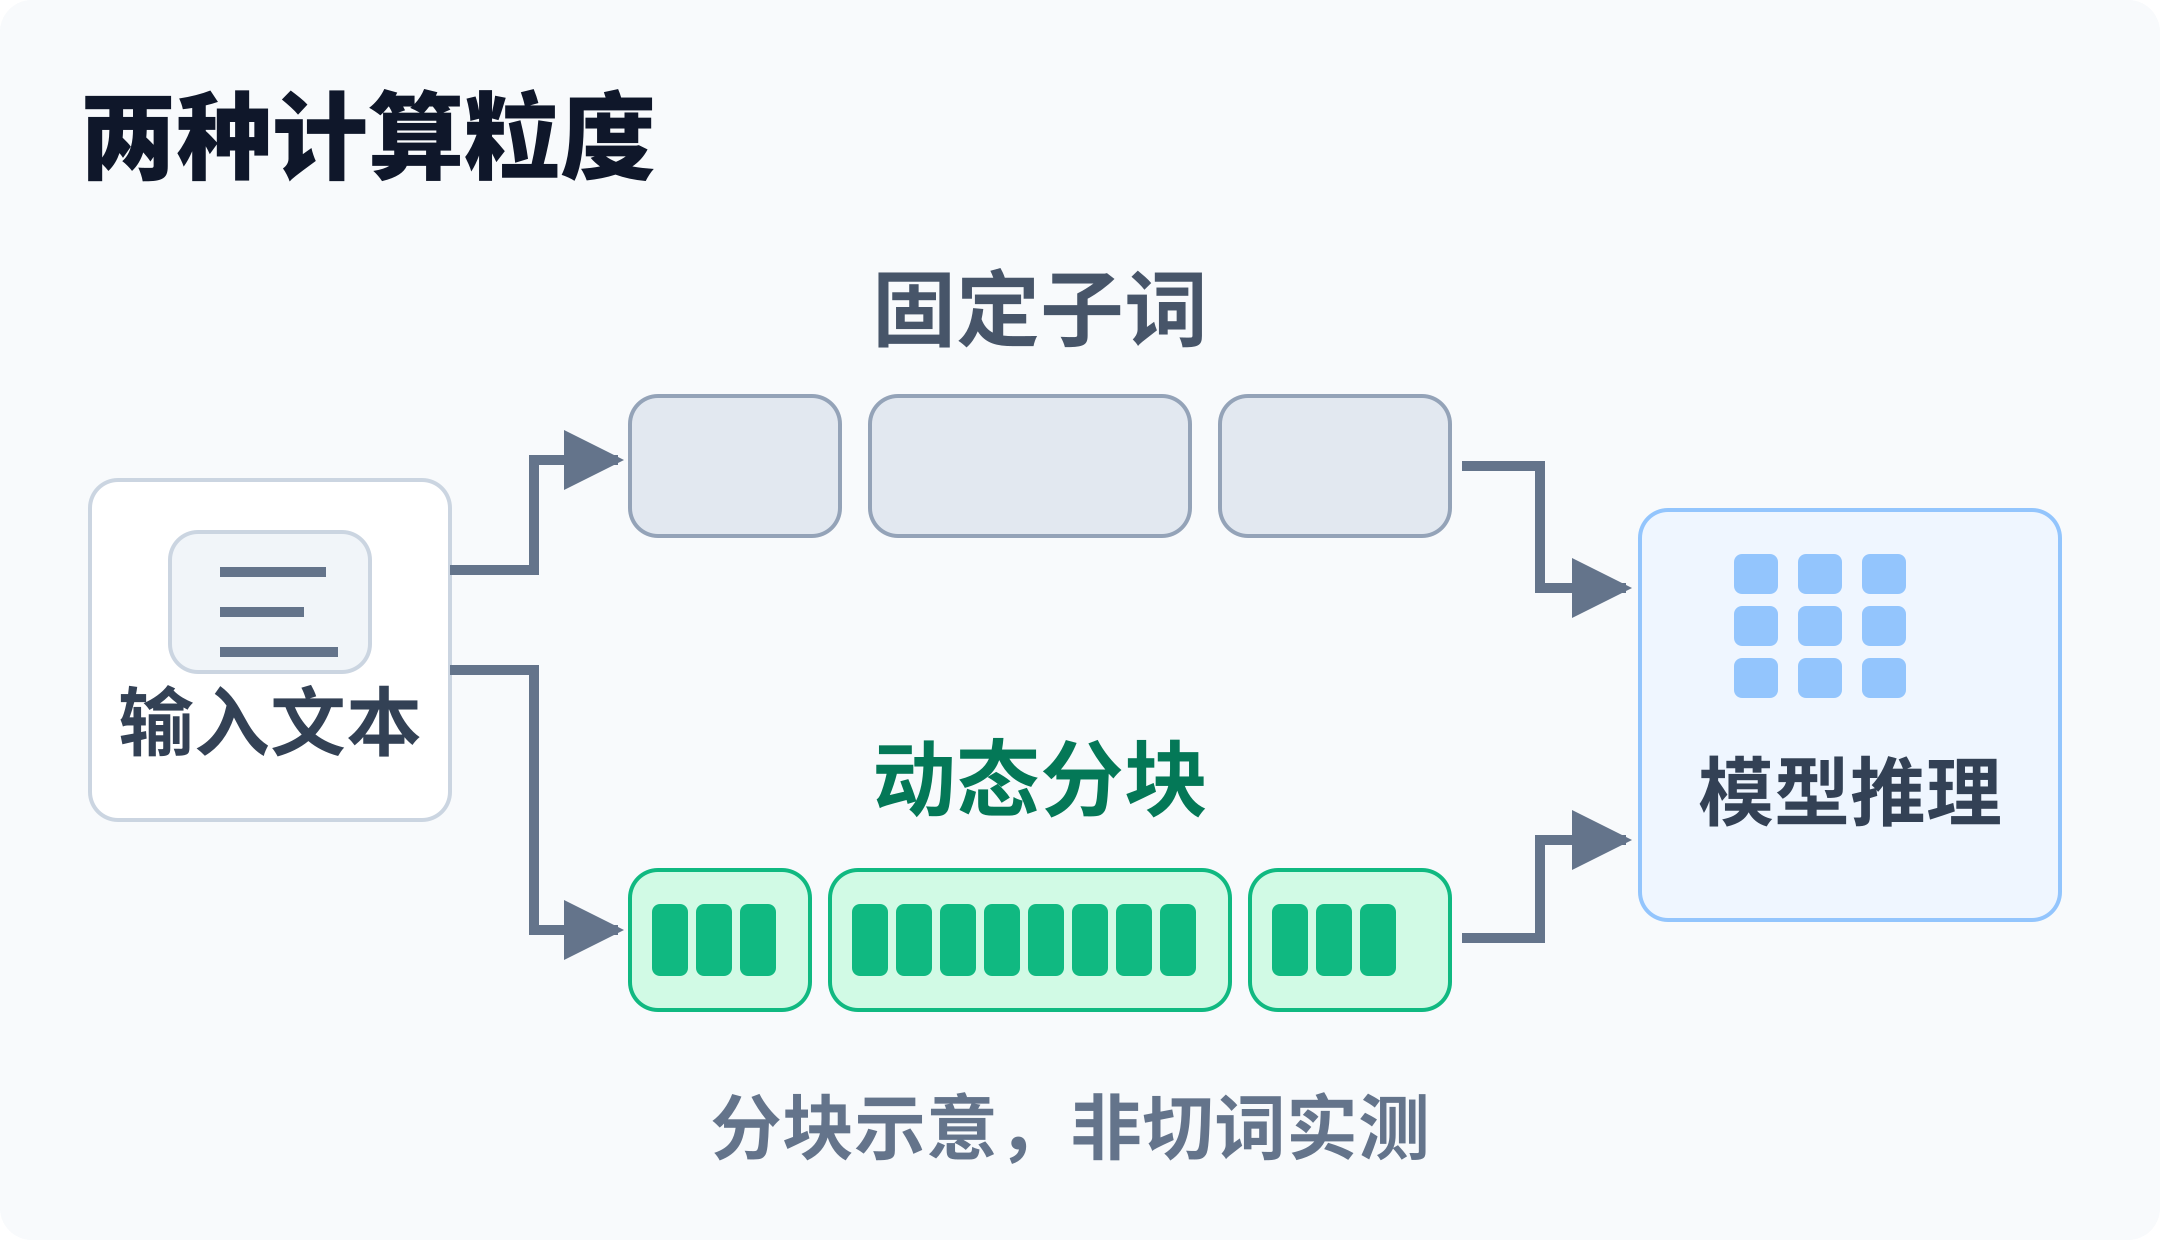
图以上下两条路径说明粒度差异,下排以 BLT 为例。分块长度是示意,省略了局部编码和解码细节,不能当作某个分词器的实测结果。
Bolmo 走的是另一条路线:把已有子词模型改造为字节模型。它的第一阶段保持原有全局模型固定,训练新的字节组件;后续阶段再继续训练。两者都研究字节表示,但训练流程不同。
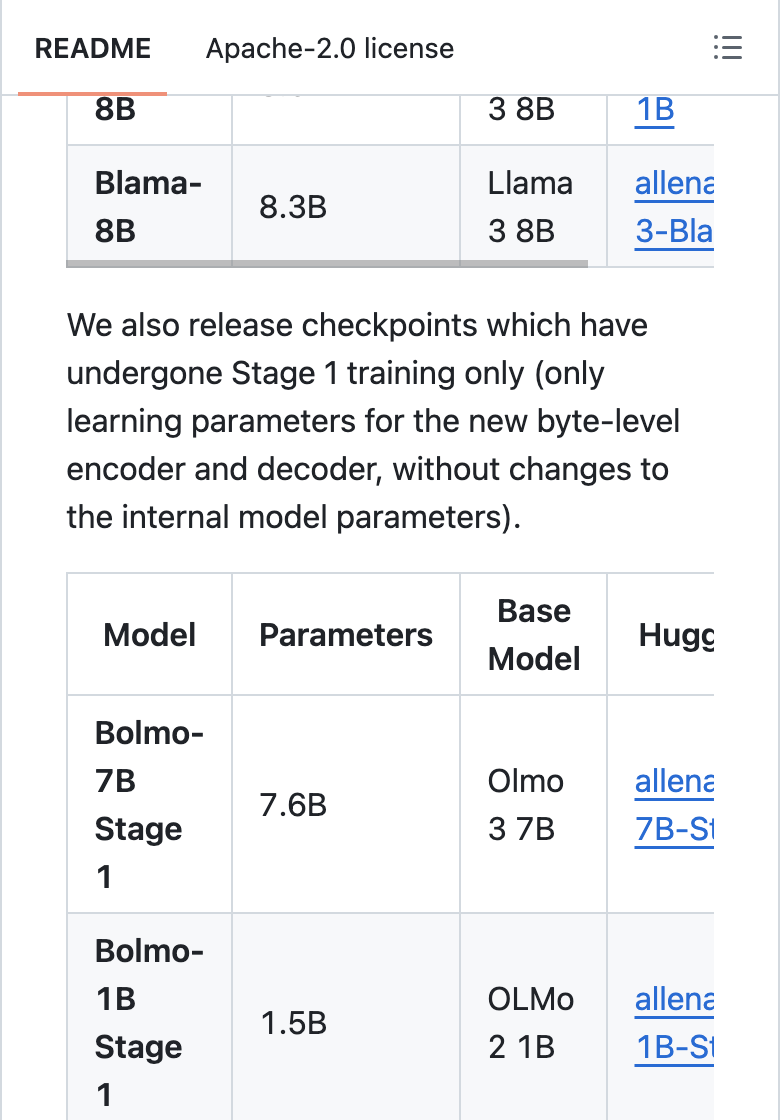
图为 Bolmo 官方仓库网页实拍。截取的是 Stage 1 检查点说明,显示新字节组件可以单独训练。原始页面 https://github.com/allenai/bolmo-core
表示粒度与安全验证的边界
Ai2 在 2026 年 10 月介绍了 Bolmo 研究进入 Nature,以及扩展到更多模型家族的检查点。这是一条正在验证的研究路径,不代表主流模型已经全面放弃子词分词。
字节输入也没有消除所有离散表示。输出仍可以是字节编号,模型内部还可能使用潜在分块。它同样不提供操作系统权限,更不会天然防住提示注入。
看清字符细节,与证明代码合法,是两件需要分别验证的事。
实际选型可以拿自己的代码样本比较分词成本、生成结果和运行延迟。编译、测试、权限隔离仍要保留。模型换了一种表示,工程验收的责任还在应用层。
资料:Bolmo 论文 https://www.nature.com/articles/s41586-026-11111-4
Ai2 官方说明 https://allenai.org/blog/bolmo-nature
BLT 代码与论文入口 https://github.com/facebookresearch/blt