所谓的代码自进化到底在进化什么
代码代理修改一个工具文件,下一轮任务就会使用新实现。看见系统连续改代码,很容易把软件变化理解成模型本身在学习。
普通推理通常不更新模型参数。这是执行阶段的安排,不意味着显存天然受硬件写保护,也不意味着整套系统永远不能训练。
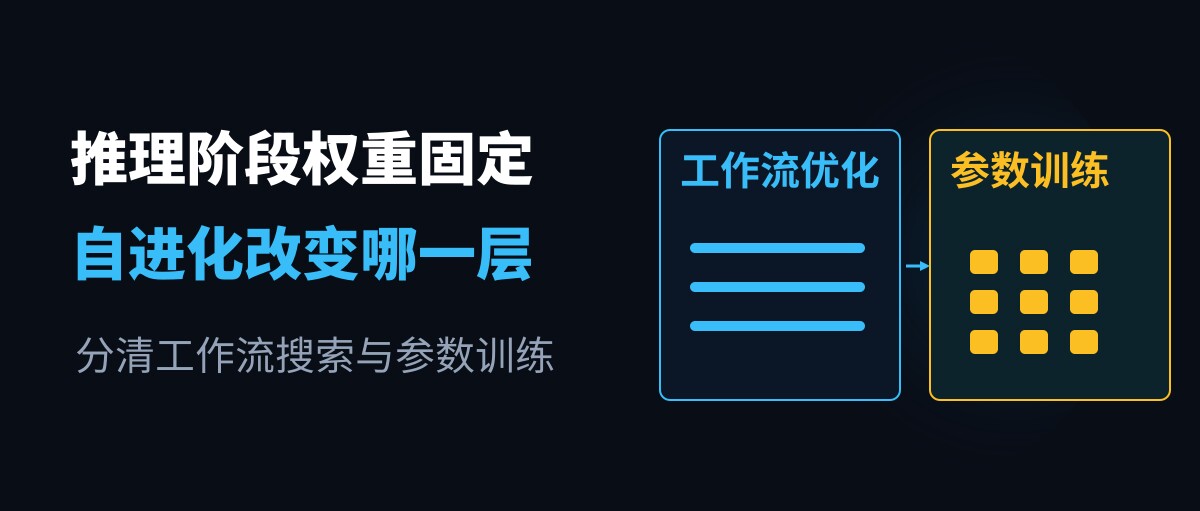
要判断一次“自进化”改了什么,先找变化落在哪一层:提示与工作流、代码与工具,还是模型的有效参数。
固定参数下的工作流优化
同一个模型,收到不同的上下文、工具结果和任务分工,表现可能不同。改进检索、拆分任务、保存失败案例,都可以改变系统行为。
这些变化发生在模型外围。代码代理修改了工具实现,也不能据此声称神经网络参数已经学习过这次经验。
Sakana 的 MASS 把工作流搜索放在内环。模型执行候选流程,评估完成的结果,再提出下一版流程。这个阶段保持模型权重固定。
适配器训练改变有效模型
MASS 没有停在工作流搜索。它还从选定流程中筛选执行轨迹,用这些轨迹进行 LoRA 训练,再把更新后的模型放回各个角色。
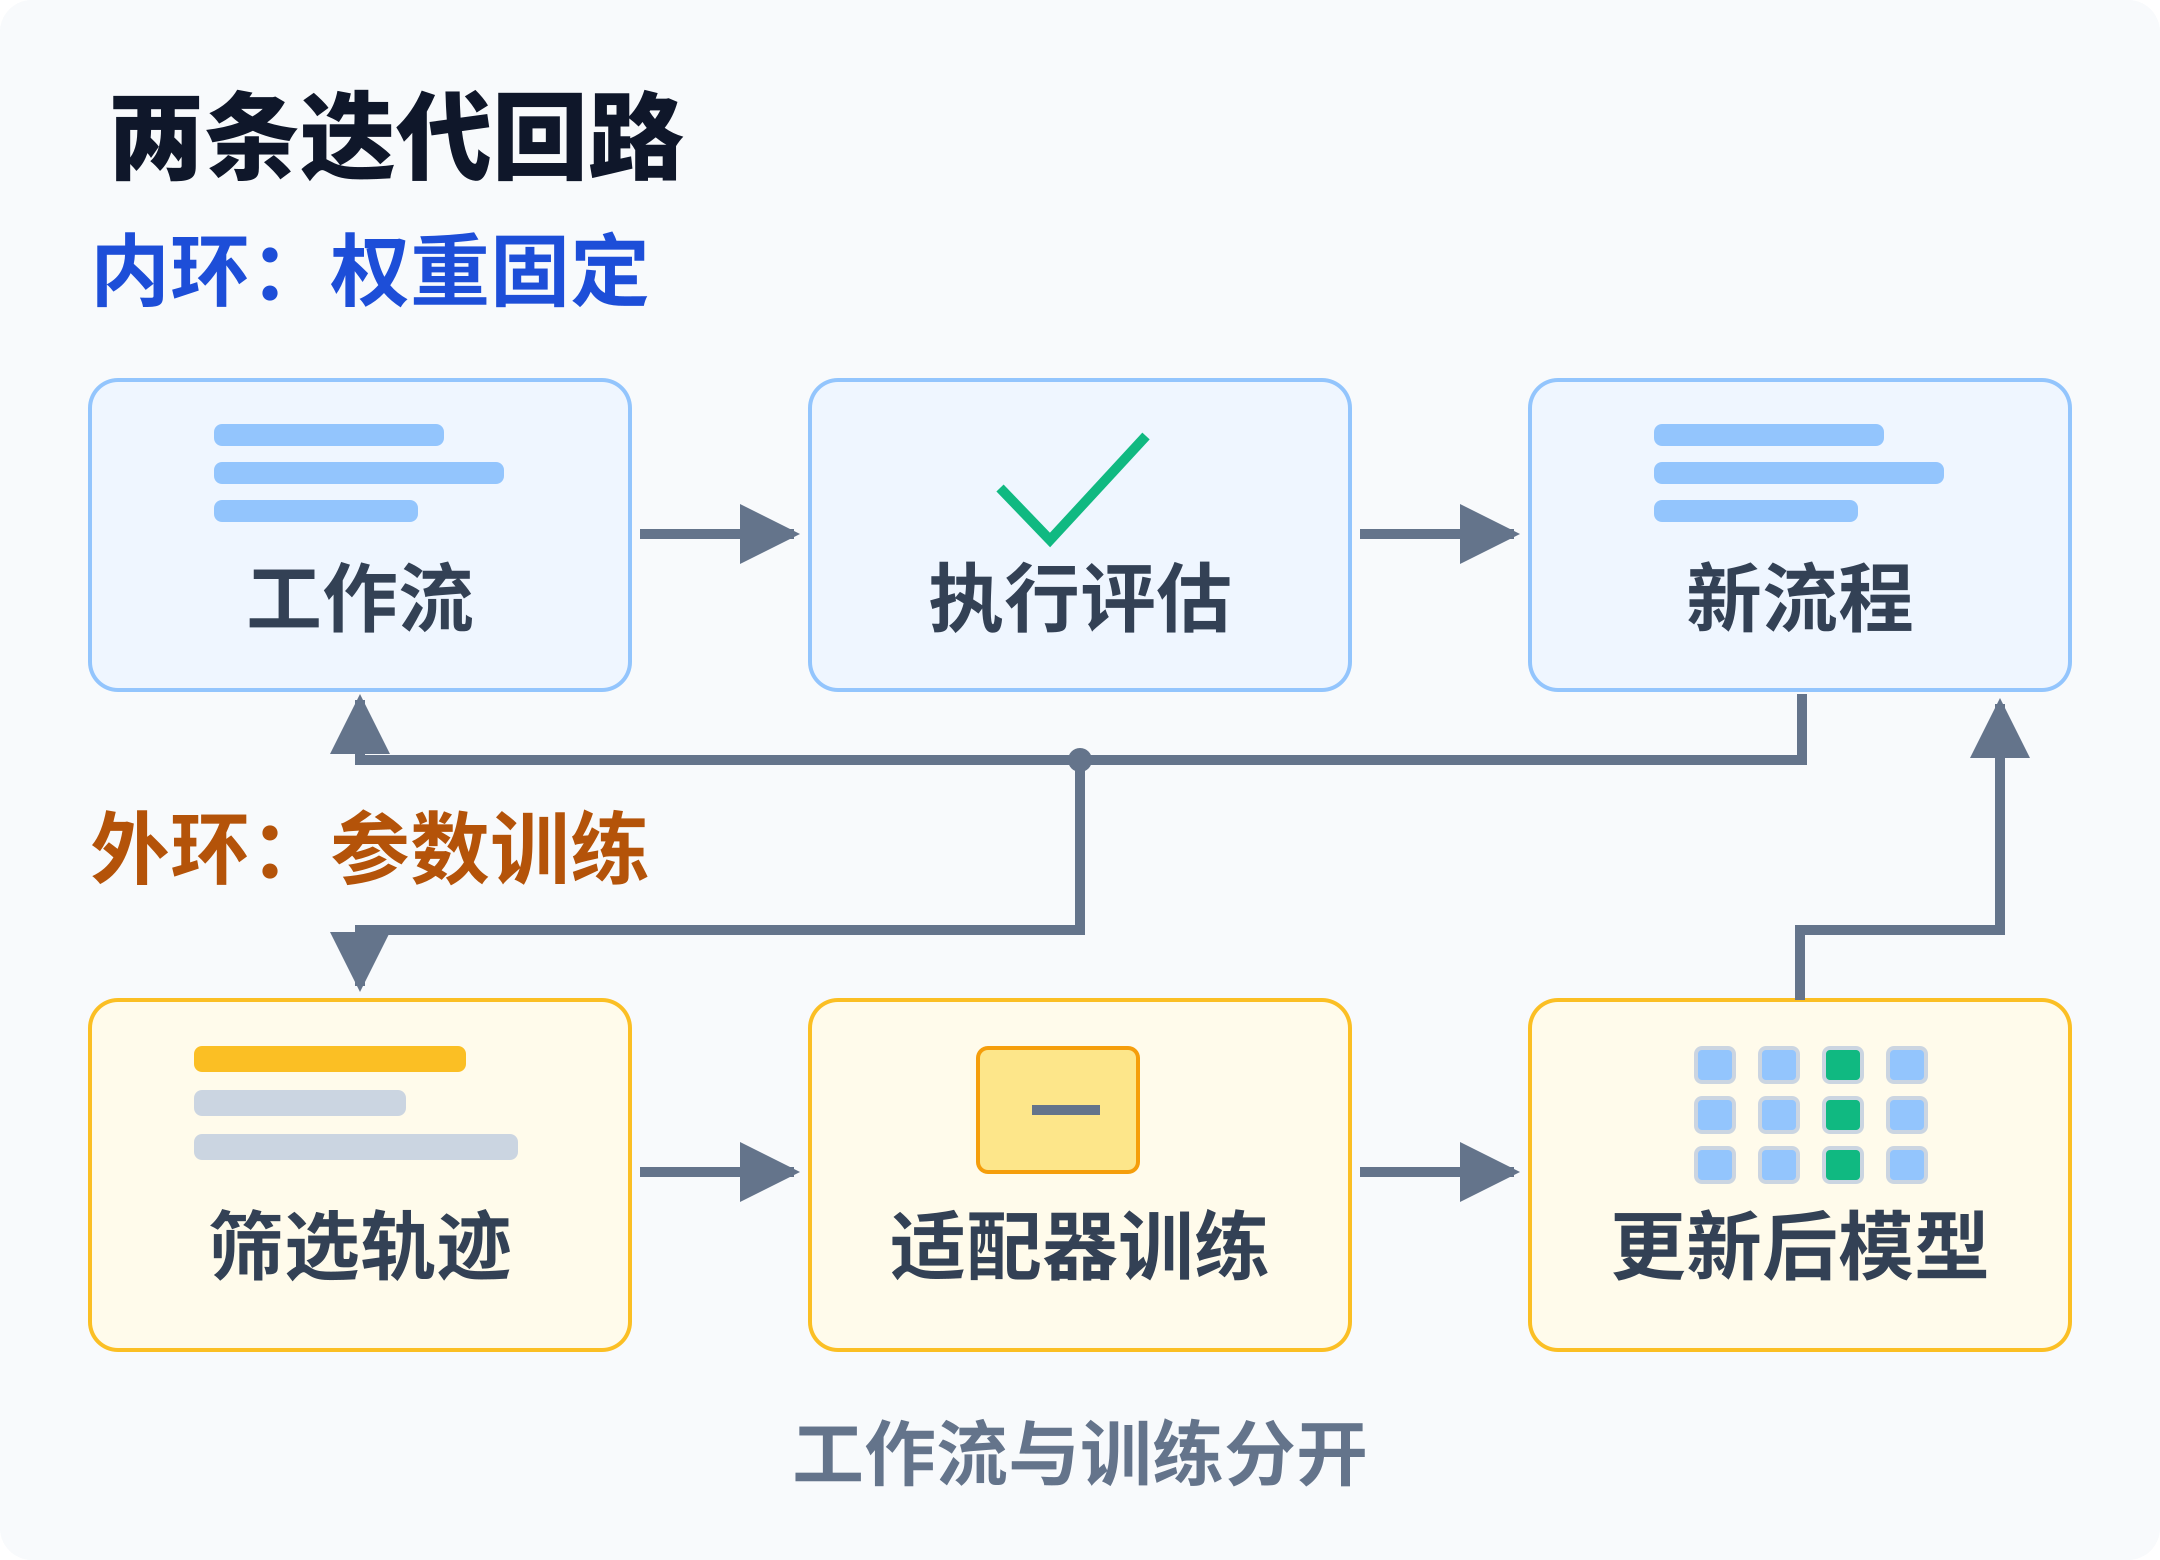
上半部改流程,下半部训练适配器。LoRA 可以保持基础参数不变,同时更新适配器;有效模型行为仍然会改变。图里的“更新后模型”表达这层变化,不表示所有基础参数都被重写。
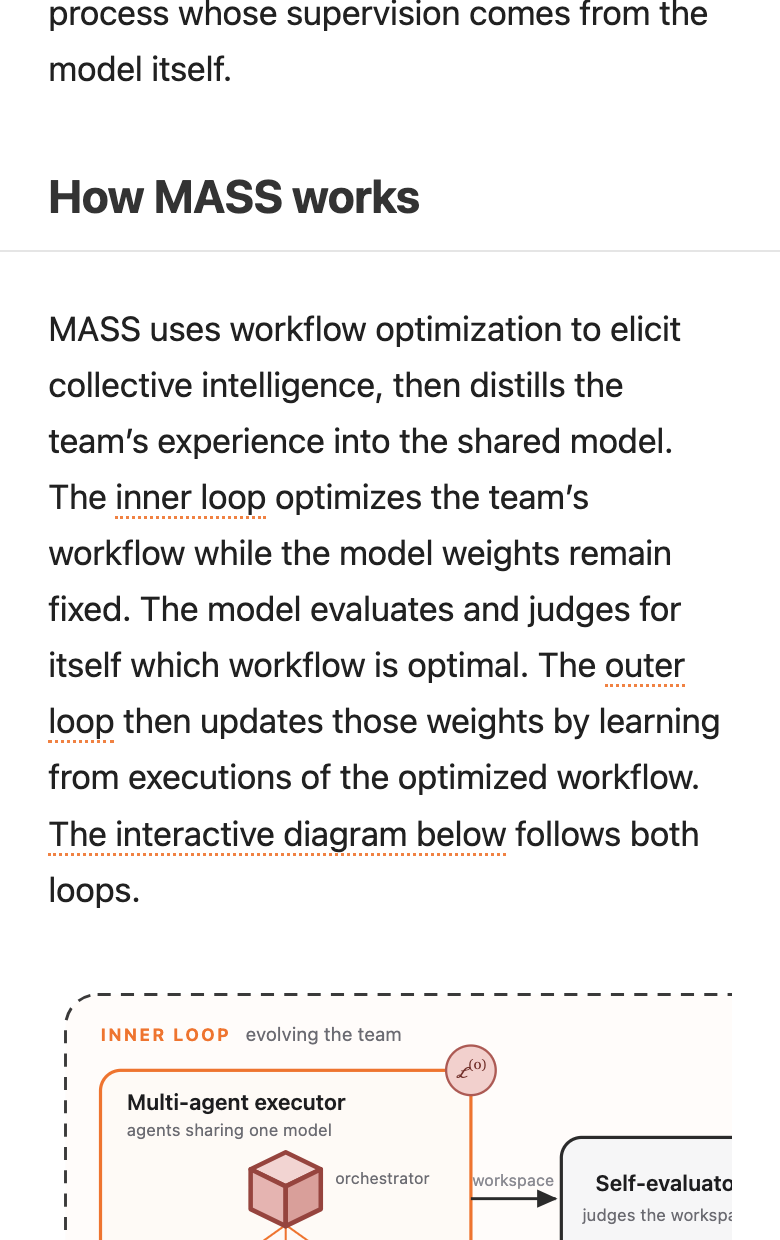
图为 MASS 官网网页实拍,说明内环优化工作流、外环学习选中的执行轨迹。原始页面 https://pub.sakana.ai/mass/
一次代码迭代算不算模型学习,取决于有没有训练及参数更新证据。
在一个固定权重的代码代理中,所谓进化可能只发生在工具代码和工作流。在带训练外环的研究系统中,变化还会进入有效参数。这两类系统不能混为一谈。
迭代评分与外部验收的边界
模型给自己的产物评分,可能奖励了擅长迎合裁判的解法。这个风险值得检查,但不能直接写成“闭环几轮必然崩溃”。
MASS 使用模型自身的判断指导搜索和数据选择,同时另外报告外部裁判评估。外部评估有助于观察进展,也仍有任务覆盖和裁判偏差的边界。
做自己的代码迭代系统,最好保存每一版产物、测试命令和真实结果。测试是否覆盖需求、是否被候选代码修改,也要单独核对。退出码全绿不代表测试足够。
复盘时把三样东西分开记录:改了什么产物、用了什么反馈、有没有训练模型。这样才能区分系统优化、模型训练和一次好看的演示。
资料:MASS 官方方法说明 https://pub.sakana.ai/mass/