在生产业务中编写智能体工具调用时,格式修补很容易越堆越多。解析失败后,补括号、截取正文,再请模型重试,都在为同一个接口契约付费。
约束解码把一部分约束移到生成过程里。需要分清它能管住输出结构,业务判断和网络故障还得另行处理。
格式修补与接口契约的缺口
提示词可以要求只返回 JSON,却不是解析器的证明。输出可能混入说明文字,也可能在长度限制处被截断。
用正则截取第一对大括号,还会遇到嵌套对象和字符串里的括号。文本能被解析,也不代表字段类型或业务含义正确。
如果推理引擎支持结构约束,就可以提前限制输出。应用层仍应校验完整响应和业务字段,避免把语法合法当成任务成功。
采样前的语法掩码与状态推进
XGrammar 的流程从目标语法开始。编译器处理 JSON Schema 或上下文无关文法,匹配器保存已经生成的前缀状态。
每一步,模型给出候选 token 的 logits。匹配器计算哪些 token 合法,把非法候选的 logits 置为负无穷;softmax 后这些候选的概率为零,再从剩余候选中采样。
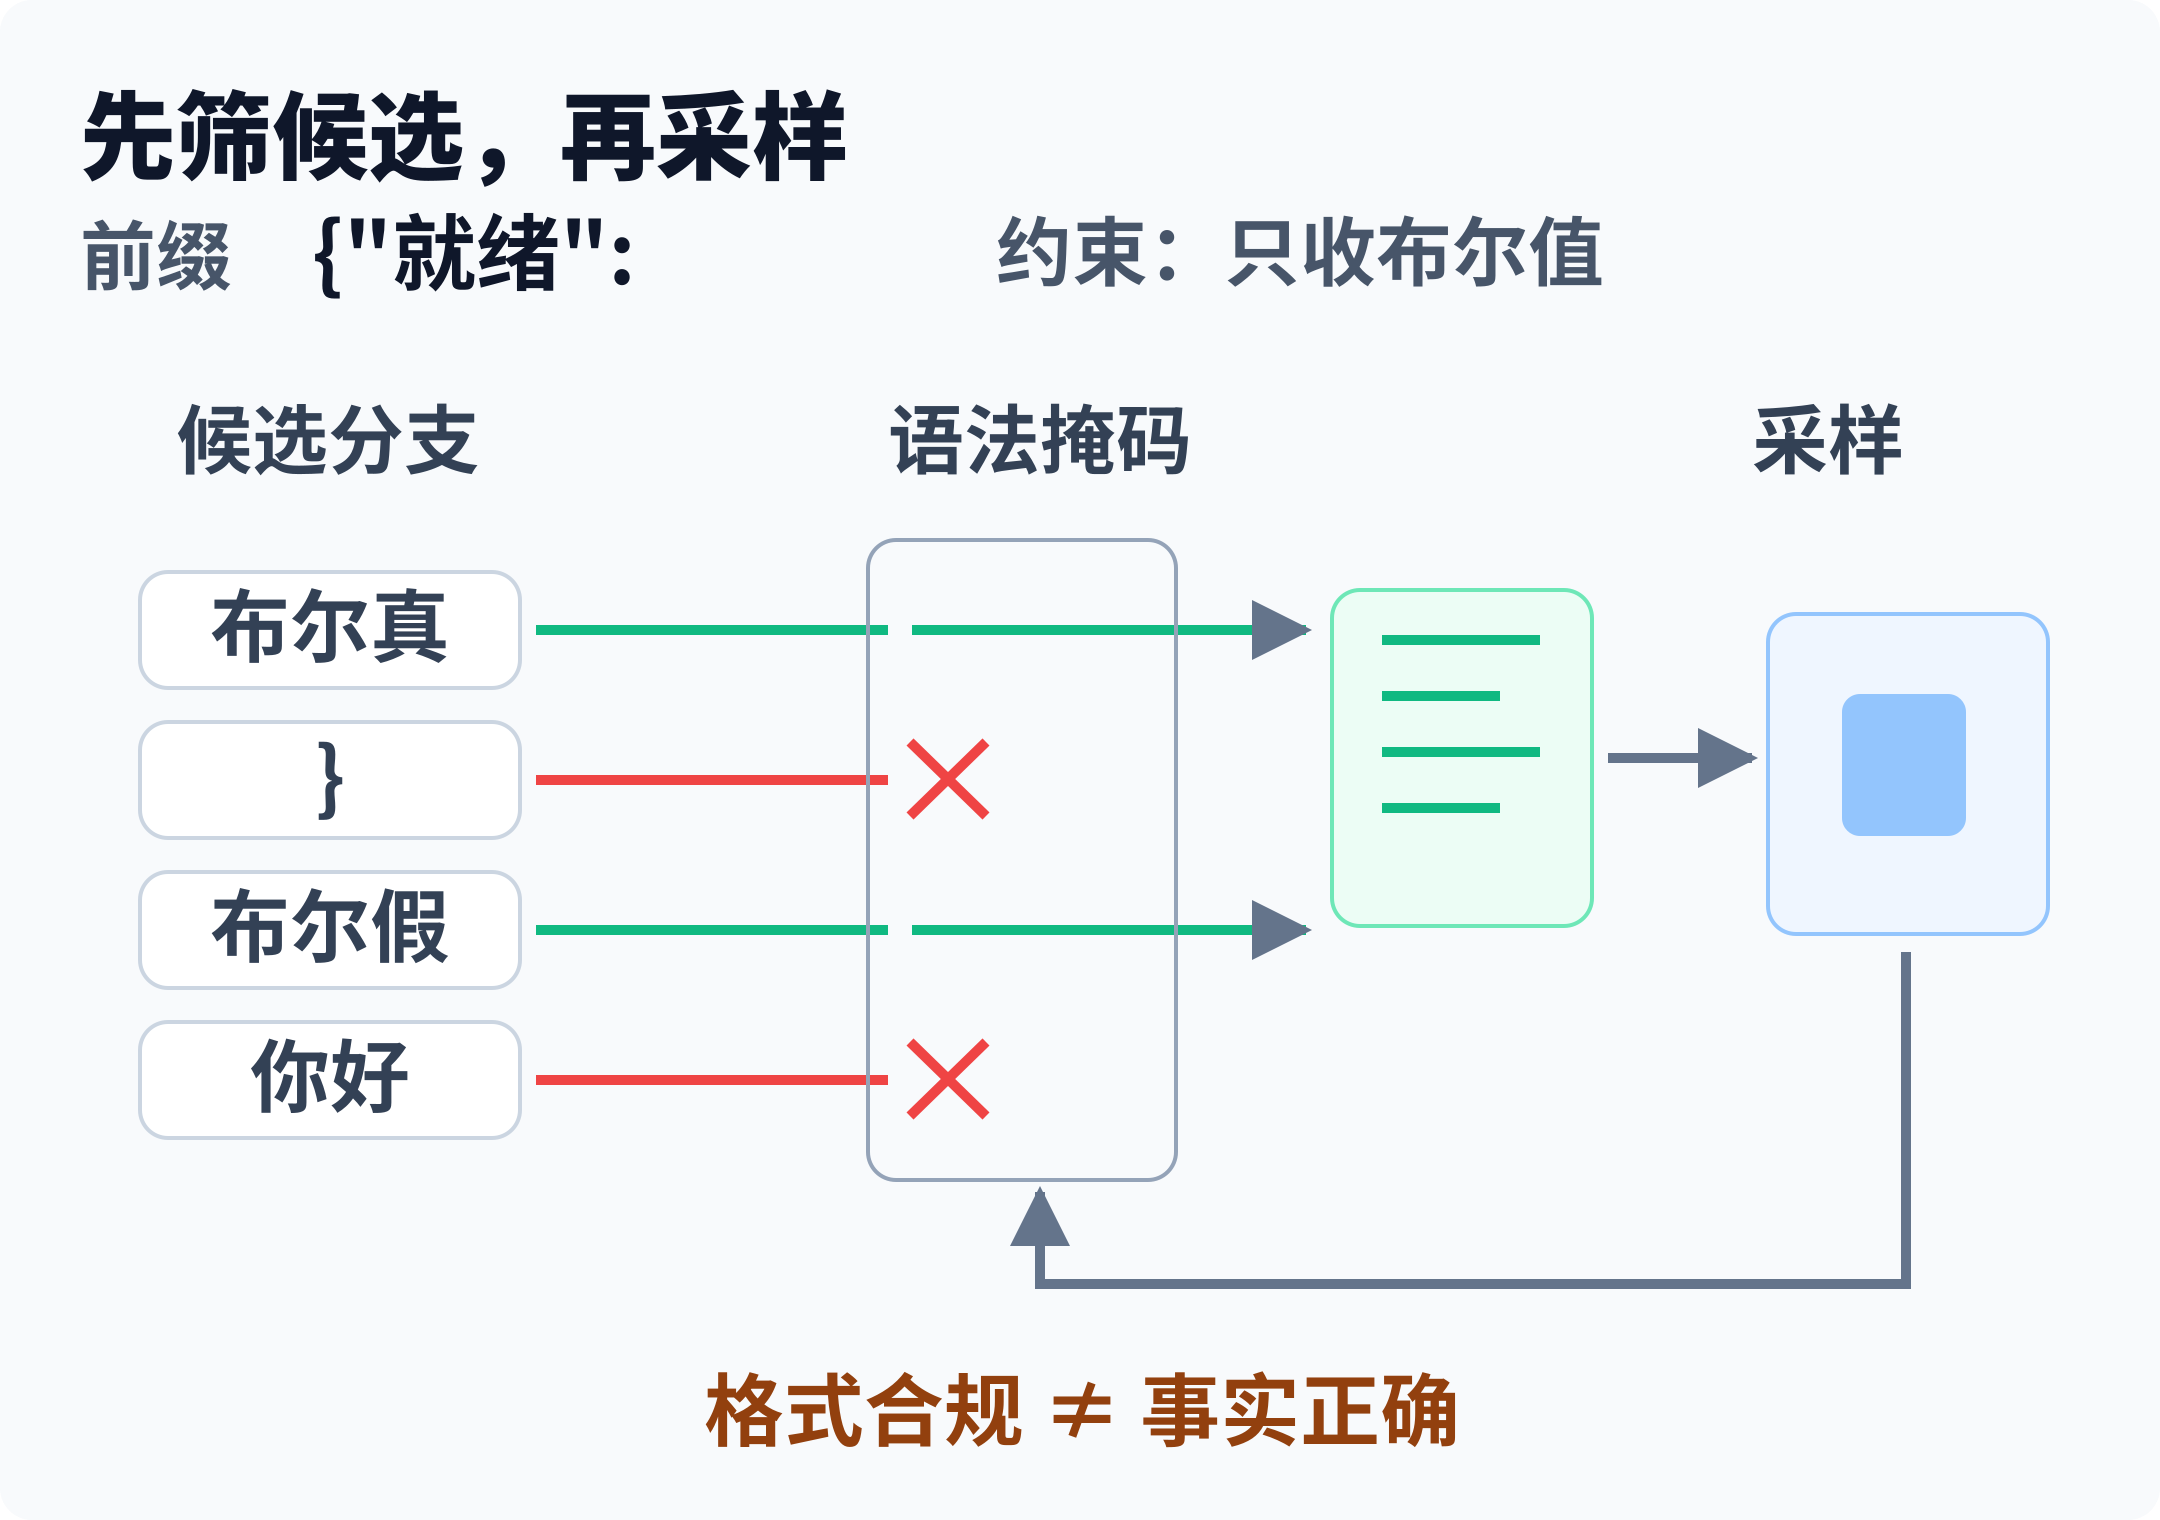
图用一个只接收布尔值的字段作简化示意。“布尔真”和“布尔假”表示合法值方向,实际掩码作用在词表 token 上,具体切分由分词器决定。回箭头表示消费已选 token,再推进匹配状态。
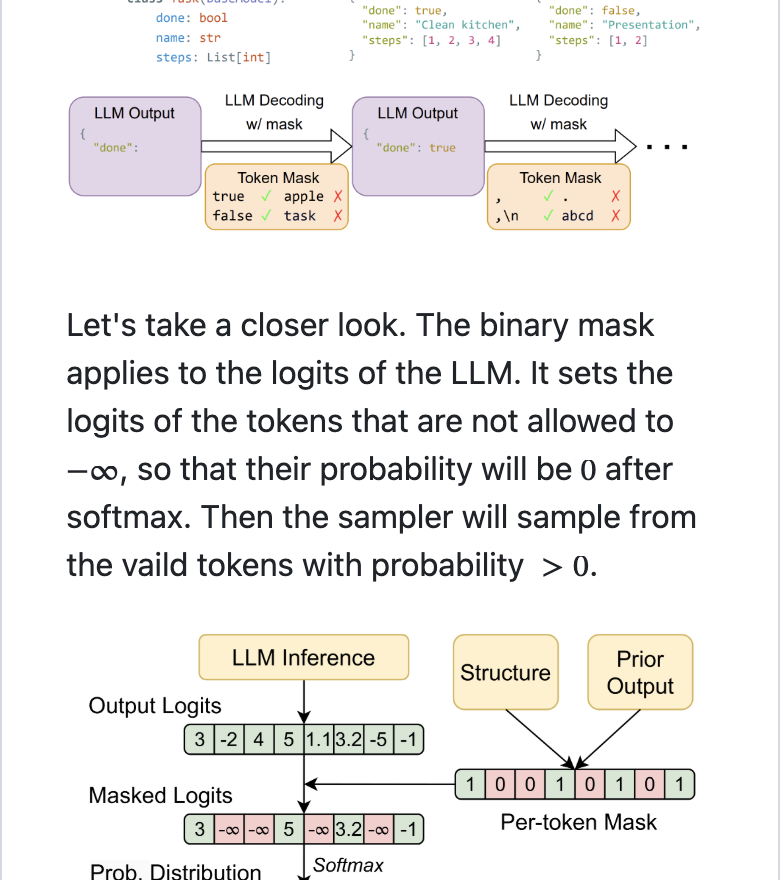
图为 XGrammar 官方文档网页实拍。它把掩码放在采样阶段,并明确描述非法 logits 的处理。原始页面 https://github.com/mlc-ai/xgrammar/blob/main/docs/start/constrained_decoding.md
这里的“状态机”是运行状态的泛称。任意递归的上下文无关文法不能都由有限状态机表示,XGrammar 的匹配器使用带回溯的下推自动机,包含处理嵌套所需的栈。
结构约束与业务可靠性的边界
合法的 JSON,可以包含错误的结论、过期的价格,甚至不存在的资源。
约束解码也无法保证网络请求成功。超时、拒绝、生成中断,以及不支持的 schema,都需要保留各自的处理路径。
合理的分工是让解码器约束结构,让应用校验业务含义,让传输层处理可恢复故障。能删除的是为格式错误反复打补丁的胶水,不是所有重试与降级代码。
没有针对自己的负载做测试,就不能承诺固定的耗时降幅或缓存命中率。先确认引擎支持哪些约束,再用真实失败样本检查这条边界。
资料:XGrammar 实现说明 https://github.com/mlc-ai/xgrammar/blob/main/docs/start/constrained_decoding.md
匹配器与下推自动机 https://xgrammar.mlc.ai/docs/latest/api/python/grammar_matcher.html