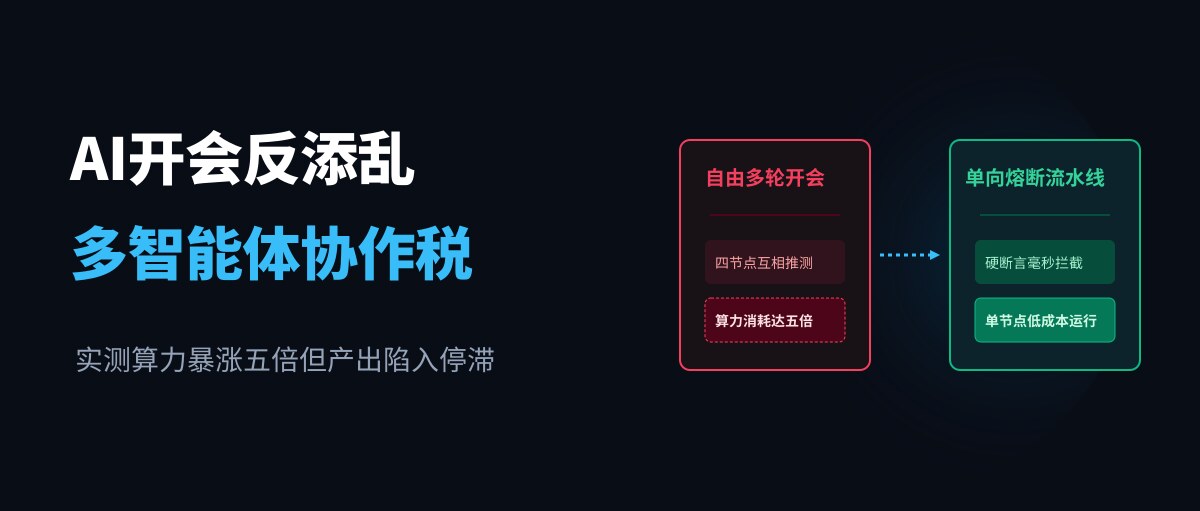
为了提升复杂软件工程的交付质量,不少研发团队尝试在系统中模拟真实的软件开发小组。
工程流程被细分成明确的职能角色。需求分析由产品经理智能体负责,系统架构由架构师智能体推导,业务逻辑由编码智能体撰写,缺陷排查由测试智能体兜底。多个智能体在同一个会话网络中频繁交互,彼此审查方案并确认细节。
终端里的消息往来密集穿梭,看似分工完备的协同机制却在实际落地中遭遇了惨烈的效率反转。
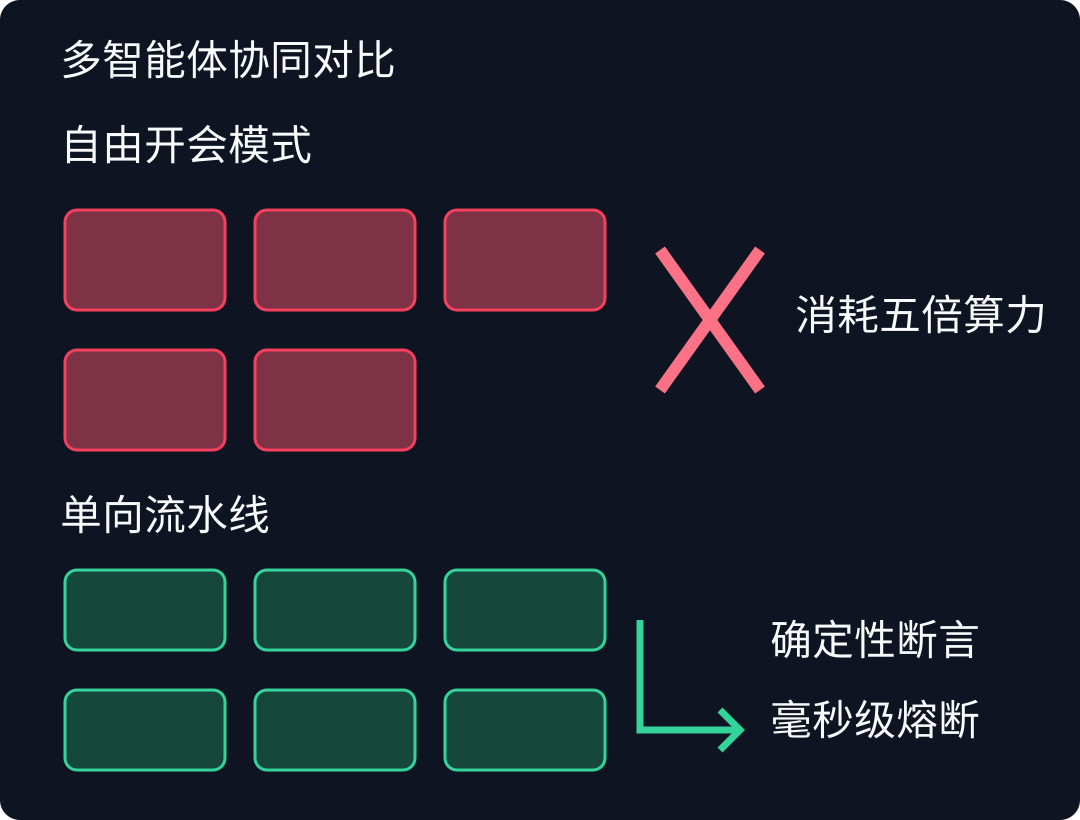
多智能体团队模式让推理开销暴涨五倍
针对前沿大模型的最新受控评测,揭开了多智能体协同模式的真实算力账单。
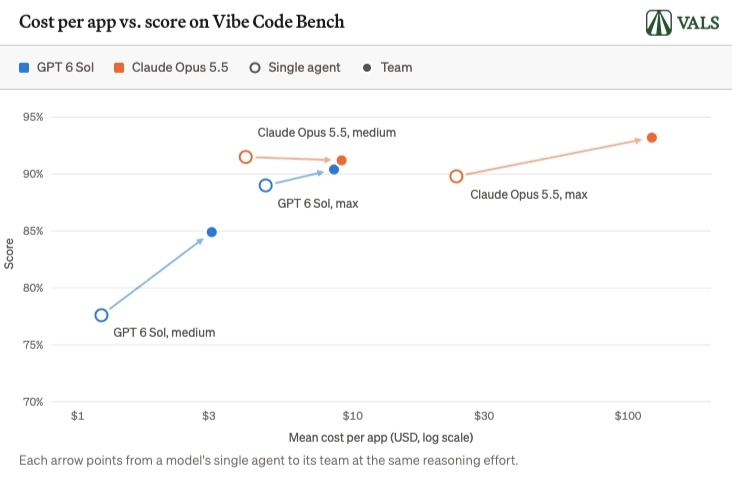
Vals AI 受控评测结果:团队模式算力开销暴涨至 5.1 倍,但在综合编码与架构任务中整体得分与单智能体持平(Vibe Code Bench 实测)。
在针对软件工程与算法逻辑的大规模对照实验中,测试团队分别部署了单智能体独立工作模式与四智能体协同模式。任务涵盖了全流程代码重构、跨模块接口适配以及复杂边界测试生成。
统计数据显示,四个智能体组成的工作组在完成同等规格的任务时,推理字词元开销飙升至单智能体的五点一倍。原本单次调用即可结项的局部修改,在团队模式下演变成了旷日持久的群聊循环。
算力账单呈指数级膨胀的同时,工程交付的成果却几乎停滞不前。
在四项严苛的综合编程基准测试中,多智能体协同模式仅仅在其中一项获得了不到百分之三的微弱优势。而在其余三项测试中,团队模式的代码通过率与单智能体完全持平,部分复杂逻辑题目的得分甚至出现了倒退。
给概率模型配备更多聊天对象并不会消除幻觉,只会让上下文在无限客套中迅速膨胀。
自然语言相互推测引发语义熵增与责任真空
人月神话中关于沟通成本的经典论断,在概率模型之间以更剧烈的方式重演。
当系统引入四个并行的智能体时,节点之间的潜在通信连接数量呈现平方级增长。人类工程师开会沟通存在物理世界的常识兜底,而大语言模型的每一次生成都建立在概率采样之上。
一个概率模型基于另一个概率模型给出的推测继续展开推测,语义偏差在传递链路中被逐级放大。
研发人员调取多轮对话日志后发现,智能体之间频繁陷入无意义的虚假共识。架构师智能体在概要设计中声明了模块边界,编码智能体在自然语言中承诺会严格落实,测试智能体则根据两者的描述推导出了看似完备的测试计划。
各个节点在文本层面互相确认,却没有任何一个节点在底层代码中真正编写防御性判断。
这种现象造成了严重的责任扩散。每个智能体都在假设下游角色会弥补当前步骤的缺陷,最终交付的代码依然充斥着低级的空指针与变量未定义异常。自由讨论的对话机制,把本该严谨的工程实现稀释成了模糊的自然语言空转。
单向确定性流水线在断言失败时立即熔断
解决多智能体协同税的成熟路径,绝非让模型之间开展更充分的讨论,而是彻底取缔横向闲聊。
工业级研发流水线正在转向严格单向推进的有向无环图架构。上游生成的产物以只读数据流的形式传递给下游,执行链路禁止出现任何未经受控的自然语言回环。
真正的工程约束来自本地编译器的物理断言,而不是让另一个大模型在对话框里充当阅卷人。
在每一个专职节点之间,系统不再安排智能体进行主观评审,而是直接接入本地确定性工具链。
编码节点完成修改后,底层守护进程立即调用编译器、类型检查器与静态语法分析工具。如果代码出现语法报错或类型不匹配,流水线在毫秒级时间内就地拦截熔断,并向模型回传纯粹的错误堆栈。
只有当确定性门禁全量亮起绿灯,任务才会流入下一个阶段。用严格的物理断言替代模型的口头保证,多智能体系统才能真正走出算力黑洞,实现稳定可控的工程交付。