在人工智能研发的第一线,一场看不见硝烟的底层攻防战刚刚公布了战报。
许多技术团队在调用带有长思考链的前沿大模型时,都对那段隐藏在幕后的推理过程充满好奇。为了复现顶级模型的复杂逻辑,一些团队开始采用自动化流水线发起针对性探针。
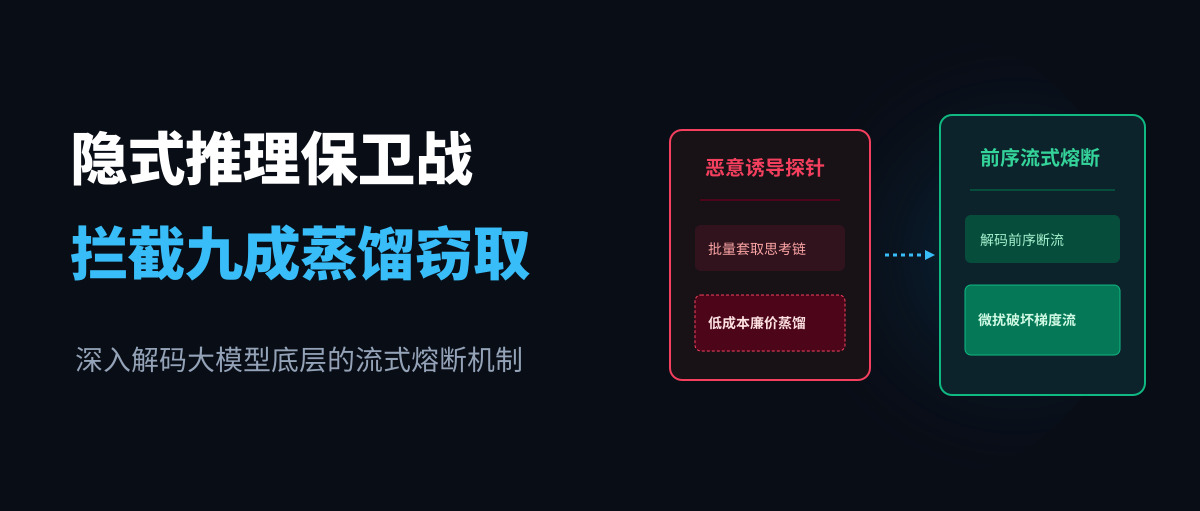
它们通过精心设计的诱导提示词,批量诱骗模型在响应中吐出原本隐藏的思维链条。拿到这些高质量的推理数据后,攻击方以极低成本对自己的开源小模型进行监督微调,企图在几天内“复制”出同等智力的模型。
Anthropic 在最新披露的技术报告中指出,经过底层工程重构,这类工业级思考链窃取攻击已经被压降了 90% 到 99%,平台累计封禁了数万个用于自动化采样的恶意账号。
这场防线突破并不是依靠法务诉讼,而是来自推理引擎底层的物理拦截。
隐式思考链成为工业级蒸馏的目标
训练一个具备高阶推理能力的基座模型,往往需要消耗数千万美元的算力与数月的强化学习探索。
在这套体系中,模型在最终作答前生成的中间推理序列,是其最核心的技术资产。每一个中间步骤都在推导因果逻辑,排除错误分支。
对于想要弯道超车的追赶者而言,直接向商业接口发起成千上万次批量请求,是最廉价的逆向工程手段。
攻击方会编写高度结构化的探针指令,强行要求模型复述其思考路径。黑灰产账号利用并发请求,日夜不停地抓取这些带有高密度逻辑的中间数据。
只要收集到几十万条带有完整推导链路的问答对,下游模型就能通过监督微调迅速习得相似的解题思路。
如果放任这种行为蔓延,领先厂商在预训练和对齐阶段积累的护城河,将在几周内被逆向蒸馏蚕食殆尽。
传统后置审核根本拦不住批量探针
面对这种规模化采集,很多厂商的第一反应是加强输出内容的安全过滤。
然而在工业级对抗场景下,传统的后置安全检查完全落入了被动挨打的死局。
如果等到模型自回归生成完整段落后再去匹配敏感词,整个推理计算的 GPU 资源已经被白白消耗殆尽。
更致命的是,批量探针会通过编码加密、暗语混淆或分段诱导来规避关键词匹配。当审核模块在完整文本中试图判定语义时,API 早已将流式数据分片返回给了客户端。
大模型之间的竞争,已经从单纯的刷榜比拼演进为底层推理流的攻防截断战。
如果防御机制不能深入到 Token 生成的物理时序中,所有的应用层策略都只是隔靴搔痒。
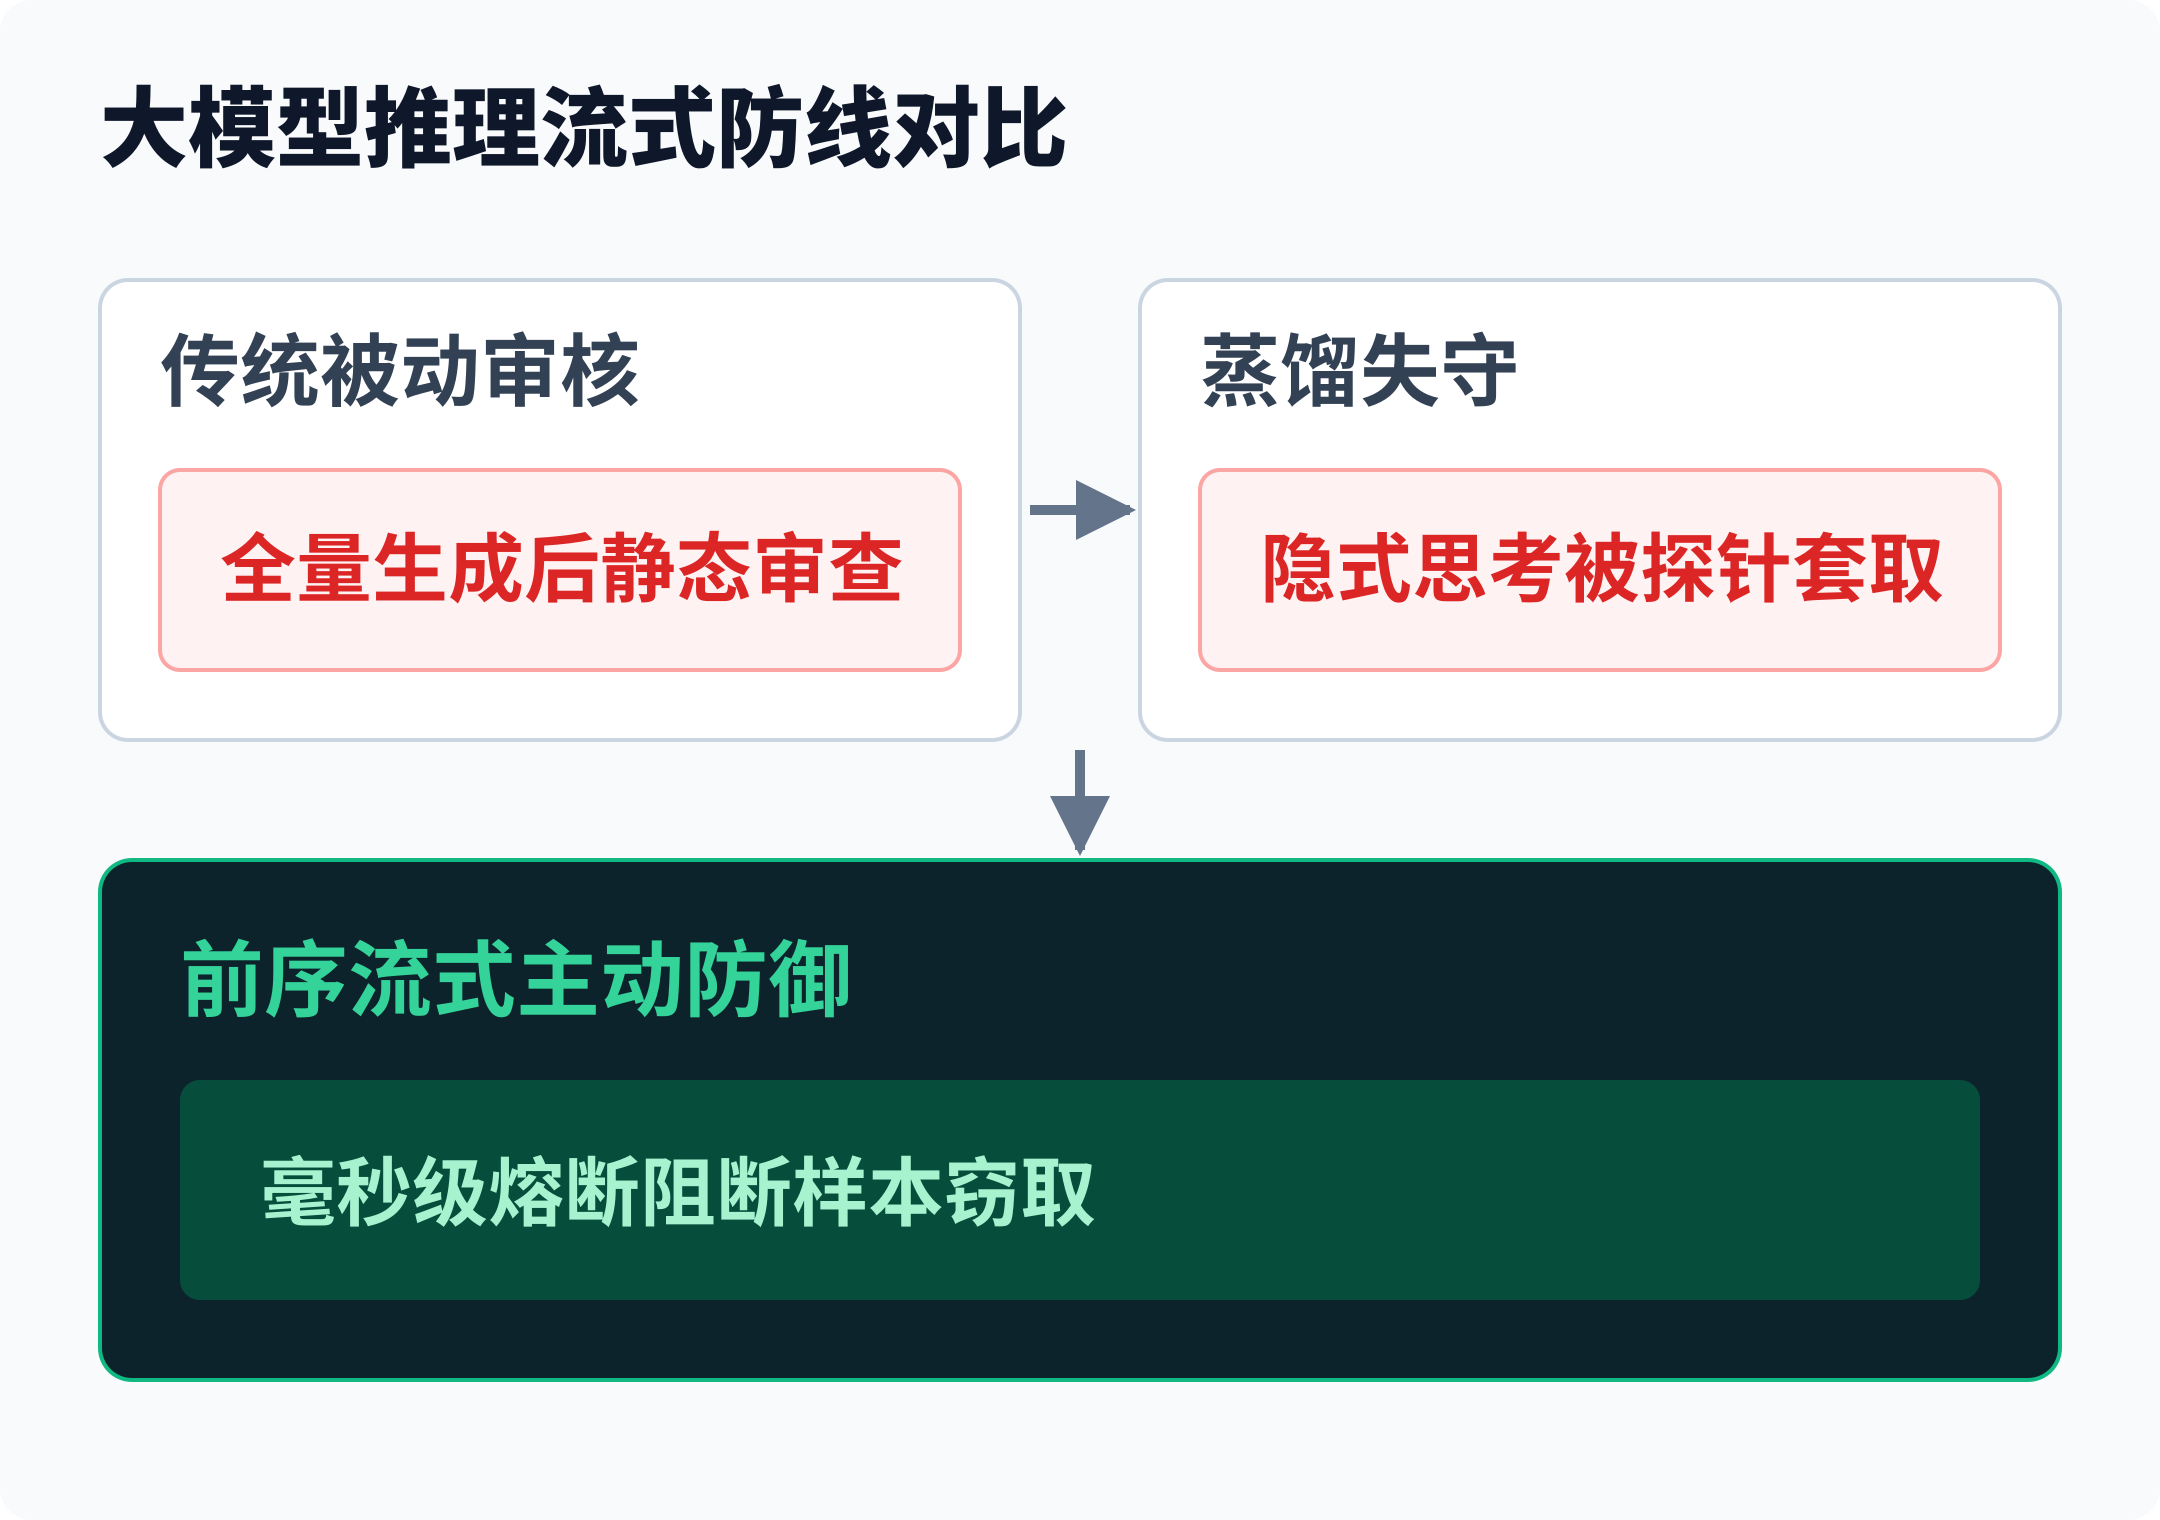
图展示了恶意批量蒸馏探针与底层前序熔断机制的对抗拓扑。传统架构在生成完成后由外部模块拦截,耗费大量算力且容易漏网;新防线在自回归解码前三十个步长内计算输出分布熵,一旦识别出逆向诱导特征即刻物理切断连接,并在关键节点加入微扰彻底破坏下游训练集的梯度收敛。
概率流微扰与前序熔断彻底破坏样本
Anthropic 能够削减 99% 思考链窃取的关键,在于将安全断言直接注入自回归生成的解码循环。
第一道防线建立在前序步长的提前终止机制上。
在模型开始解码的前 10 到 30 个 Token 阶段,轻量级探针会实时监测当前词表输出的概率分布特征与语义信息熵。正常用户的业务提问与自动化蒸馏脚本在解码树形态上存在明显的物理差异。
一旦发现输出序列带有典型的逆向诱导特征,推理网关在几十毫秒内直接切断 TCP 连接,提前终止后续计算。黑灰产不仅拿不到数据,还浪费了一次 API 握手成本。
第二道防线则是精妙的概率流微扰与毒化机制。
对于那些处于模糊边界的探针请求,防御系统不会直接粗暴拒绝,而是在流式吐字的关键节点对非主干候选词的 Logits 分布施加细微扰动。
这些微小扰动完全不影响人类读者的正常阅读理解,但当下游攻击方把这些数据喂给小模型进行微调时,原本高度一致的梯度流会发生不可预测的剧烈震荡,最终导致小模型训练崩溃。
配合在数据流中嵌入的不可伪造数学水印,风控系统能够在数分钟内关联出背后的整个代理 IP 池,并一揽子吊销数万个僵尸调用账号。
当大模型走入深水区,工程防护早已不再是简单的文本替换,而是深入矩阵底层的流式断流演进。
资料:The Decoder 技术报道 https://the-decoder.com/anthropic-says-it-cut-claude-reasoning-token-theft-by-up-to-99-in-fight-against-industrial-scale-distillation/