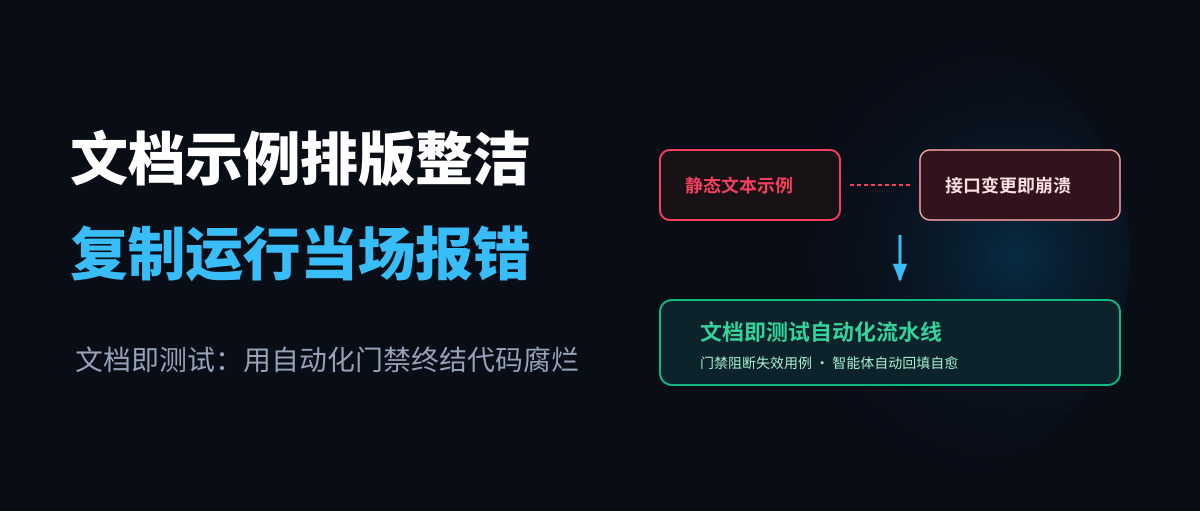
在日常研发工作中,许多工程师都经历过这样的狼狈时刻。
为了接入一个新组件,开发者打开官方文档或团队内部的维基页面。文档里的示例代码排版整洁,步骤清晰。
开发者满怀信心地把代码块复制到本地编辑器,敲下运行命令。控制台没有吐出预期结果,而是瞬间喷出一大片红色的报错堆栈。
仔细比对调用链后才发现,底层的依赖库在两周前重构了核心方法,原有的初始化参数早已废弃。然而文档里的文字还停留在半年前的旧版本。
复制文档代码到终端当场报错崩溃
这种尴尬并不是个例。在技术团队的日常维护中,文档代码腐烂几乎是一种必然发生的物理规律。
根据工程团队的抽样统计,一个拥有数百页使用指南的成熟开源库,如果三个月没有专人维护,其中能直接跑通的示例代码往往不足 60%。
当外部开发者按照指南调用接口时,近一半的人会在第一次执行时遭遇入参不匹配或缺少模块报错。
业务代码有单元测试守护,有持续集成流水线层层设卡。但写在静态文本里的示例代码,长期处于无人监管的盲区。
工程师在提交功能代码的修改时,注意力全在业务逻辑和单测覆盖率上。除非有人刻意提醒,否则极少有人主动想起去更新深层目录里的说明文档。
静态字符一旦落进文本编辑器,它的生命周期就与真实代码彻底脱钩了。
静态文本无法抵御动态代码的演进
问题的根本原因,在于文档中的代码缺乏运行时的物理约束。
很多团队尝试依靠制度解决问题。他们在代码审查清单里加上勾选项,要求每次修改 API 必须同步更新文档。
但在面对紧急上线或复杂排期时,人工审查的防线极易失守。一个原本需要三个入参的方法缩减为一个,业务调用全改了,文档里的旧代码依然岿然不动。
静态排版的 Markdown 文件本质上只是渲染给人类眼睛看的一张静态画卷。编译器不会检查它的语法,运行环境也不会执行它的逻辑。
哪怕里面的函数名拼写错误,或者调用了根本不存在的全局变量,静态语法分析器也不会触发任何告警。
任何没被自动化测试校验过的文档代码,本质上都是随时会炸掉的假代码。
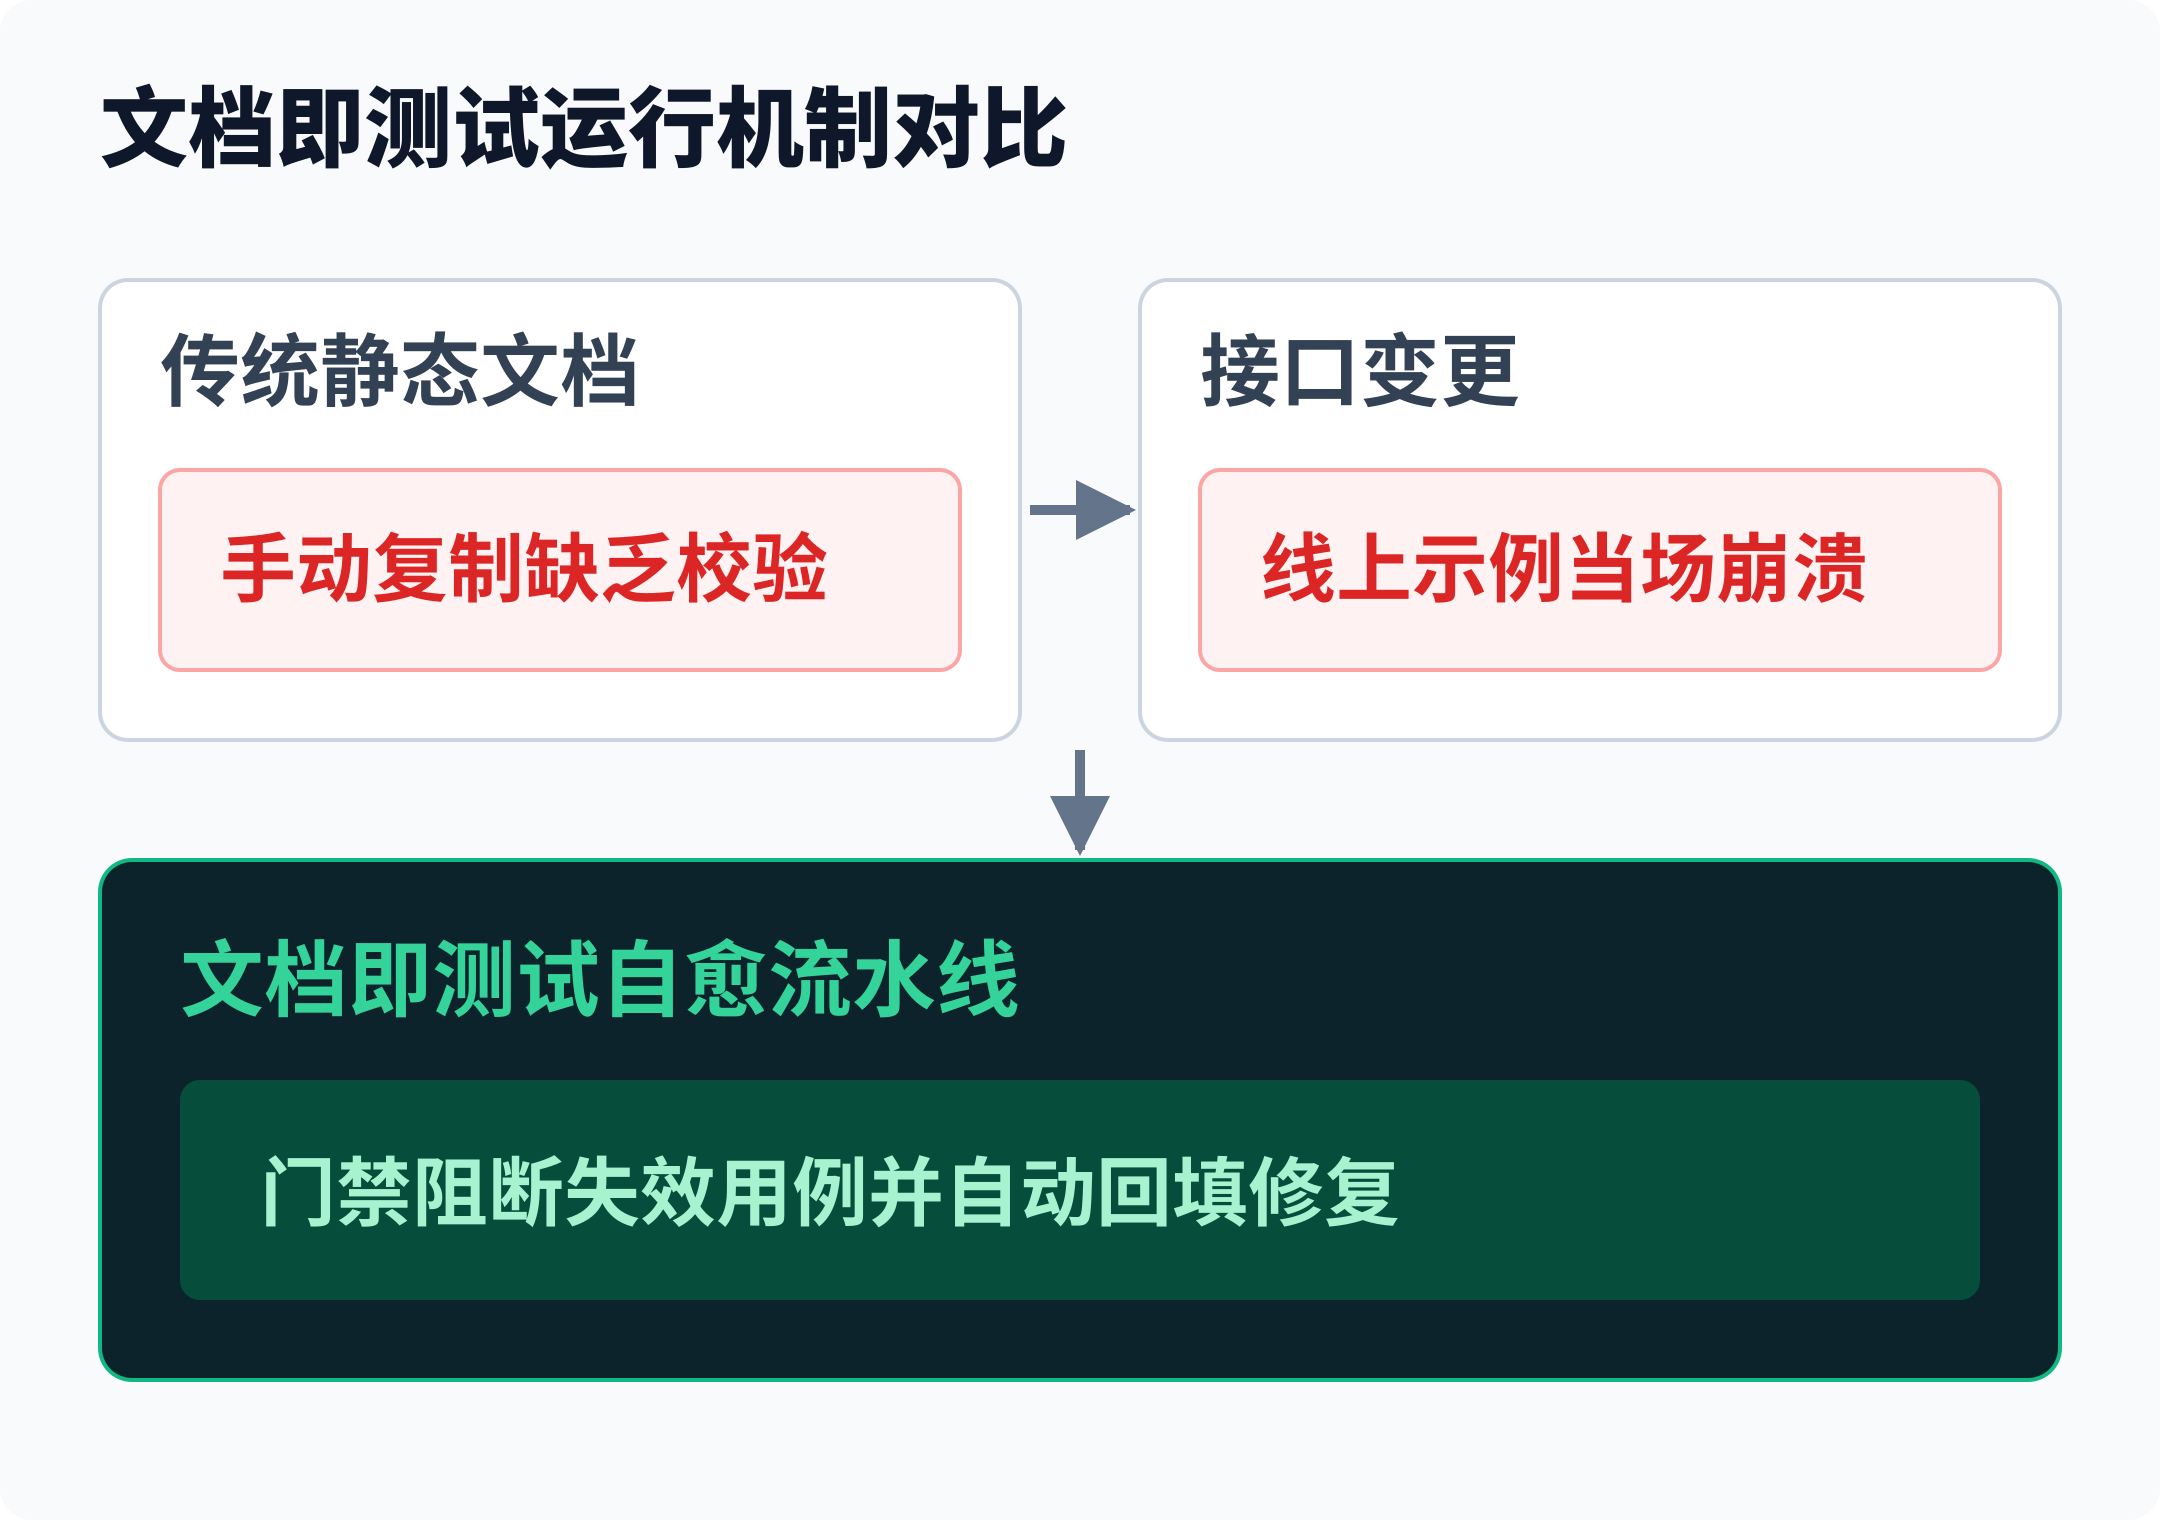
图展示了传统手写示例代码与文档即测试架构的差异。传统模式下文档脱离 CI 独立存在,接口重构导致示例大面积失效;新架构通过工具将文档代码自动化解耦为独立测试用例,并在持续集成中挂载硬闸门,配合编码智能体在接口演进时自动完成代码修复与双向回填。
自动化提取用例把文档做进门禁
为了从根源上终结文档失效的恶性循环,LangChain 团队近期在工程重构中推行了一套文档自愈方案。
他们不再允许开发者在文档中凭空书写未经检验的代码段落。
工程团队利用 Deep Agents CLI 等工具,遍历整个仓库的文档目录。程序自动解析所有 Markdown 代码块,将其抽离并重构为可以在沙盒中独立运行的真实单元测试。
这些提取出的代码文件被统一纳入持续集成的测试套件中。
在每一次代码提交和合并请求阶段,持续集成系统不仅运行核心业务单测,还会强制执行所有文档测试用例。
一旦某个底层接口的重构导致文档里的示例无法运行,流水线会在入口处直接报错并物理熔断。测试不通过的改动永远无法合入主干分支。
当底层接口发生计划内的变更时,团队还可以唤起编码智能体,读取最新的接口定义,自动修补报错的示例代码,并将修正后的代码回填至说明文档中。
把文档当成测试来写,代码的每一次演进才不会以牺牲开发者的信任为代价。
资料:LangChain 官方技术复盘 https://www.langchain.com/blog/our-docs-test-themselves