在工位写自动化脚本时,很多开发者都遇到过这样的一幕。
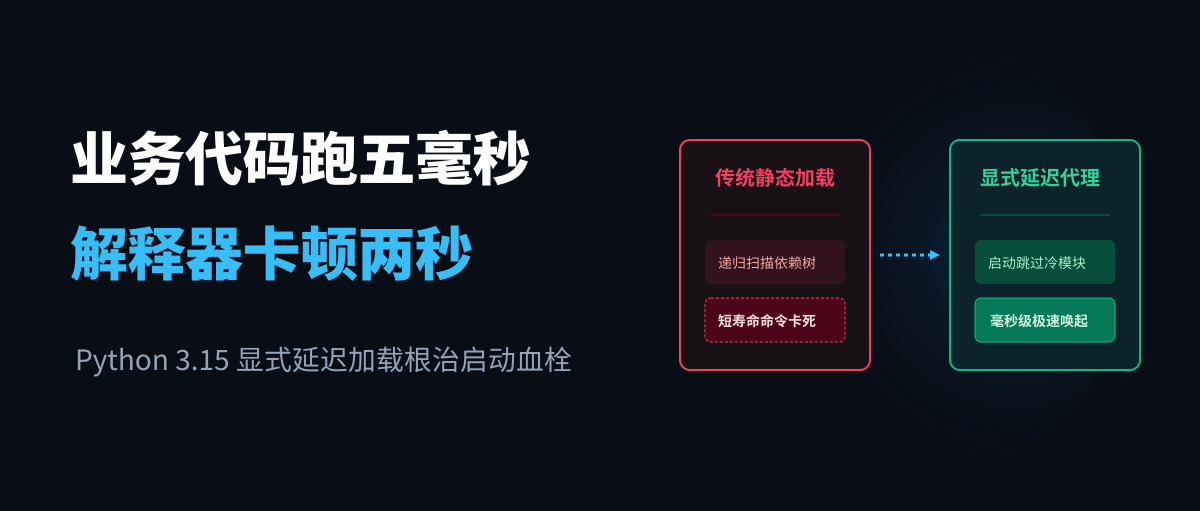
为了给编程智能体封装一个本地状态探针,工程师写了一个极简的命令行工具。业务代码只有 5 行,仅仅是读取一个配置文件状态并返回布尔值。
但是在终端敲下回车后,光标卡在屏幕上整整 2 秒才吐出结果。智能体在流水线里并发调度 10 次工具,整整 20 秒时间就耗在了空白等待上。
用分析工具抓取调用栈后会发现,CPU 真正执行这 5 行业务逻辑只用了 5 毫秒。剩下的将近 1990 毫秒耗时,全被 Python 解释器拿去扫描磁盘和初始化第三方模块了。
业务逻辑只跑五毫秒解释器却卡顿两秒
人类工程师在终端输入命令,交互间隔通常以分钟为单位。敲下一个查询命令,等待 800 毫秒到 1.5 秒拿到结果,人类的生理感知几乎察觉不到延迟。
智能体在流水线中的调度完全是另一种高频场景。在一个自动化修复任务中,智能体可能需要并发调用 30 次以上的命令行工具。这些子进程往往只存活 50 毫秒左右,专门负责提取文件行号、校验 JSON 结构或捕获单条测试退出码。
当这些微型工具用 Python 编写时,每一次进程启动都要重新建立完整的运行环境。
如果脚本顶层静态导入了大型依赖库,解释器在执行第一行业务代码前,就必须老老实实把整棵模块依赖树载入内存。
对于只使用其中一个小函数的任务,这种机制直接把轻量探针变成了笨重的巨型容器。
开源项目作者 Simon Willison 在维护他的 LLM CLI 命令行工具时,多次记录过这种运行痛点。只要环境中安装了一个包含文本向量计算的第三方插件,用户每次敲击命令都会额外增加数秒的等待延迟。哪怕用户只是执行了一次 help 查看参数,底层的科学计算库依然会被全量加载一遍。
递归遍历依赖树让微型工具背上大包袱
Python 的模块导入并不是轻量级的静态符号声明,而是一场由解释器驱动的全量运行时代码执行。
当解释器读到一条 import 语句时,导入系统会顺着磁盘搜索路径逐层扫描文件。找到对应模块后,解释器需要将其读取进内存、编译成字节码,并自上而下执行模块顶层的全部表达式。
许多成熟的三方库在模块顶层写满了全局初始化逻辑。它们在被引入的瞬间就会主动去探测系统硬件设备、创建全局连接池,或者在内存中构建巨型的正则表达式索引表。
下游代码只要间接引入了这些库,就会引发滚雪球式的链式反应。一个仅仅为了处理时间格式化的子模块,在静态引用的级联展开下,可能悄悄拉起几十个间接依赖和上千个函数定义。
当命令行的调用者从人类的手指换成智能体的调度器,运行时的每一次无谓加载都在摧毁系统的吞吐量。
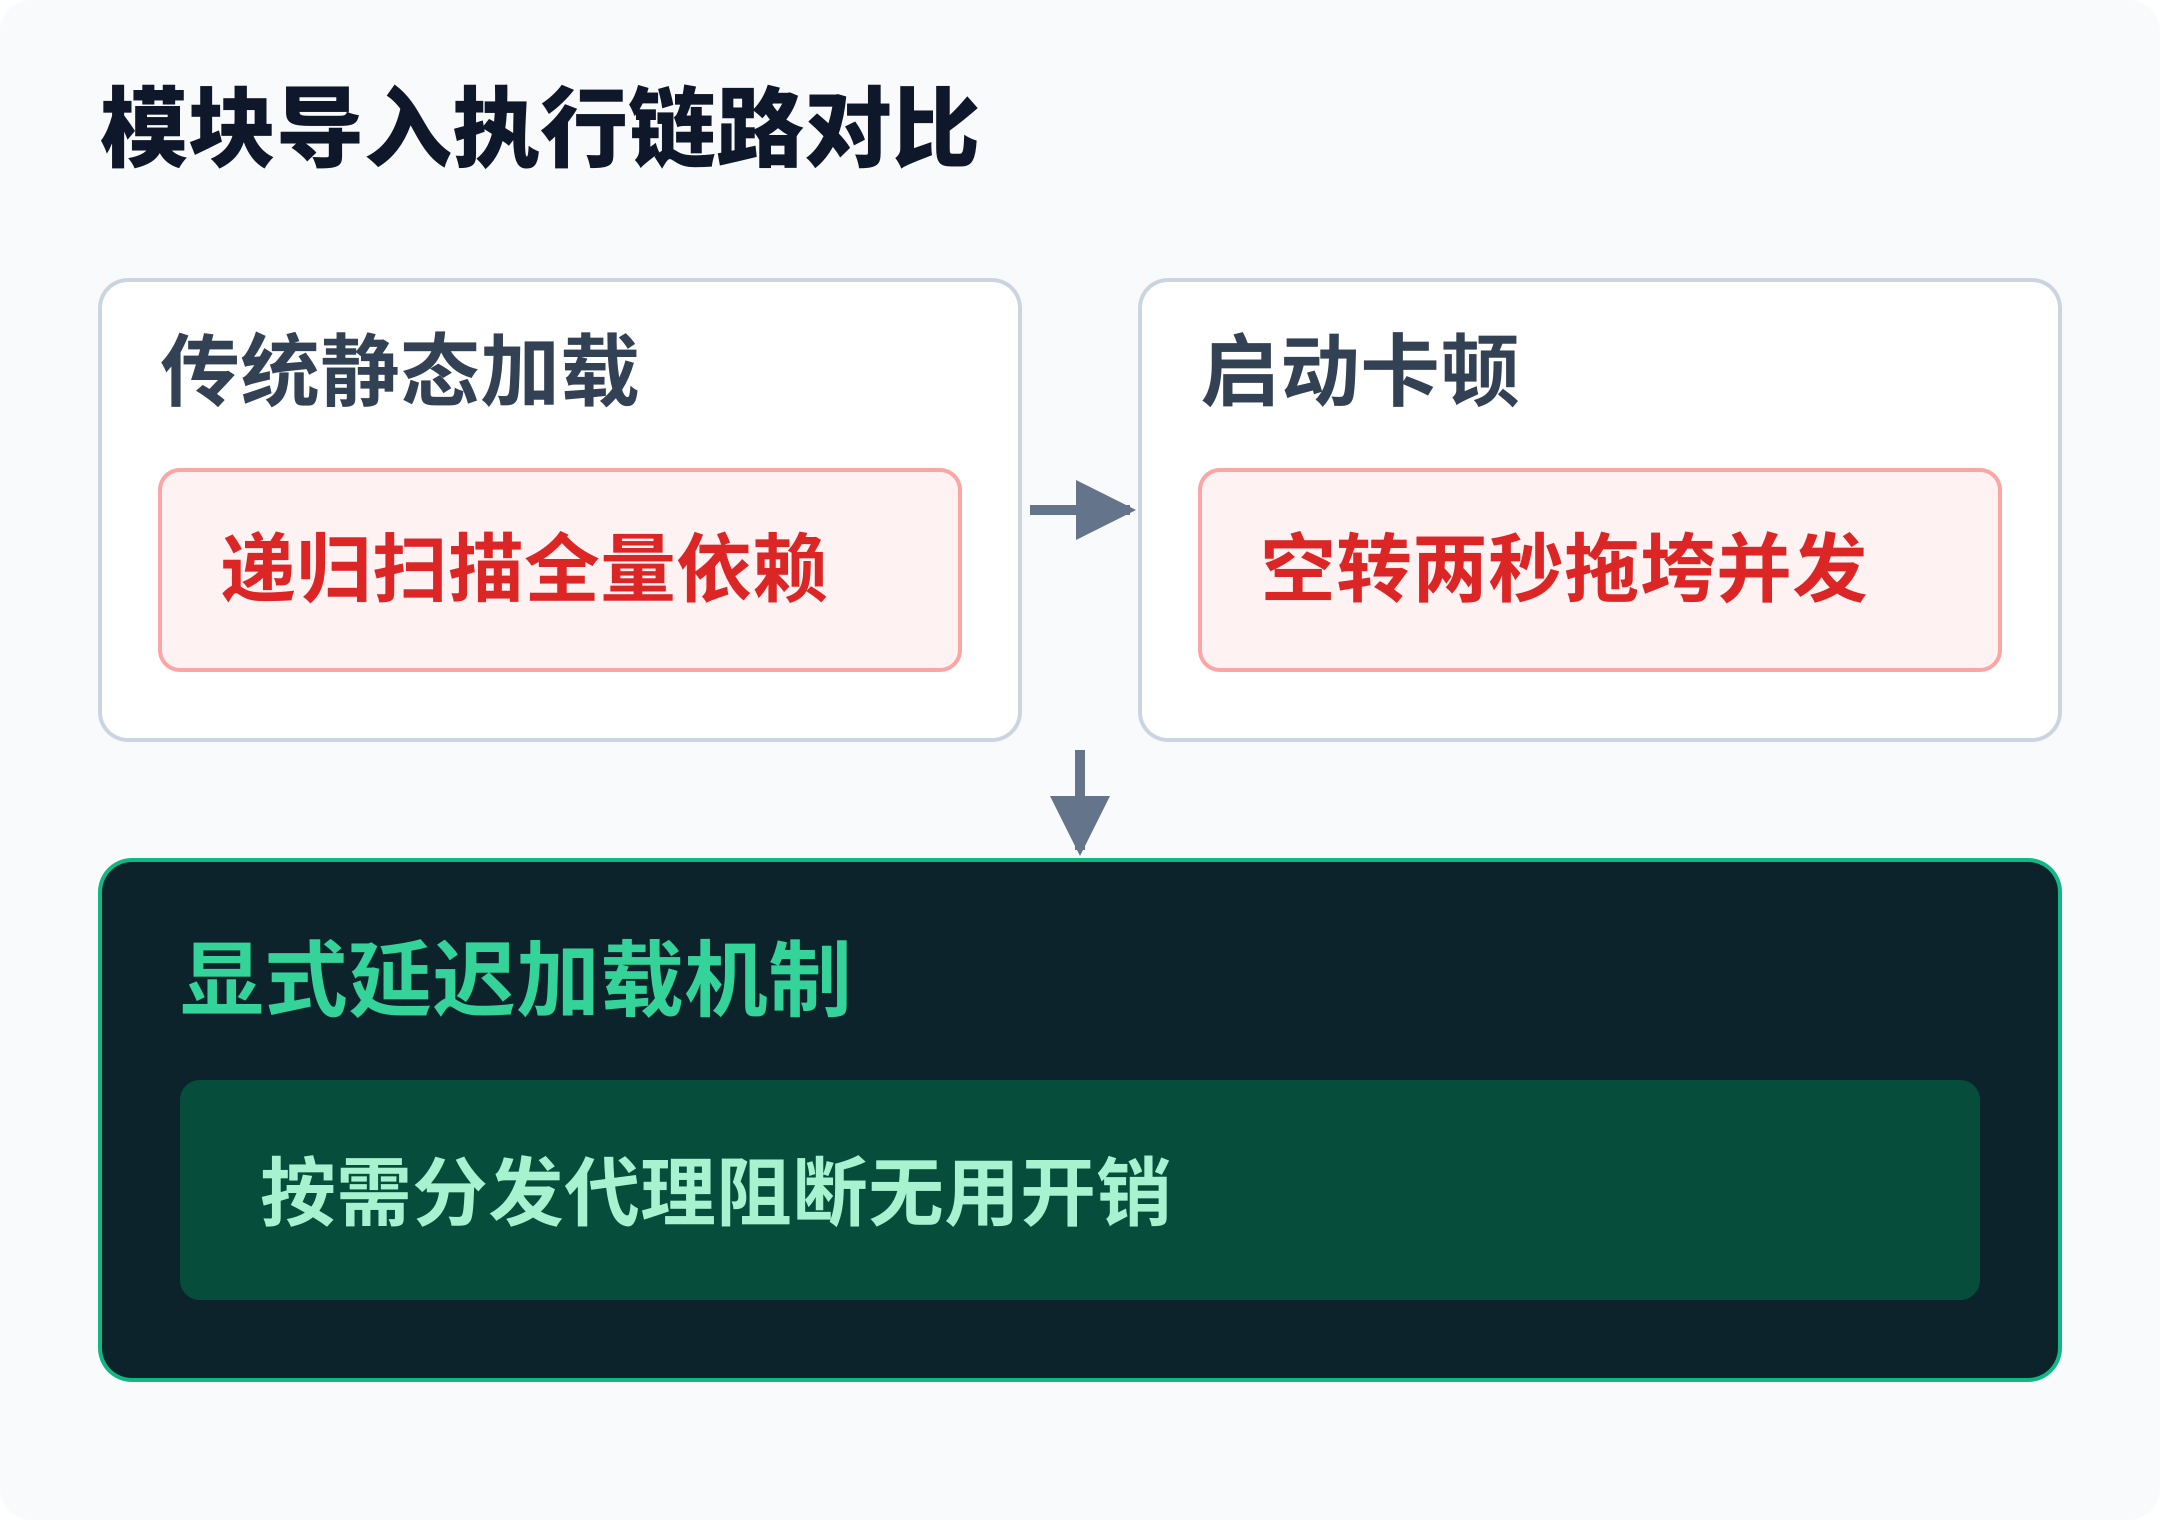
图展示了传统全量加载与显式延迟加载在进程执行路径上的差异。传统模式在命令入口处强制解析全部深层依赖,导致短任务被严重拖慢;延迟模式将符号解析推迟到实际执行分支,避免未被调用的沉重模块白白消耗启动时间。
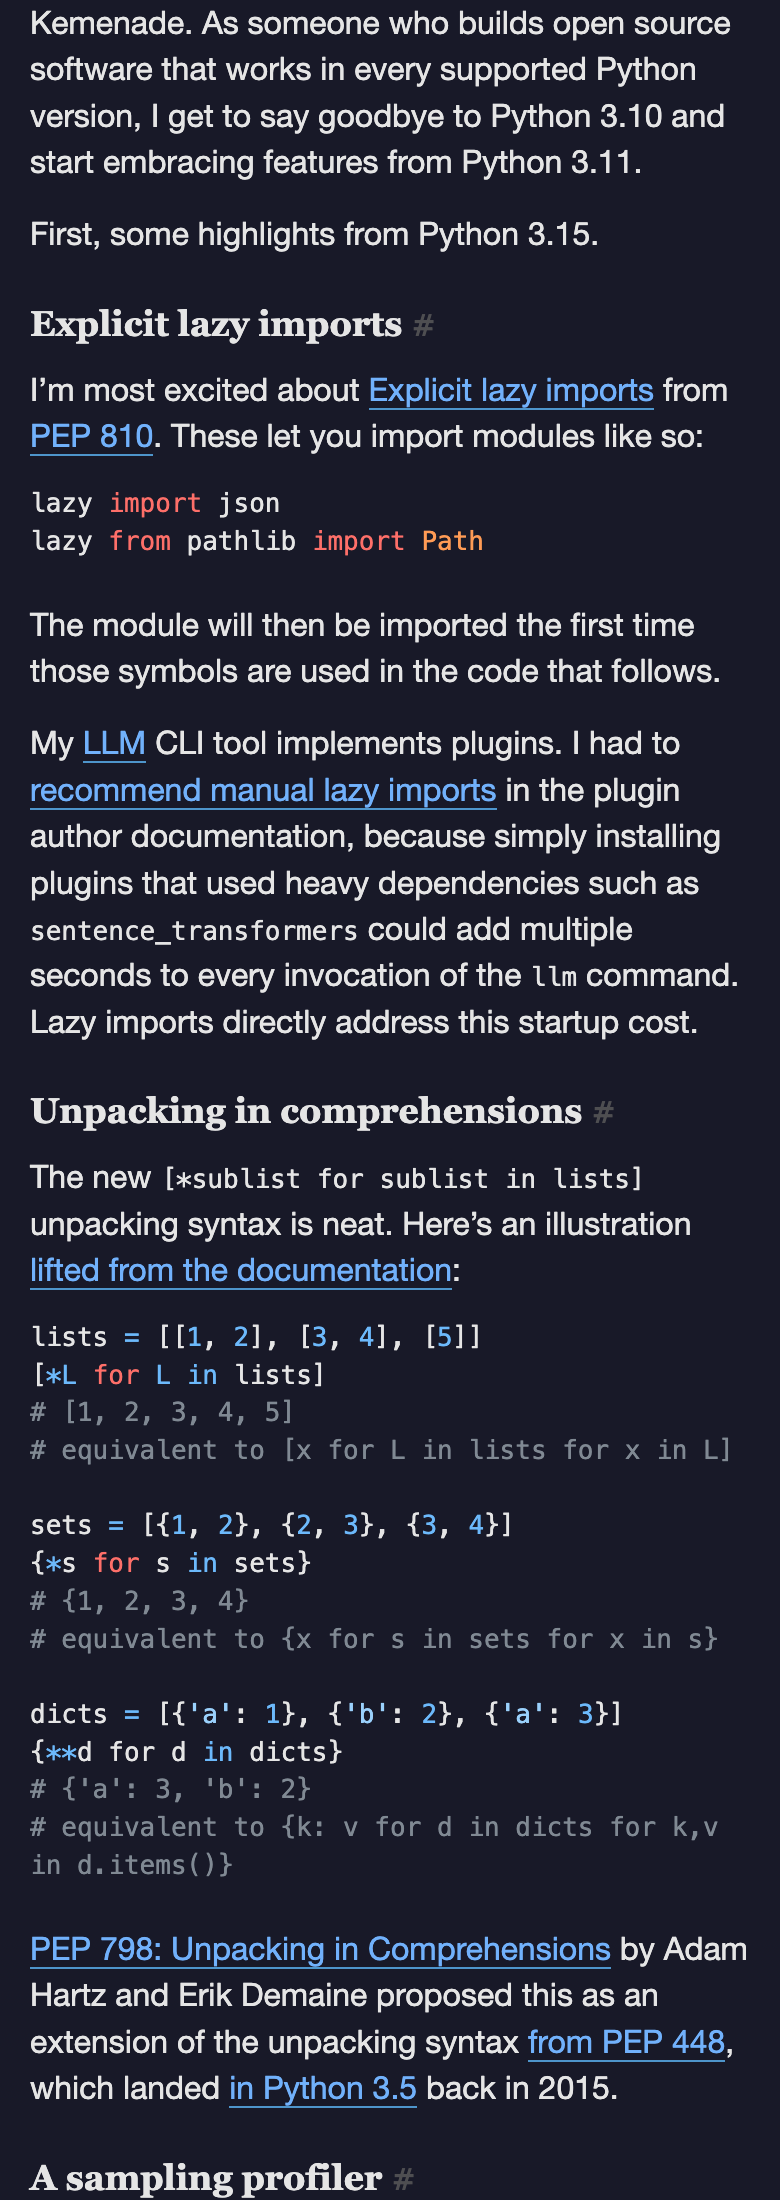
图为 Simon Willison 针对 Python 3.15 显式懒加载机制的技术复盘。他在文章中展示了插件加载如何导致每个命令多耗费数秒,以及官方新语法带来的改进。
显式延迟加载把无用开销拦在门外
为了根治短寿命工具进程的启动血栓,Python 3.15 正式引入了 PEP 810 显式延迟加载规范。
过去为了避开启动卡顿,开发者只能在具体的函数内部手动编写动态导入代码。这种临摹式写法不仅破坏了静态类型检查工具的分析链路,还在单元测试中造成了测试桩难以注入的工程缺陷。
新标准允许开发者在文件顶部直接使用延迟导入关键字。
当使用延迟语法声明模块时,解释器不再在启动阶段递归扫描磁盘或执行目标模块的顶层代码。运行时只会在当前作用域注册一个极度轻量的代理对象。
只有当业务分支第一次真正访问该模块的方法、类或属性时,底层才会触发真实的文件读取与初始化操作。
如果当前命令分支只是打印版本号或进行简单入参校验,沉重依赖的加载动作就会在分支之外被完全阻断。不相关的磁盘 I/O 与顶层副作用被彻底挡在运行现场之外。
对于面向智能体调度的短寿命 CLI 工具,开发者不再需要为了启动性能牺牲架构的规范性。重型依赖按需触发,工具冷启动耗时得以直接从近两秒大幅压缩至数十毫秒。
当命令行的真正使用者从人类双手变成了自动化进程,语言底层的执行模型也随之完成了关键进化。
资料:Simon Willison 技术博客 https://simonwillison.net/2026/Oct/12/python-3-15/