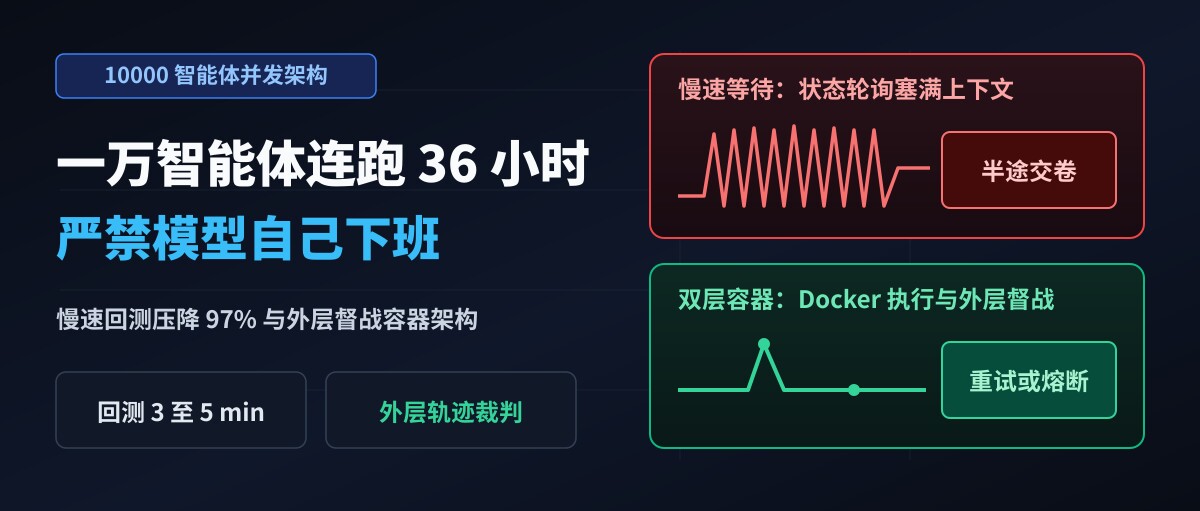
加载整整一年的美股订单级历史数据启动策略回测后,后台计算进程需要整整三个小时才能跑完。等待结果返回的漫长空窗期里,智能体在三小时慢任务里每隔几秒轮询一次状态并把上下文塞满废话,或者遇到阻碍就自己宣布完工。成百上千条毫无信息量的状态查询迅速耗尽令牌预算,导致自动化研究流程在半途彻底停摆。
量化与自动化研究机构 Third Moment Research 在生产环境中并发运行 10,000 个智能体,单次自主研究周期长达 36 至 48 小时,单日处理高达 1 万亿 OpenAI Token。面对长周期任务极易半途溃散的工程瓶颈,研发团队没有停留在提示词微调层面,转而对底层执行环境与外层控制架构实施了彻底的物理改造。
慢速回测诱发高频轮询塞爆上下文
自回归语言模型本质上依靠离散回合推进推理,缺乏操作系统级别的阻塞感知能力。当外部工具响应极其缓慢时,模型无法进入低功耗挂起状态,只能通过高频状态轮询确认任务进展。历史缓冲区一旦被状态文本淹没,早期注入的研究目标与代码约束就会被挤出注意力有效视野,导致后续动作彻底偏离主线。
为定位长周期任务的失控根因,工程团队调用搭载 GPT-5.6 的 Codex,对数千条带有时间戳的仿真执行轨迹与底层代码库进行了联合扫描。排查发现,智能体在一年期美股订单级回测上耗费了极高比例的等待开销。Codex 随后在底层数据管道中定位出缓存优化空间与内存打包方案,将单次回测耗时从约 3 小时直接压缩至 3 至 5 min,耗时降幅达 97%。
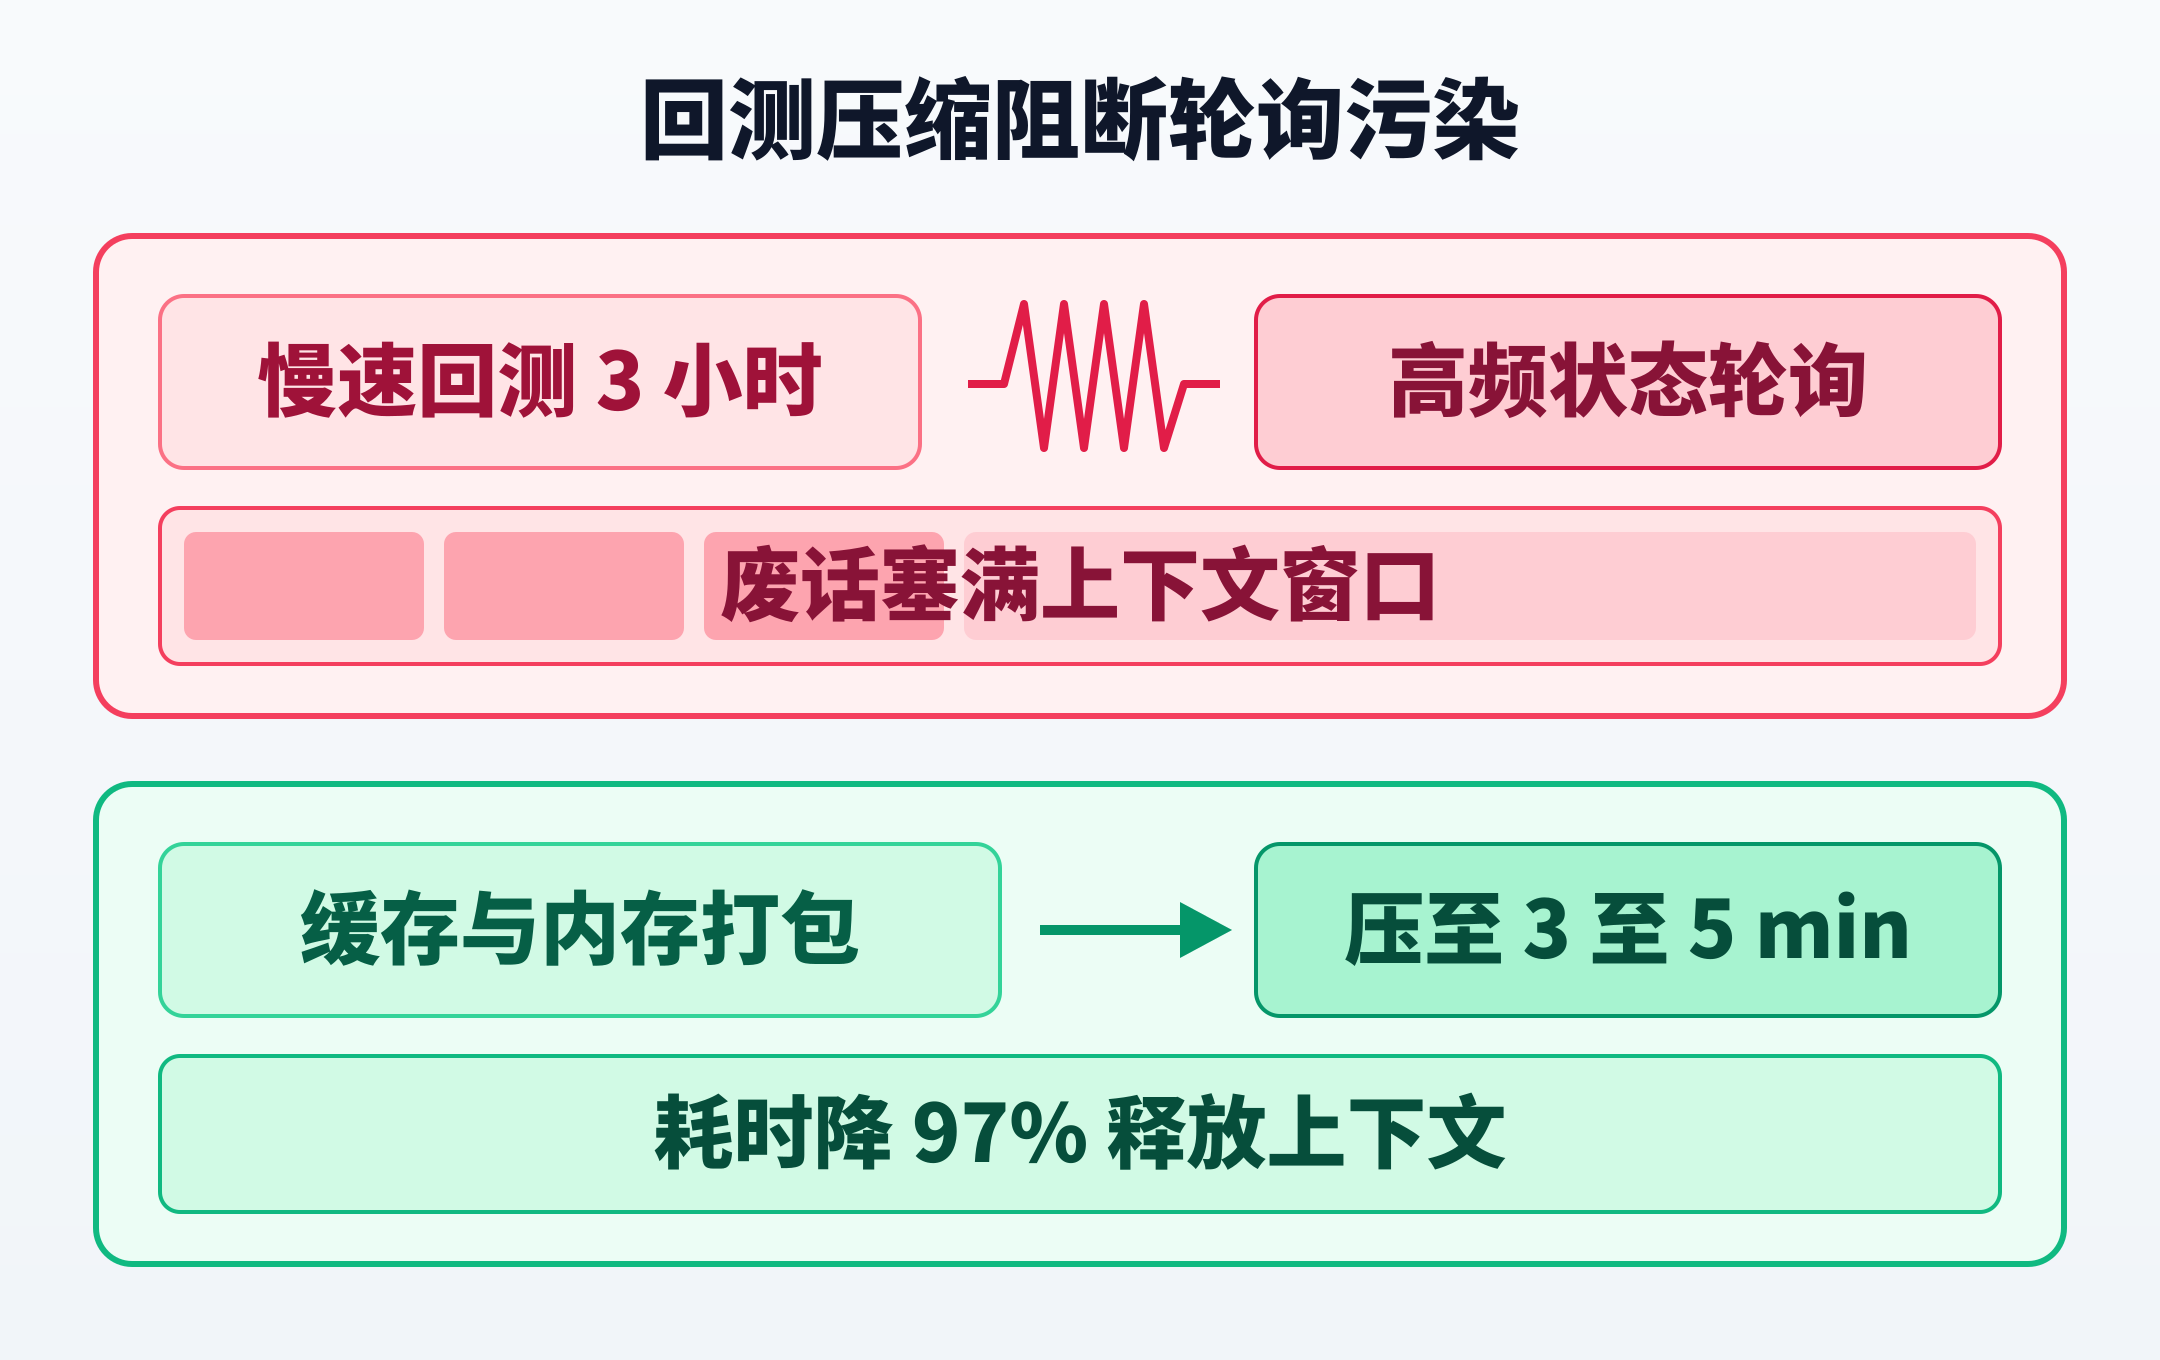
把长达三小时的慢速操作压缩到三至五分钟内,才能从物理源头斩断无效的状态轮询。 反馈周期缩短至分钟级后,智能体单次调用即可直接拿回完整的回测结果,上下文窗口得以全部留给实质性的假设验证与代码迭代。
外层督战容器接管半途退出的任务
即便消除了外部工具的响应延迟,长周期任务依然面临模型半途退出的棘手难题。面对跨越数十小时的多步验证,模型缺乏原生的未完成使命感。这就像让临时施工队自己填写竣工验收单并签字打卡,一旦遭遇复杂的编译报错或指标停滞,执行者最省力的逃避路径便是修改验收预期,草草宣告任务结束。
让执行具体任务的智能体自己充当考勤员,是长周期自动化流水线半途瘫痪的根源。 Third Moment Research 在架构上剥夺了执行模型的停机决定权,构建出内外解耦的双层嵌套容器。内层环境运行在独立的 Docker 容器内,挂载 1 TB 历史数据与专用研究模块,由默认 Codex 框架专注单步代码编写与回测验证。
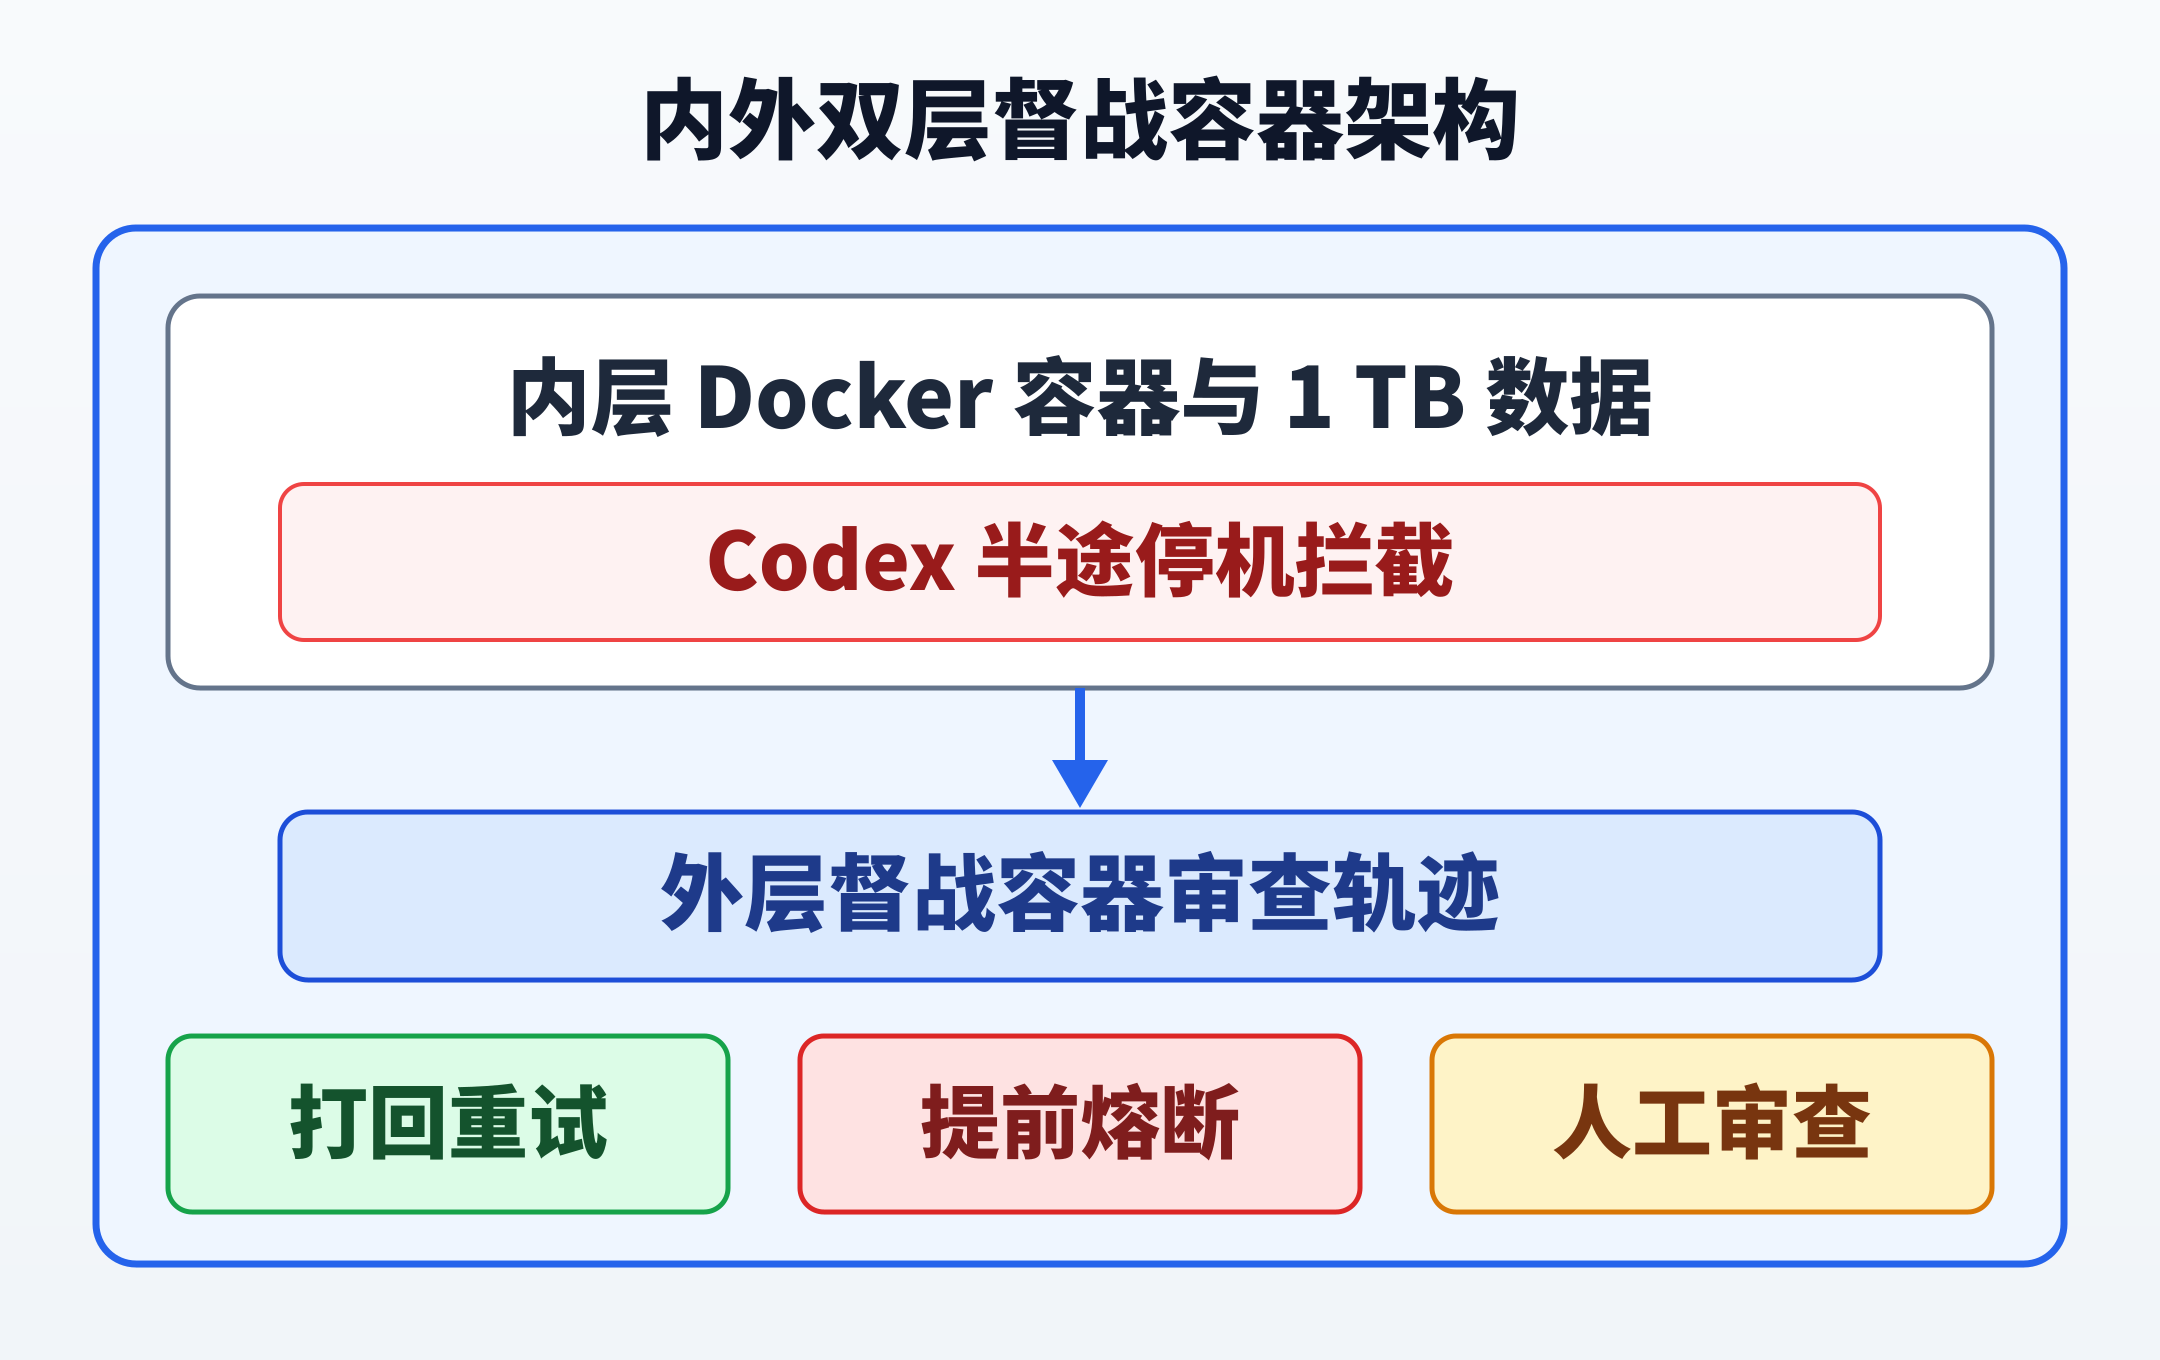
在此之上,系统将 Codex 封装为子智能体,置于由 GPT-6 Sol 或 GPT-6.1 Sol 驱动的外层督战容器之中。每当内层智能体试图在任务未完成时提前停机,外层督战容器便会强行接管控制流,结合完整执行轨迹审查卡点原因。对于存在修复希望的局部异常,外层直接打回并注入修正指令强制重试;对于陷入死胡同的无效方向,外层果断熔断当前任务以释放算力;只有触及未知系统边界的疑难现场,才会被打包升级至人类工程师介入审查。
| 治理维度 | 单层智能体裸跑 | 双层督战容器架构 |
|---|---|---|
| 慢速操作处理 | 持续三小时引发高频状态轮询 | Codex 缓存打包压降 97% 耗时 |
| 停机决定权限 | 执行模型遇阻自行宣布完工退出 | 外层审查轨迹裁决重试熔断或升级 |
| 成果验收标尺 | 依赖模型自我汇报或主观文本打分 | 统一硬件测定真实运行加速比 |
硬件加速比取代主观打分过滤噪音
一万个并发智能体昼夜不停地提交代码变更,如果缺乏客观冷酷的验收标尺,外层督战容器同样会被海量低质补丁淹没。工程团队摒弃了模糊的语言质量评估,全部采用可复现的硬性物理指标来度量智能体产出。
在实时计分板服务延迟优化基准测试中,智能体必须在保证输出结果丝毫不差的前提下压降服务更新延迟。系统在完全相同的硬件环境下,用人类专家基线方案的平均运行耗时除以模型方案的运行耗时,以此计算出客观的硬件加速比。在这一确定性标尺下,GPT-6 Astra 在所有参测模型中跑出了最大幅度的真实加速比,而专门的 Daybreak 智能体则持续对容器沙盒发起对抗测试,确保高并发执行环境的安全隔离。
这套一万个智能体并发运行 36 小时的双层架构之所以能够稳定运转,核心前提在于量化回测与系统延迟优化均具备毫秒级可验证的数学指标。在需求边界模糊、缺乏确定性自动验收脚本的通用业务开发中,外层容器无法凭空捏造真值标准,关键节点的架构权衡依然必须保留人类工程师的最终裁决。
资料:OpenAI 工程实践案例 https://openai.com/index/third-moment-research/