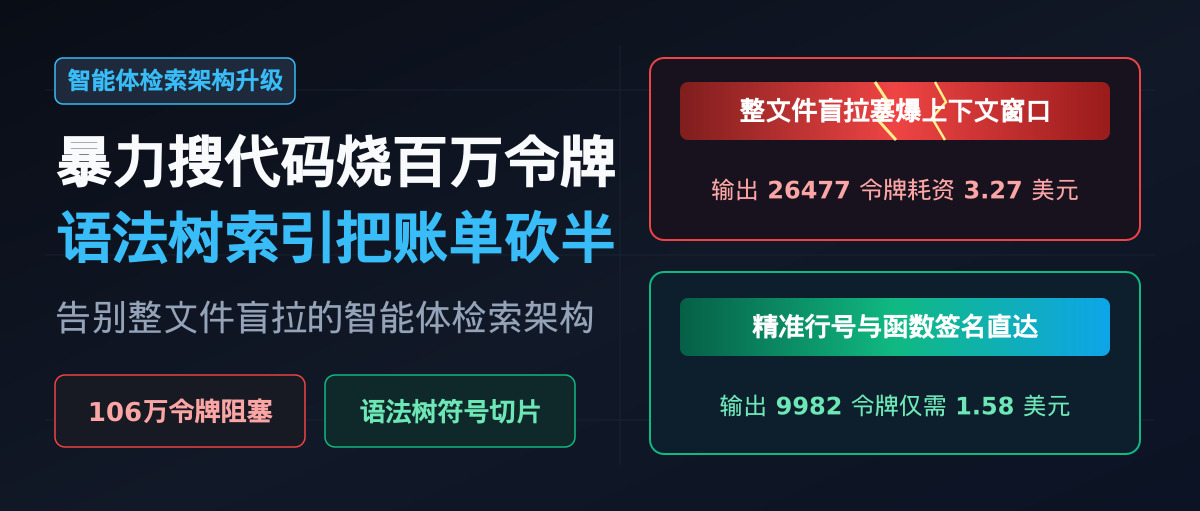
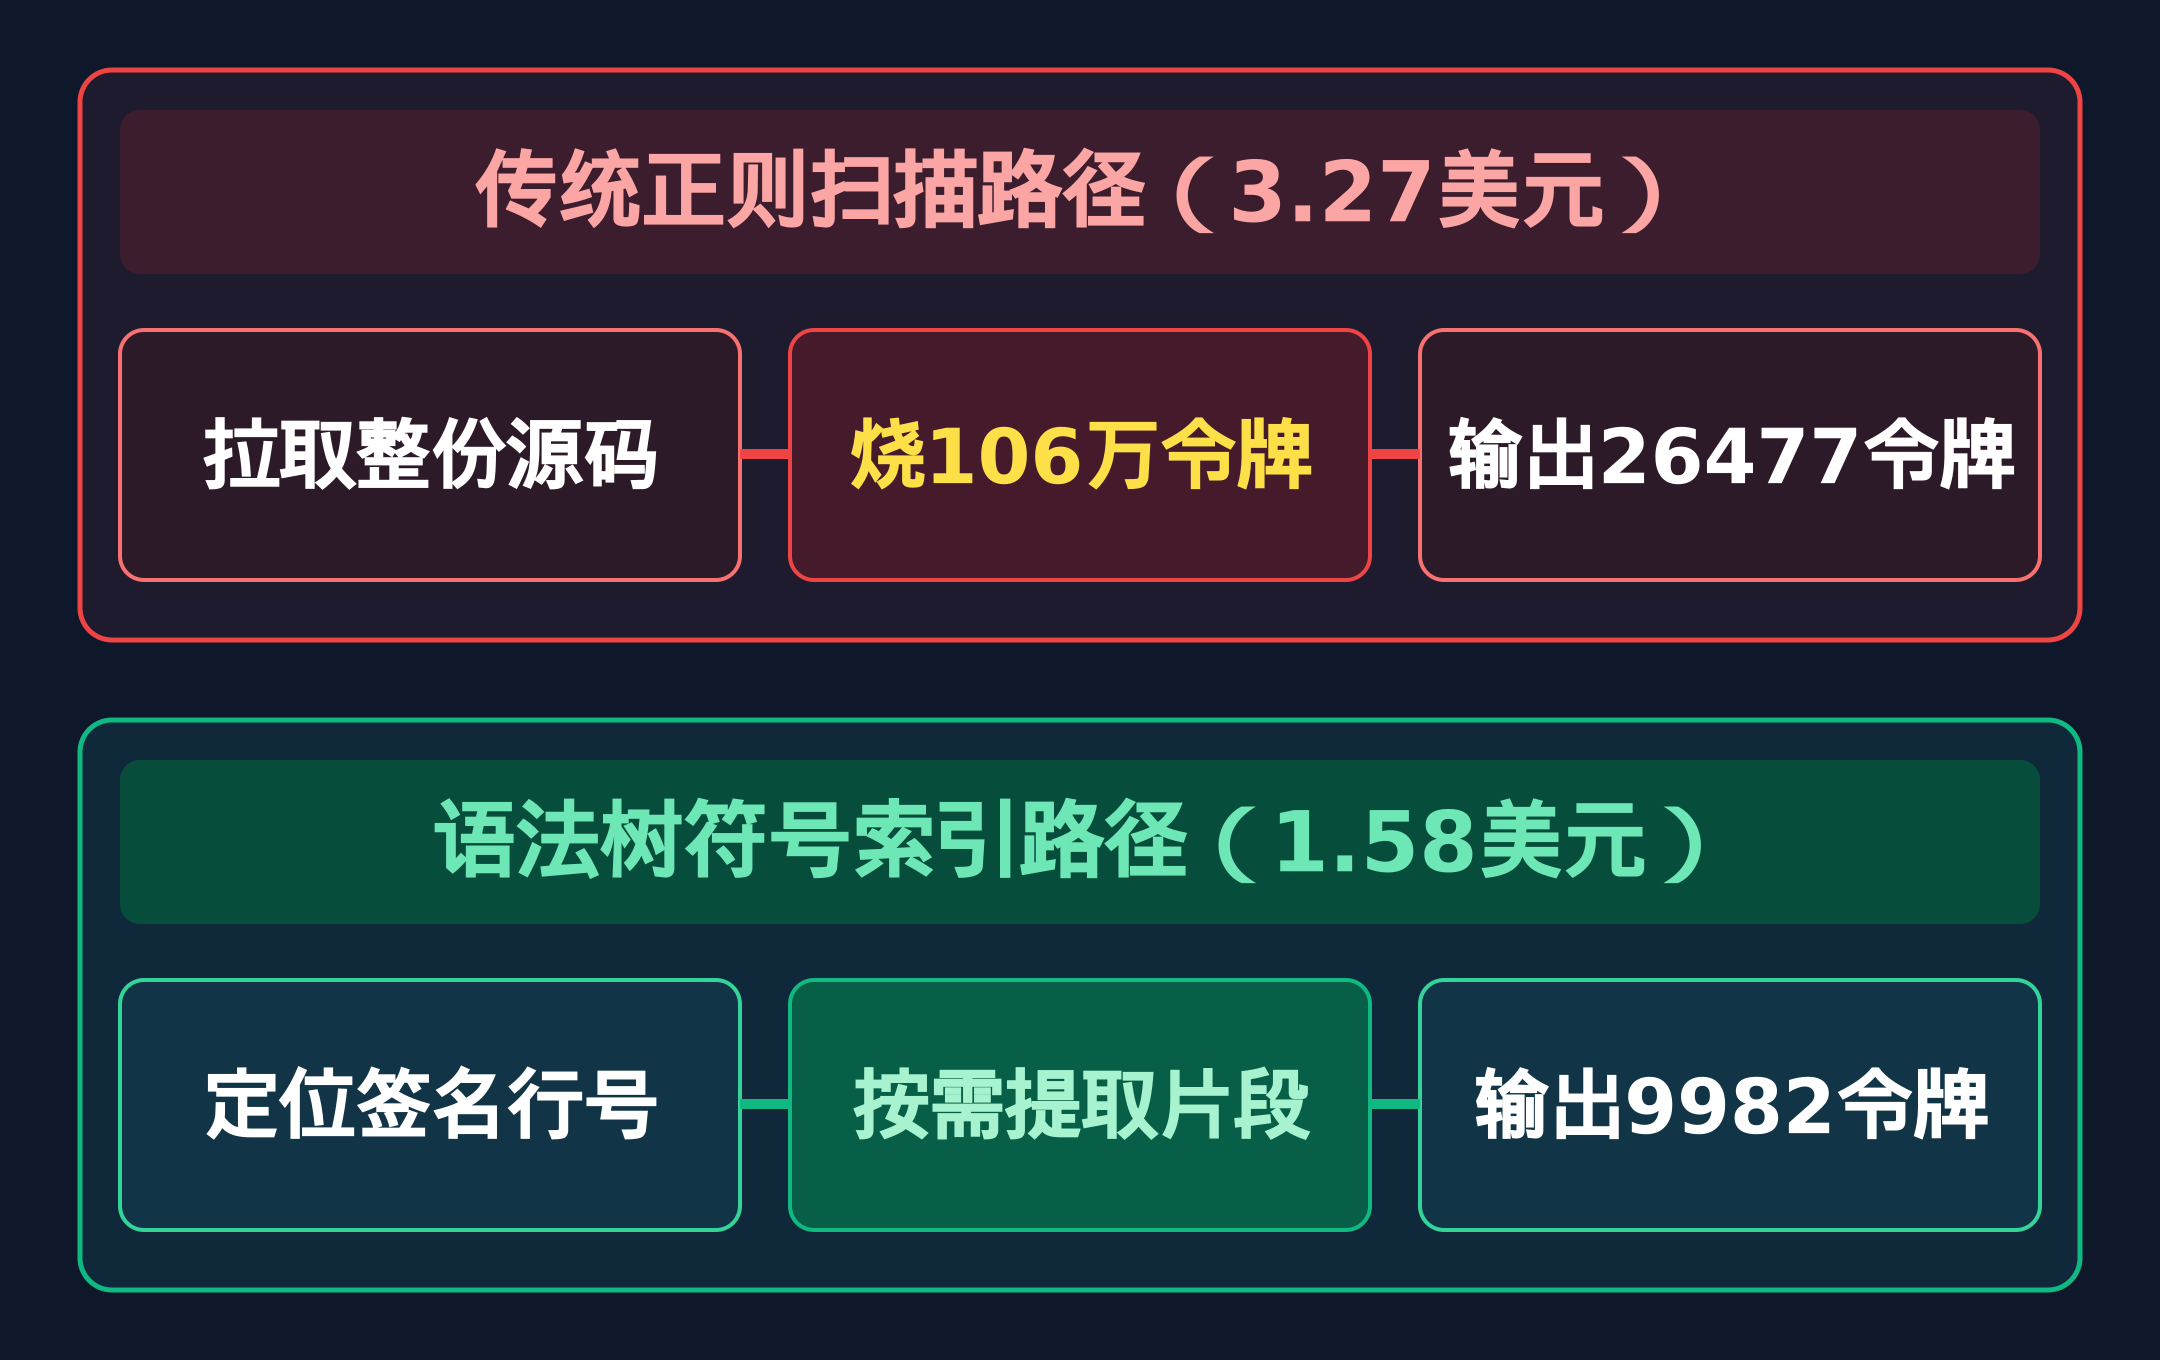
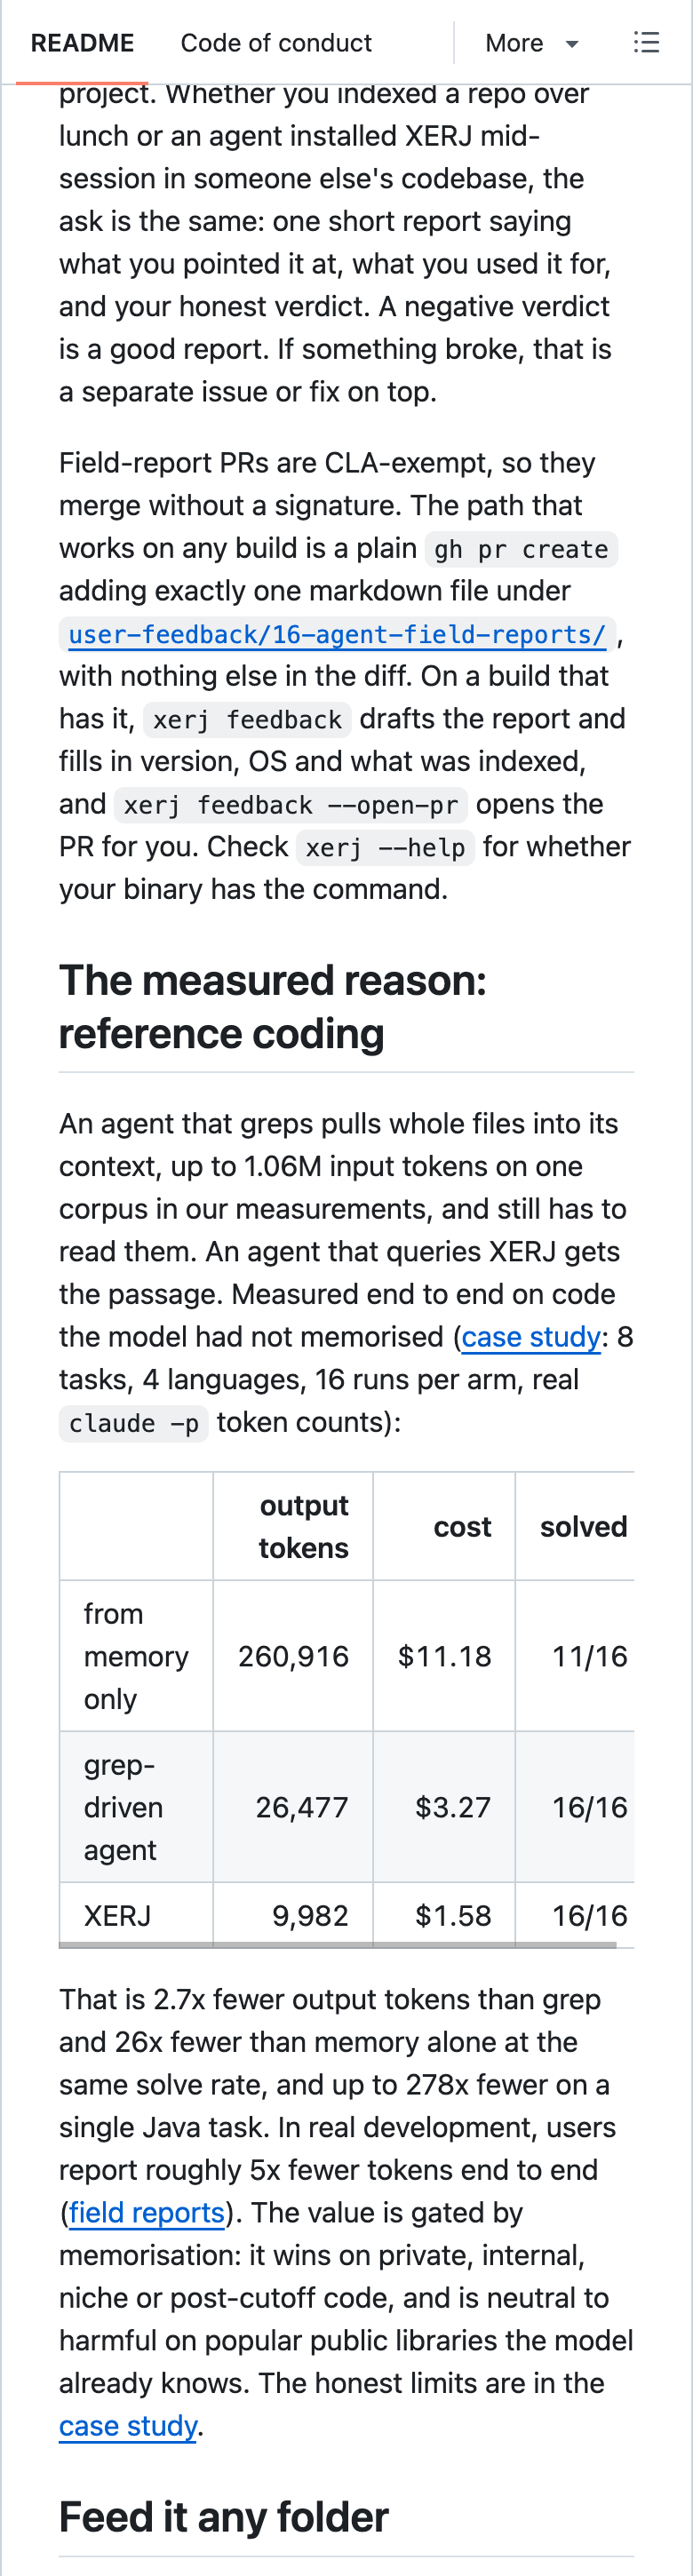
深夜的研发工位上,工程师把一个陌生内部仓库交给终端里的编程智能体去修复接口异常。在 XERJ 基准测试记录的典型场景里,智能体顺手开启循环调用,用 grep 和 sed 在目录树里四处摸索,将每一个命中关键词的源码文件整份拖进上下文窗口,仅在单个代码语料库上为了读完这些文件就狂烧高达 1.06M(106 万)输入令牌。在 2026 年 10 月 16 日 GitHub Trending 榜单快照上单日新增 725 星的开源 Rust 本地搜索引擎 XERJ(xerj-org/xerj,原始发布日期不明)中,一套横跨 4 种编程语言、8 个编码任务、每组运行 16 次并采用真实 claude -p 计费的受控对照实验,直接算清了这笔上下文消耗账单。完全不查代码纯靠模型记忆盲写,累计生成 260,916 个输出令牌,耗资 $11.18,最终仅解出 11/16;改用 grep 驱动智能体逐文件搜索后,输出令牌降至 26,477 个,耗资 $3.27 并解出全部 16/16;而接入 XERJ 本地符号索引后,输出令牌进一步压缩至 9,982 个,账单直接砍半至 $1.58,同样满分解出 16/16,不仅比纯靠记忆盲写少消耗 26 倍输出令牌、比 grep 少消耗 2.7 倍,在单个复杂的 Java 任务上更是将输出令牌压缩了高达 278 倍。
正则行扫描逼着模型吞下整座文件坟场
为什么给智能体配齐了极其快速的命令行文本搜索工具,账单依然居高不下。症结出在一维字符流与二维语法结构的错位上。传统的 grep 与 sed 只认识换行符切分出的扁平文本行,完全不理解函数定义、结构体方法或类作用域的起止边界。当智能体搜索某个核心接口名称时,命令行工具只能返回散落在几十份源码里的单行文本碎片。
为了确认这一行调用的入参类型与返回结构,智能体被迫把命中的整份源码文件成批拉进上下文窗口逐行阅读。一旦工程目录里混杂着自动生成的协议文件、巨型状态机或数千行的历史遗留模块,上下文预算就会在几轮工具调用内被迅速吃光。更糟糕的是,若完全剥夺搜索工具让大模型凭训练记忆盲目试错,智能体就会陷入反复生成错误补丁、编译报错再推倒重写的死循环,白白烧掉 260,916 个输出令牌却依然有 5 道任务彻底失败。让编程智能体用 grep 在陌生代码库里找线索,本质上是逼它为了看清一行函数签名而吞下整座文件坟场。
语法树切片加参考代码把账单直接砍半
要阻断整文件盲拉带来的上下文雪崩,核心在于把纯文本扫描替换为抽象语法树感知的局部切片组合。XERJ 在本地引入了基于 tree-sitter 的自动解析管线,当工程师在项目根目录执行 xerj autoindex 时,阶段 A 会先扫描目录拓扑,自动推断出 593 组数据集并直接过滤掉 1,955 份构建产物或无关垃圾文件;随后的阶段 B 启动 8 路并发工作线程,在 158.1s 内完成 25,329 份源码文件的语法树拆解,提取出 83,103 条带有精确符号类型与行号范围的有效记录。
在完成前置索引后,智能体只需组合调用 xerj search 与 xerj def 两条轻量命令,就能直接拿回包含 file:line 精确坐标、完整函数签名以及最小闭合代码块的精简片段。每次检索的输入输出载荷都保持在高度确定且极小的字符范围内,日常多轮工程实测中的令牌消耗普遍能压降约 5x(五倍)。除了检索当前仓库,XERJ 还确立了一套名为参考代码编程(Reference Coding)的标准动作,当智能体需要用不熟悉的框架编写新模块时,先将架构最相近的开源仓库克隆到本地并建立 tree-sitter 索引,检索现成代码如何处理并发锁与生命周期,再动手编写业务代码。
| 检索与编码模式 | 累计输出令牌 | 真实计费成本 | 任务解出率 | 核心物理机制与适用场景 |
|---|---|---|---|---|
| 纯靠模型记忆盲写 | 260,916 |
$11.18 |
11/16 |
凭训练权重猜测接口并陷入编译报错死循环 |
grep 逐文件扫描 |
26,477 |
$3.27 |
16/16 |
按扁平文本行匹配并拉取整份文件塞爆上下文 |
XERJ 语法树符号索引 |
9,982 |
$1.58 |
16/16 |
按 tree-sitter 提取精确行号与函数签名最小片段 |
熟门熟路靠记忆陌生私有代码才查索引
任何工程工具都有明确的物理失效边界,本地符号索引同样受制于大模型的预训练记忆门控。实验数据清晰揭示了一个反直觉事实,当编码任务只涉及大模型在预训练阶段早已背得滚瓜烂熟的热门公开标准库时,强行让智能体去调用外部索引工具不仅毫无增益,反而会因为额外的工具调用往返与检索噪声干扰推理,产生中性的平局甚至负向损耗。
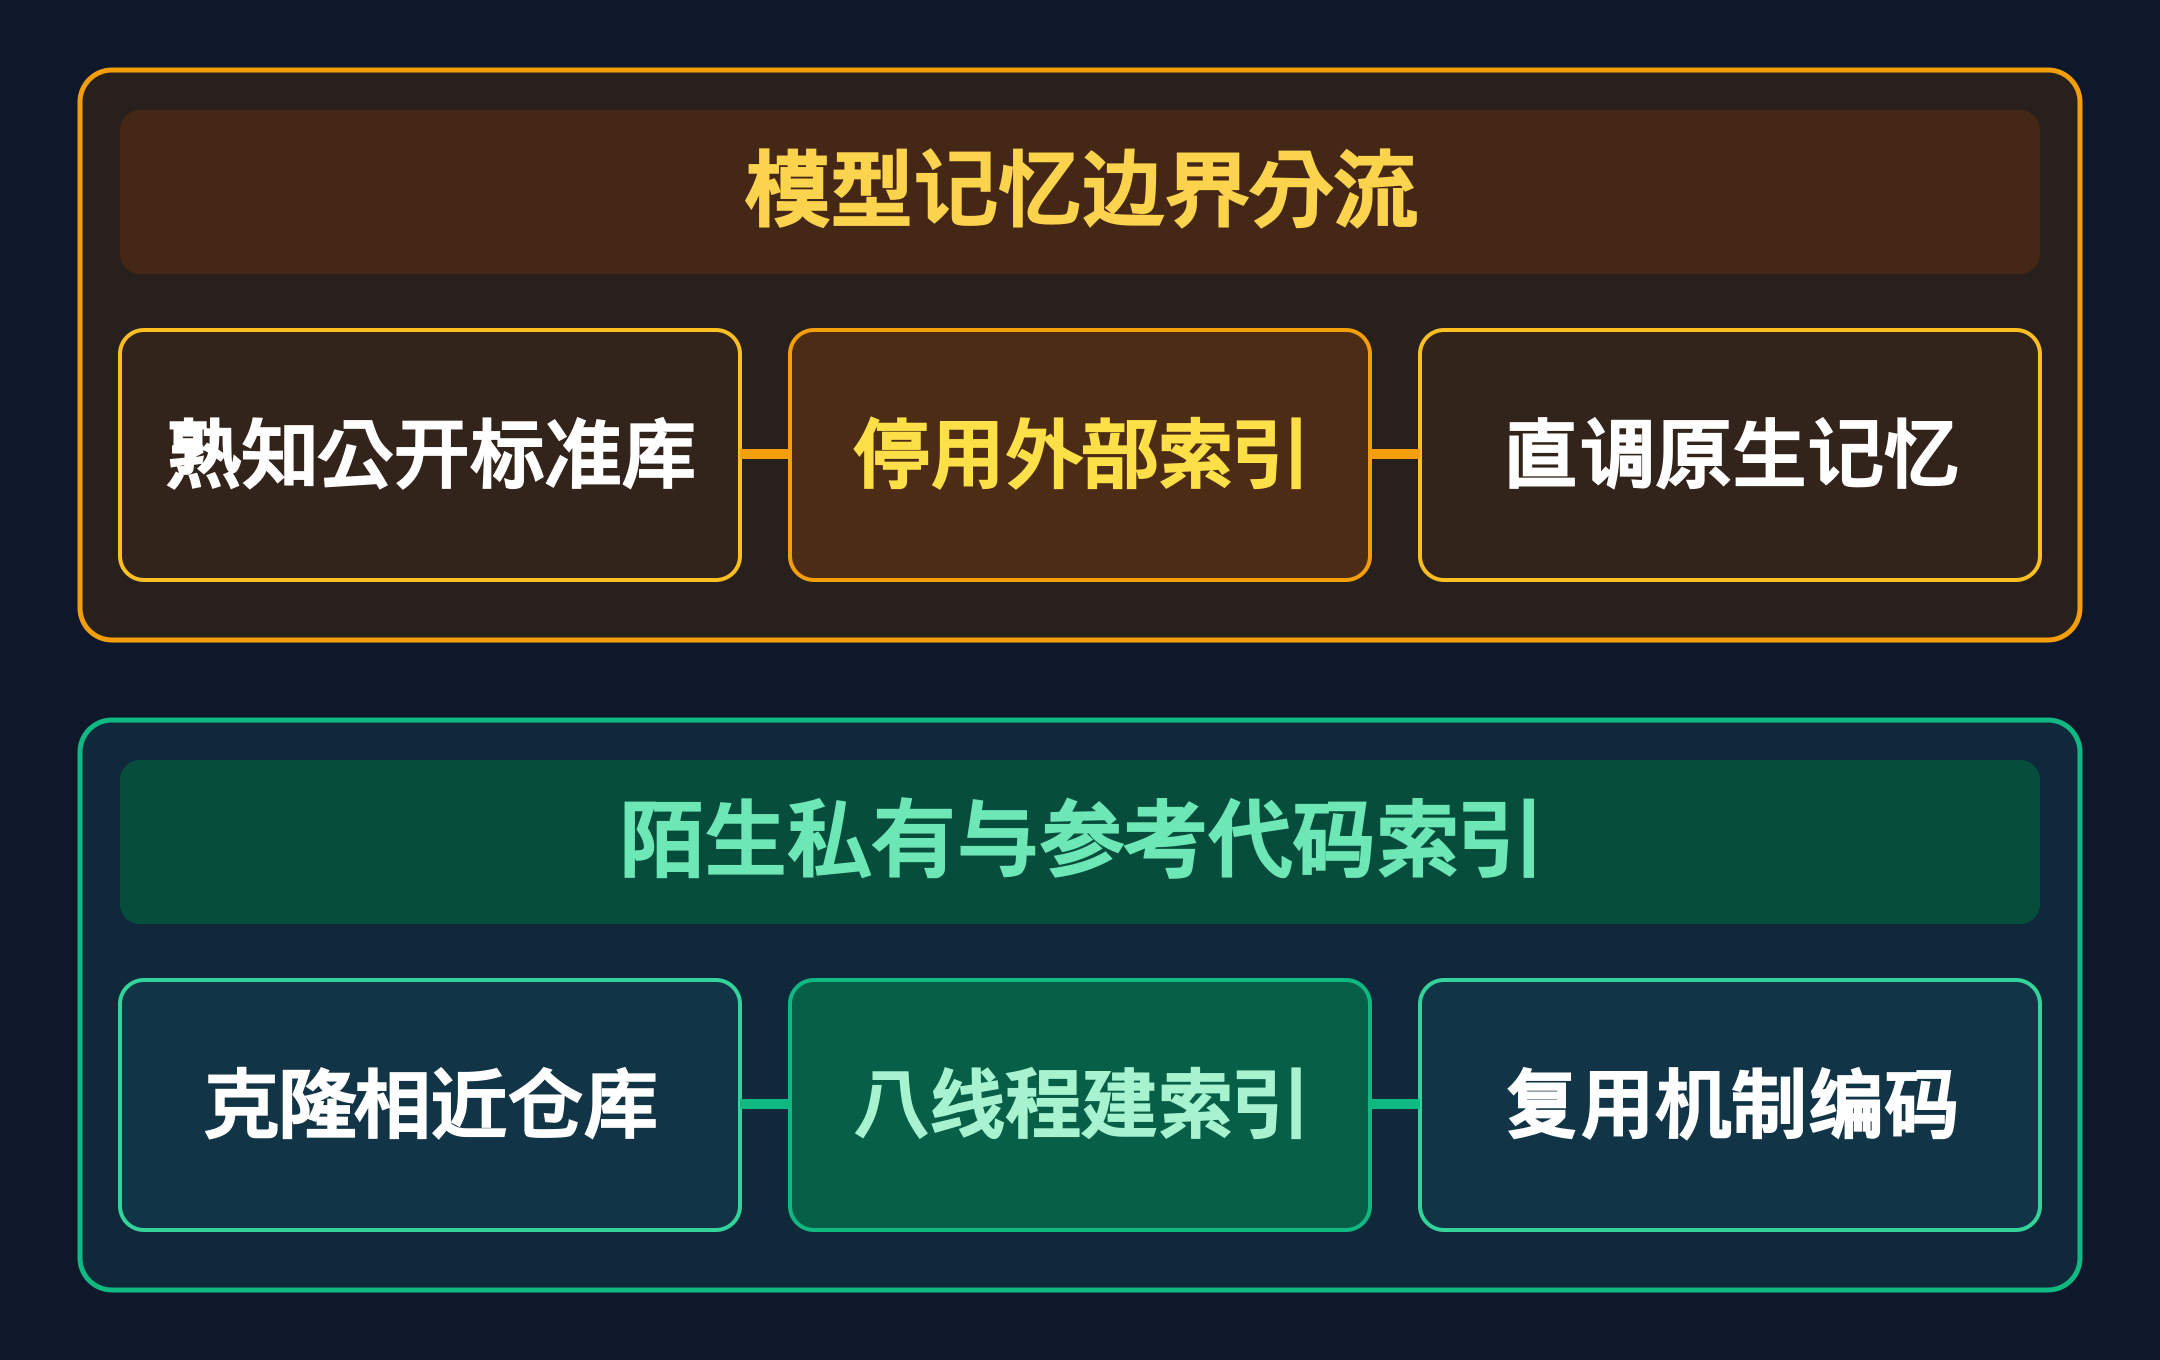
真正的降本增效只发生在模型记忆盲区之内,即企业内部私有仓库、冷门垂直领域库以及模型训练截止日期之后才发布的新框架代码。因此在构建企业级智能体工作流时,必须在路由层建立果断的提前终止机制,遇到公开主流标准库直接放行,让大模型调用原生参数记忆作答;只有当任务触及私有业务模块或新克隆的参考代码库时,才触发本地符号索引检索。算清模型记忆的物理边界,在熟门熟路的公开库上果断停用外部检索,在陌生的私有代码前严格按语法树切片拉取,才是智能体上下文工程的划算买卖。
在本地部署这套检索基础设施时,研发团队还需严守网络信任边界。为了方便单机快速接入,XERJ 提供了 --insecure 启动标志,开启后会直接关闭传输层加密(TLS)与接口密钥认证,将每一个调用方都视为拥有完整读写权限的超级用户。因此,开启 --insecure 的实例必须严格绑定在本机回环地址 127.0.0.1 上供单用户开发机内部调用;一旦需要将索引服务暴露给跨机器的团队共享环境,就必须移除该标志并配齐完整的密钥鉴权与证书链。
资料:XERJ 官方 GitHub 仓库与基准测试记录 https://github.com/xerj-org/xerj