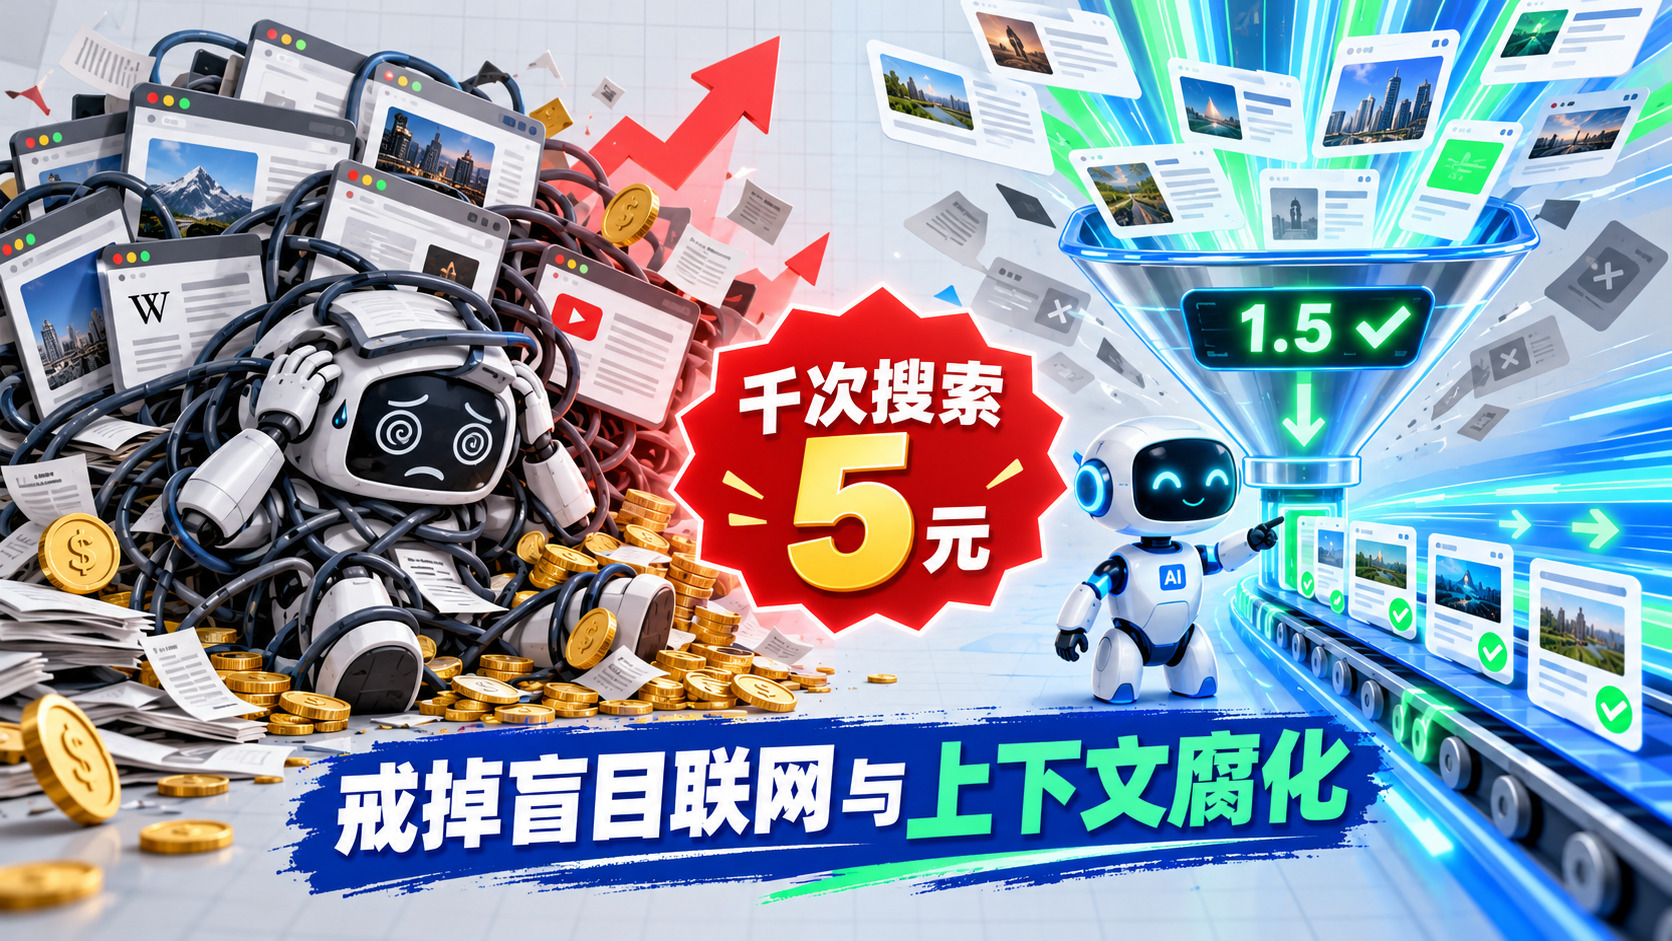
智能体仅仅为了核对五家竞品的最新动态,后台就悄无声息拉起无头浏览器加载十几个网页。几十万字夹杂着导航栏和脚本碎片的原始文本被直接塞进主对话窗口,不仅让首字响应卡顿数十秒,单次任务账单更是动辄烧掉数美元。
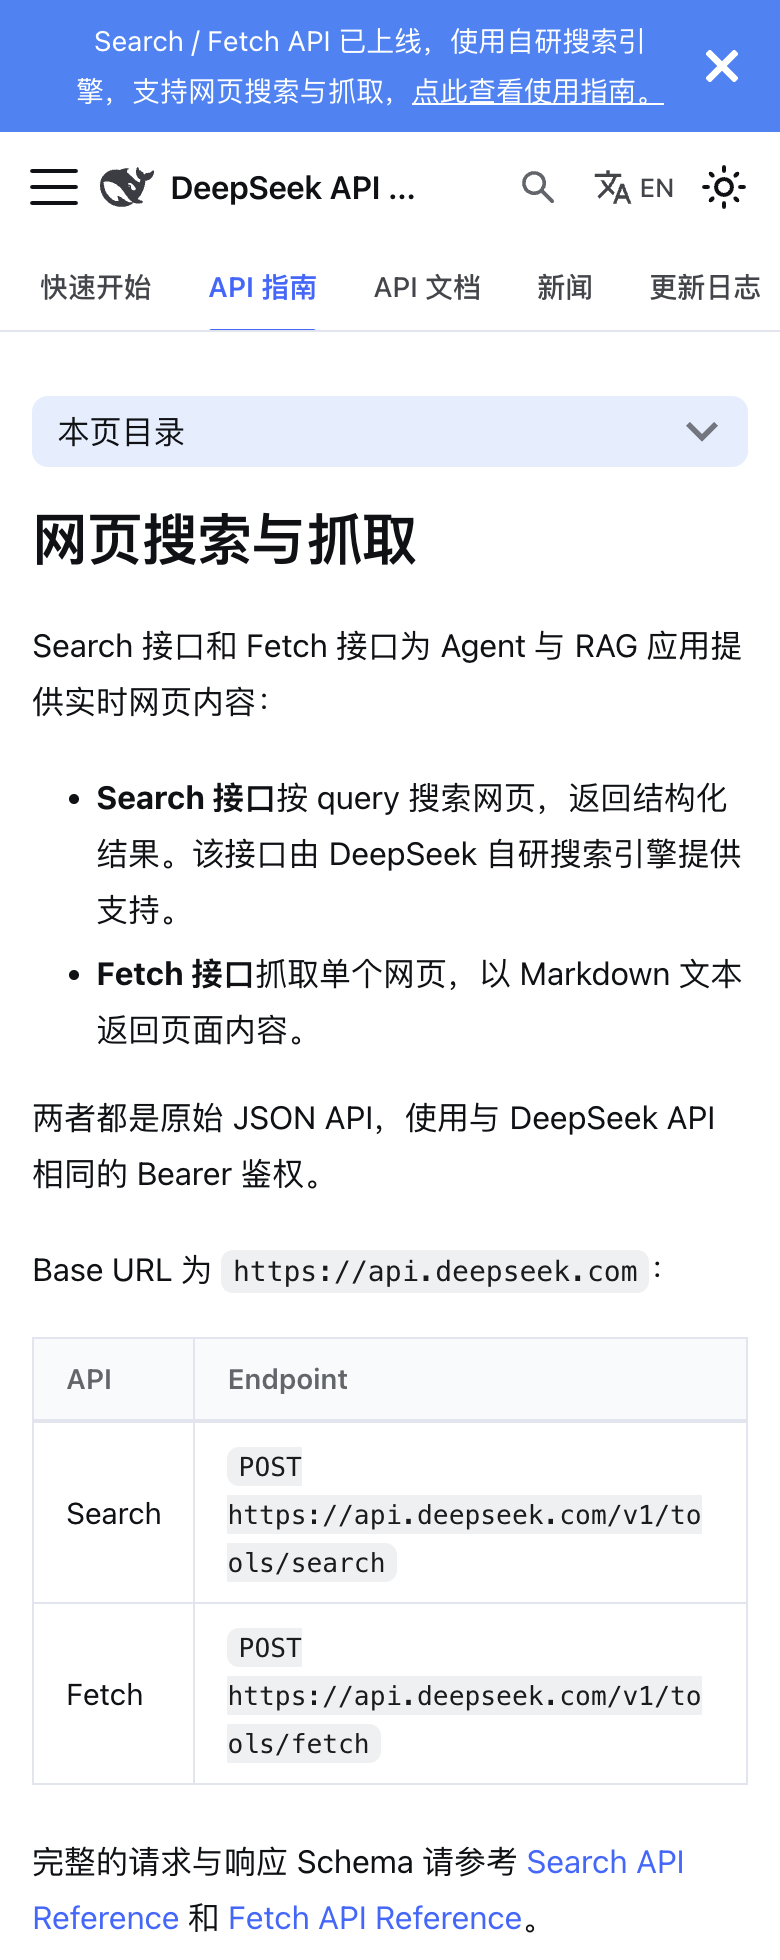
2026 年 10 月 17 日,DeepSeek 正式开放底层自研搜索引擎支撑的 Search 与 Fetch 两个原始 JSON 接口,同步将模型升级至 DeepSeek-V4.1-Flash-1017。这两项接口把实时网页搜索与正文提纯的价格直接打到每 1000 次成功请求 0.75 美元(人民币 5 元),折合单次调用仅需半分钱,彻底击穿了智能体联网检索的接口底价。
千次调用五元重塑网页检索底价
长期以来,研发团队在为智能体接入实时联网能力时,往往面临高昂的按次检索溢价与参差不齐的网页清洗质量。DeepSeek 此次开放的底层引擎索引了全球千亿级网页,日均稳定处理数亿次搜索请求,并在检索源头内置了对 SEO 作弊、GEO 操纵与低质 AIGC 内容的严格识别过滤。在计费规则上,/v1/tools/search 与 /v1/tools/fetch 统一按每 1000 次成功请求 0.75 美元(人民币 5 元)计费。只有当接口返回 HTTP 200 且实际产生非空结果时才会扣费,请求失败、搜索无结果或下游超时全部零计费。单次搜索返回条数 count 可在 1 至 50 之间自由配置(默认 10 条),完全不影响单次请求价格;而在 DeepSeek Harness、Claude Code 与 Codex 中通过服务端工具发起的调用,在 2026 年 11 月 1 日零点前更是完全免费。
除了击穿地板的定价,这套接口更具工程价值的设计在于将“搜索发现”与“正文抓取”彻底解耦,并在协议层内建了前置截断机制。Search 接口接收 1 至 128 字符的 query(原生支持 site:、-site:、lang:、after:、before: 等操作符),其 need_content 参数默认设为 false,即默认绝不拉取庞大的网页正文。接口返回的每个条目不仅包含 100 至 200 字符的前端短摘要 snippet,还专门提供了 600 至 800 字符供大模型阅读的长摘要 summary,同时附带 0 至 3 区间的综合排序分 rerank_score(1.5 及以上代表优质结果)与 0 至 4 级的权威度 authority(3 及以上代表极权威来源)。
这种默认关闭正文的设计,让联网网关得以在元数据层直接实施低质短路。当某条结果的 rerank_score 低于 1.5 或 authority 低于 3 时,系统在读取摘要前即可直接丢弃该分支,从源头避免无效正文拉取。只有通过评分门禁且长摘要仍不足以回答问题的高价值链接,才会进入下游 Fetch 接口(支持最长 8192 字符 URL),将目标网页直接提纯为干净的 Markdown 文本返回。同时,官方规范对异常边界做出了严格约束,当 Fetch 遭遇 HTTP 403 安全策略拒绝或 HTTP 404 无法提取可用 Markdown 正文时,调用方在不修改请求的前提下严禁盲目重试,直接终止无效分支。
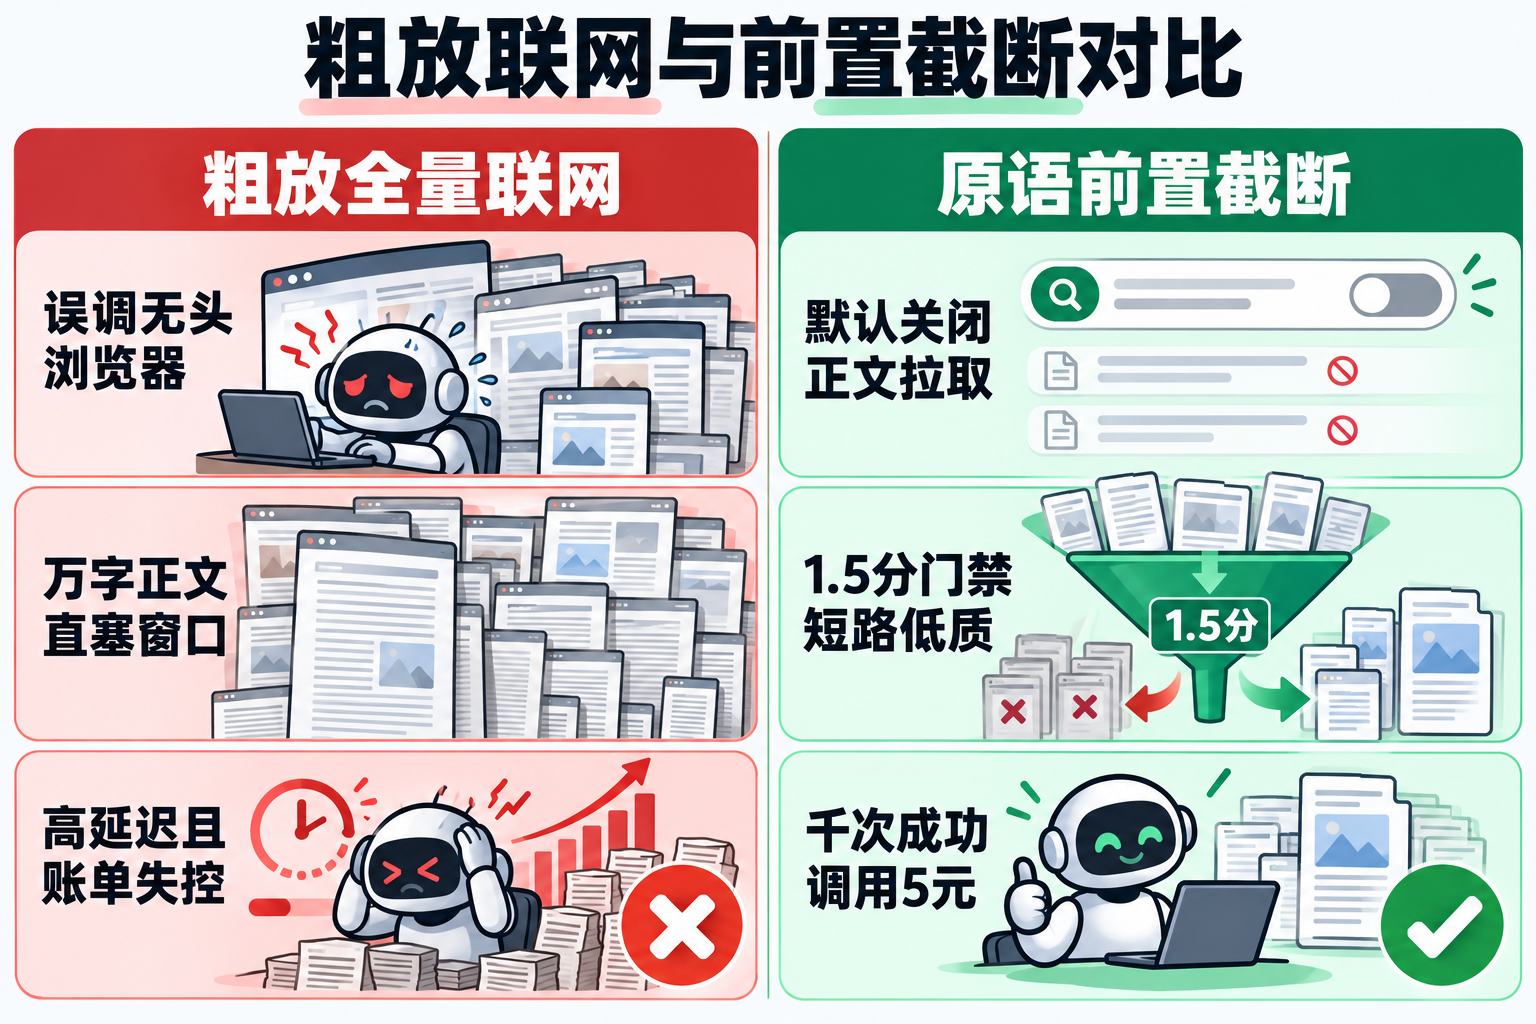
在摘要层掐断低质链接,远比拉回万字脏网页再清洗更省钱。
浏览器失控与上下文腐化吞噬算力
既然底层搜索与 Markdown 抓取已经便宜到每千次 5 元人民币,为何无数生产环境中的联网智能体依然又慢又烧钱?2026 年 10 月中旬,Browser Use 与 LangChain 团队相继发布的两份工程实证,揭开了吞噬算力与响应时间的两大真正病灶。
第一个病灶是把本该走轻量接口的静态检索,错配给了高开销的浏览器智能体。2026 年 10 月 18 日,Browser Use 团队(Nik Tomazic)公布了涵盖 V2、V3 与 V4 智能体的 Browser Use Cloud 生产环境运行统计。数据显示,线上高达 14% 的运行被用于提取结构化数据,6% 用于开放问题跨站搜索研究,5% 用于查找财报与申报文件;而真正必须依赖浏览器会话去突破一次性验证码、多因素认证等登录挑战的任务占 18%,职位申请填表占 6%,预订购买占 3%(另有 15% 未分类)。浏览器智能体由模型、脚手架与浏览器三部分构成,每一次菜单展开、弹窗覆盖或页面刷新,都必须通过 Chrome DevTools Protocol 重新读取 DOM、无障碍树(Accessibility Tree)或渲染截图。把完全可以用毫秒级 Search 与 Fetch 接口完成的静态资料搜集交给无头浏览器,不仅要承受反爬风控拦截与恶意网页提示词注入风险,还会因随机多步重试导致耗时与账单成倍失控。
第二个病灶则是全量网页直塞引发的“上下文腐化(Context rot)”。LangChain 团队(Jess Weng)在 2026 年 10 月 14 日的技术报告中拆解了一个典型场景,即每周自动调研 5 家竞品并撰写周报的智能体。该智能体每调研一家公司就要拉取数万行市场数据并抓取阅读数十篇新闻网页。到了第四步汇总起草阶段,主上下文窗口里已经堆积了 5 份原始数据表、几十篇网页全文和两版旧草稿。这些早已被榨干价值的历史噪声,在后续每一次模型推理调用中都要被反复预填充和重复计费,不仅拖垮响应速度,更直接导致模型注意力稀释与最终报告精度跳水。
真正烧穿账单的不是那次搜索请求,而是塞进主窗口的十万字噪声。
分层网关与中间件卸载重构联网架构
要让智能体真正享受到千次 0.75 美元的技术红利,研发团队必须摒弃“万物皆调无头浏览器、返回结果全塞主窗口”的粗放写法,将检索原语与上下文治理拆解为正交模块,按执行代价逐级组装成三层联网架构。
第一层是构建按代价递进的三级联网分流漏斗。网关在收到检索意图后,第一级优先路由至拥有每秒 100 次并发配额(100 QPS)的 Search 接口,利用搜索语法与 600 至 800 字符的 summary 直接闭合九成以上的事实核验,绝不拉取多余正文。第二级仅对 rerank_score 达到 1.5 以上且确需深读原文的链接,路由至每秒 25 次并发配额(25 QPS)的 Fetch 接口拉取纯净 Markdown。第三级则严格遵循 Browser Use 的选型铁律,在流程固定但无接口时改用 Playwright 或 Puppeteer 编写确定性脚本,仅在必须突破那 18% 的复杂登录验证或处理非结构化动态表单时,才按需唤醒无头浏览器智能体。
第二层是在工具调用环路挂载可插拔的上下文卸载与隔离中间件。参照 LangChain 开源脚手架 Deep Agents 的中间件设计,在网关层接入 FilesystemMiddleware,一旦单次工具返回的网页或数据超过 20000 Token(或用户输入超过 50000 Token),在进入对话前自动拦截并写入 /large_tool_results/{tool_call_id} 本地文件,主窗口仅保留首尾几行预览与文件路径,供模型后续通过 read_file 按需翻页。对于跨数十个网页的嘈杂竞品检索,通过 SubAgentMiddleware 将任务派发给运行在廉价模型上的独立子智能体并行处理,强制子智能体在独立窗口内消化长文,仅向主智能体回传 3 条精炼结论。当主窗口上下文占用触及 85% 阈值时,再由 SummarizationMiddleware 自动将早期历史浓缩为摘要,并将原始记录无损归档至 /conversation_history/{session_id}.md。
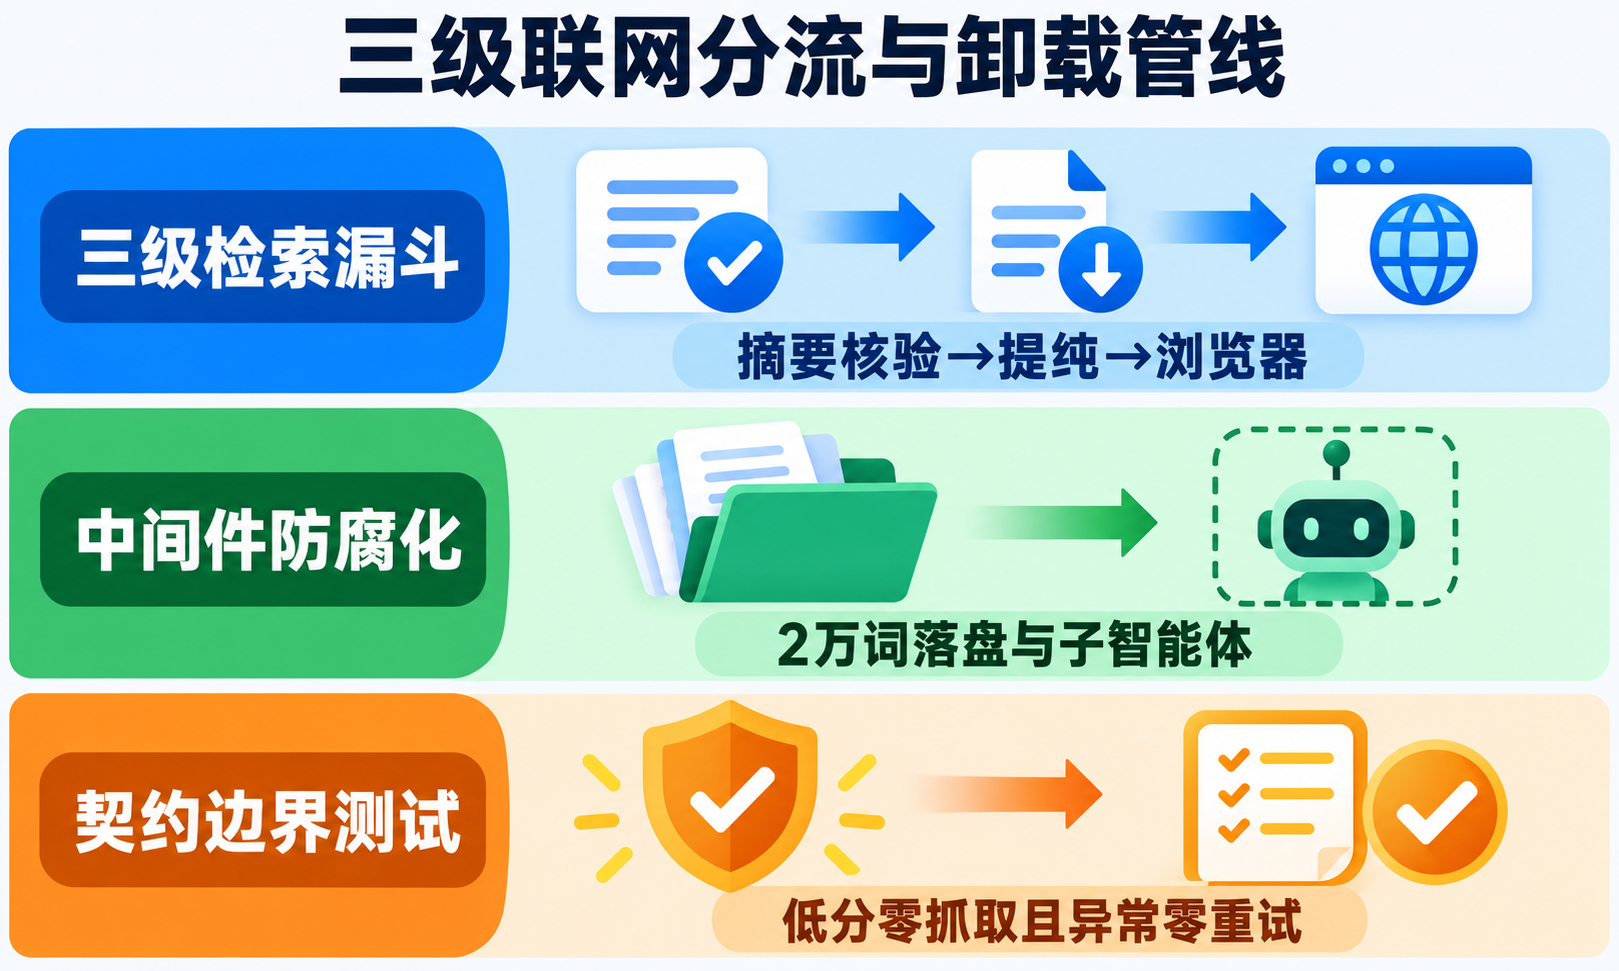
第三层是为整条联网管线补齐确定性契约与成本边界测试。由于搜索、抓取与卸载中间件均已解耦为输入输出明确的独立单元,工程团队无需启动昂贵的真实浏览器即可在本地执行回放校验。上线前只需对网关运行三项刚性断言,即注入 rerank_score < 1.5 的模拟搜索响应时验证下游 Fetch 调用次数恒为零,注入超过 20000 Token 的网页正文时验证主窗口增量绝不越界,注入 HTTP 403 与 HTTP 404 状态码时验证重试次数严格归零,即可从架构根源上锁死联网延迟与 Token 账单。
把搜索、抓取、卸载与浏览器拆成可验证的积木,智能体才算真正学会上网。