不少团队每隔几分钟就把过去三周上万个采样点的温度、压力和处理器负载拼成几万字 JSON,塞进百亿参数的大语言模型请求预测。显卡被持续占满,等上几秒吐出的结果却连小数点都对不齐,甚至把早已排期的停机维护当成突发故障在凌晨误报。
2026 年 10 月 15 日,Mistral 开源首个原生时序基础模型 Timestral,提供 5M(21 MB)、28M(111 MB)、123M(490 MB)与 209M(837 MB)四个尺寸。在 8 线程服务器 CPU 上,基于三周历史数据(2016 步)预测未来一天(96 步),5M 仅需 10 毫秒,209M 仅需 140 毫秒。
两千万参数在普通处理器上越级反杀大模型
Hugging Face 零样本评测覆盖了三大权威时序榜单,包括 Salesforce 的 GIFT-Eval(对比 83 个模型)、涵盖 98 个任务的 TIME(对比 35 个模型)与 AutoGluon 的 fev-bench(对比 37 个模型)。其中 MASE(平均绝对缩放误差)越低越准,SQL skill score(分位数损失技能分)越高越准。
实测显示,Timestral-209M 在三榜分别取得 MASE 0.658、MASE 0.626 与 SQL 技能分 50.39,横扫五项指标第一。而仅 2800 万参数的 Timestral-28M 在 GIFT-Eval(0.678)和 fev-bench(48.42)上,直接击败了 4 倍体积的亚马逊 Chronos-2(0.698 与 47.28)以及 Datadog 25 亿参数大模型 Toto-2.0-2.5B(0.696 与 44.42)。
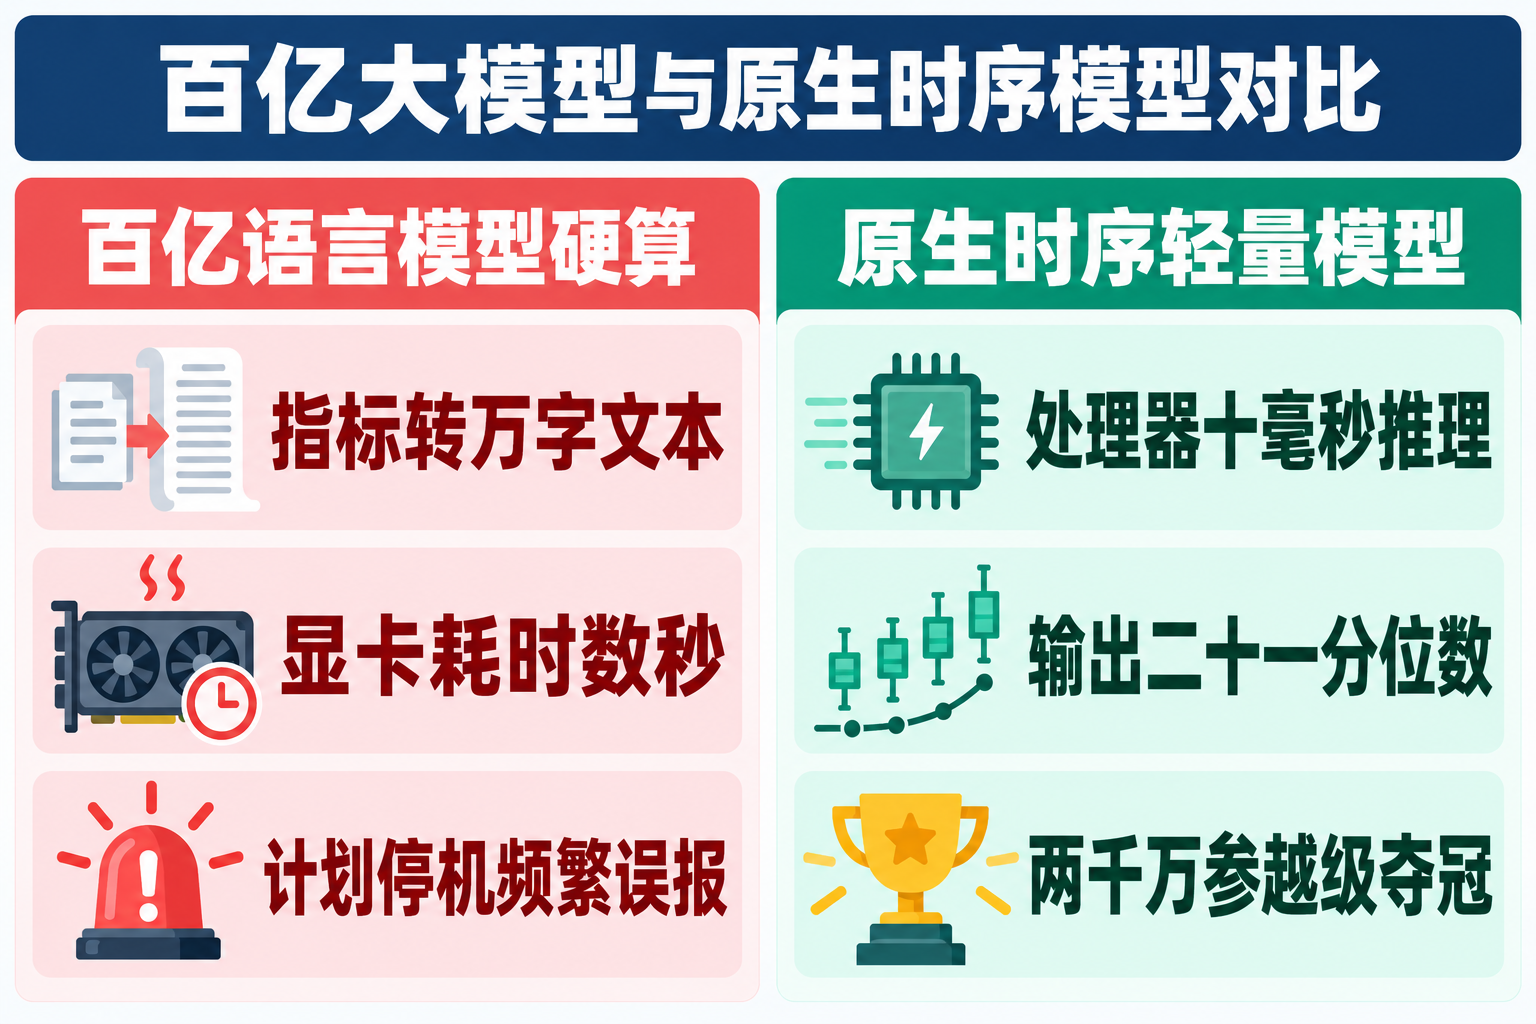
让百亿语言模型硬啃浮点监控表,再多显卡也填不满算力黑洞。
解耦预测跨度与单向注意力堵死信息泄漏
语言模型算不准监控,是因为分词器把浮点数切成了碎字符。而 Toto 2.0 与 TimesFM-3 等传统时序模型采用连续片段掩码训练,直接抹除待预测目标,将其与传感器断网产生的缺失值(NaN)混淆并丢失后续上下文。Timestral 改用解耦预测跨度(DHF),把每 32 个时间步与观测掩码打包为 1 个 Patch,完整保留 32,768 步历史,由独立预测 Token 读取前序特征并单次输出 1,024 步预测。
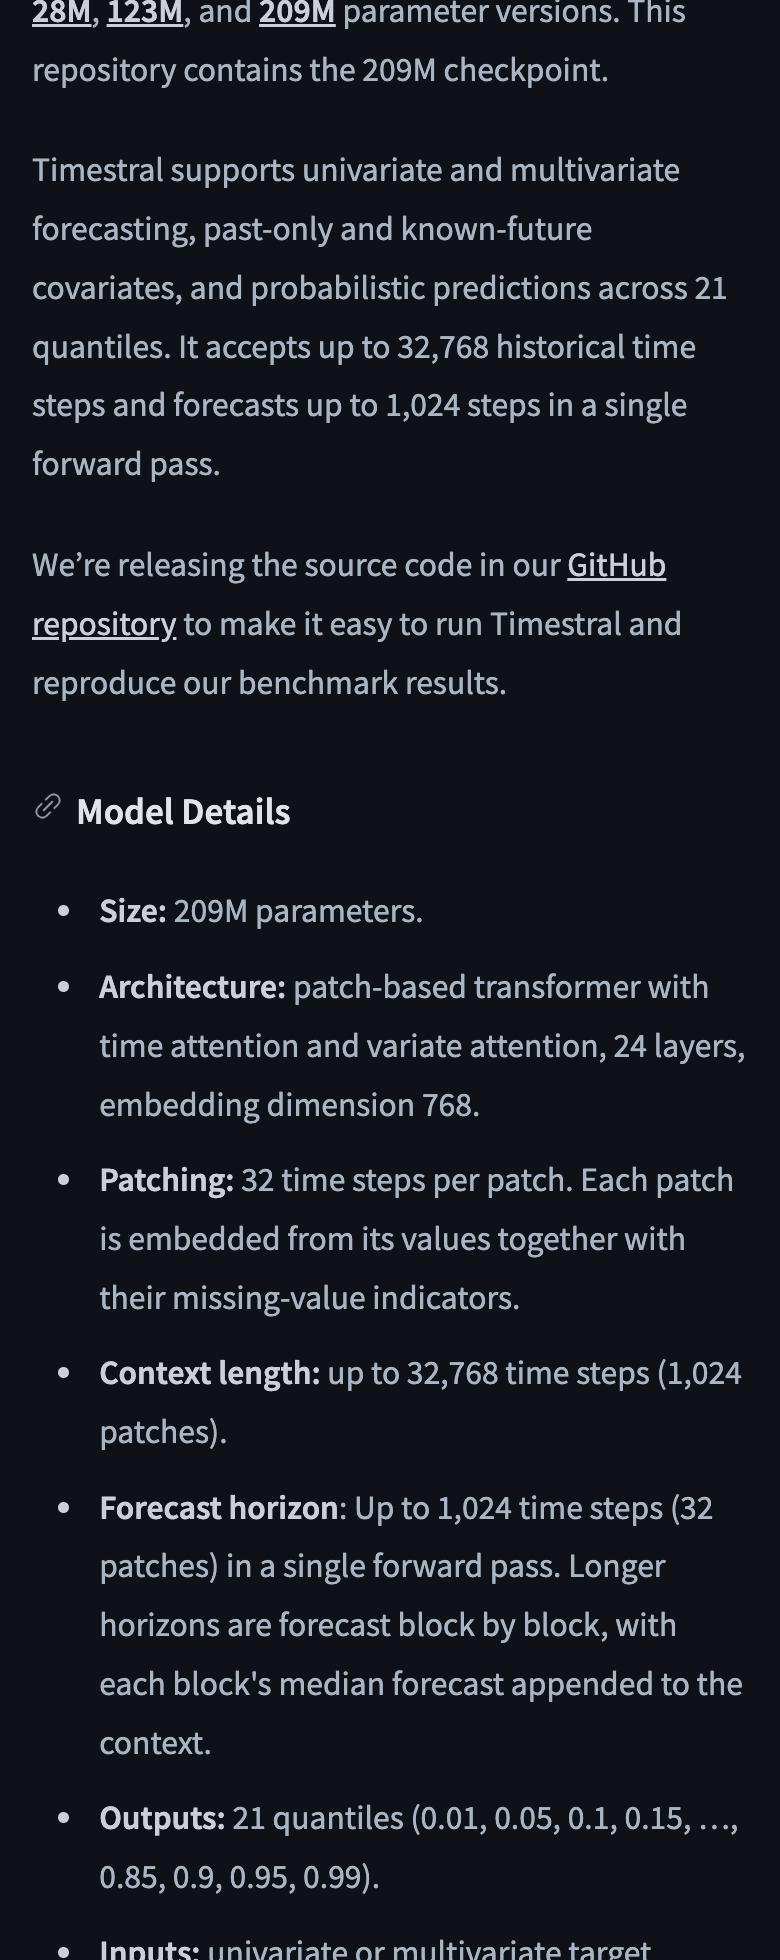
针对误报顽疾,Timestral 引入单向协变量注意力,将排产表、计划停机与发版窗口作为已知未来协变量(known_covariates)注入。注意力掩码强制信息只能从协变量单向流向目标变量,绝不反向读取。配合弹球损失优化,模型在每步输出 0.01 至 0.99 共 21 个分位数,既消化计划内波动,又堵死未来信息泄漏。
把排产日历单向锁进注意力掩码,计划内停机才不会误拉警报。
数值哨兵前置短路串联多智能体根因诊断
借助毫秒级 CPU 推理,管理上千台工业水泵的监控系统可重构为三层管线。第一层在采集端 CPU 进程内运行 Timestral-5M 或 28M,注入排产与停机计划联合预测振动、温度与压力。只要实测值落在 [0.05, 0.95] 分位数安全带内或符合排产预期,请求在 CPU 层 10 毫秒 直接短路终结,零 GPU 与 Token 消耗。
第二层将高频数值监控与低频文本归因解耦。只有当某台水泵的振动与温度刺穿 0.99 分位数且非计划停机时,前端哨兵才触发告警,将异常窗口向量化匹配历史故障,进而唤醒语言智能体查阅维护记录、交接班日志、设备手册和工单,向厂长交付带数据证据的维修方案。
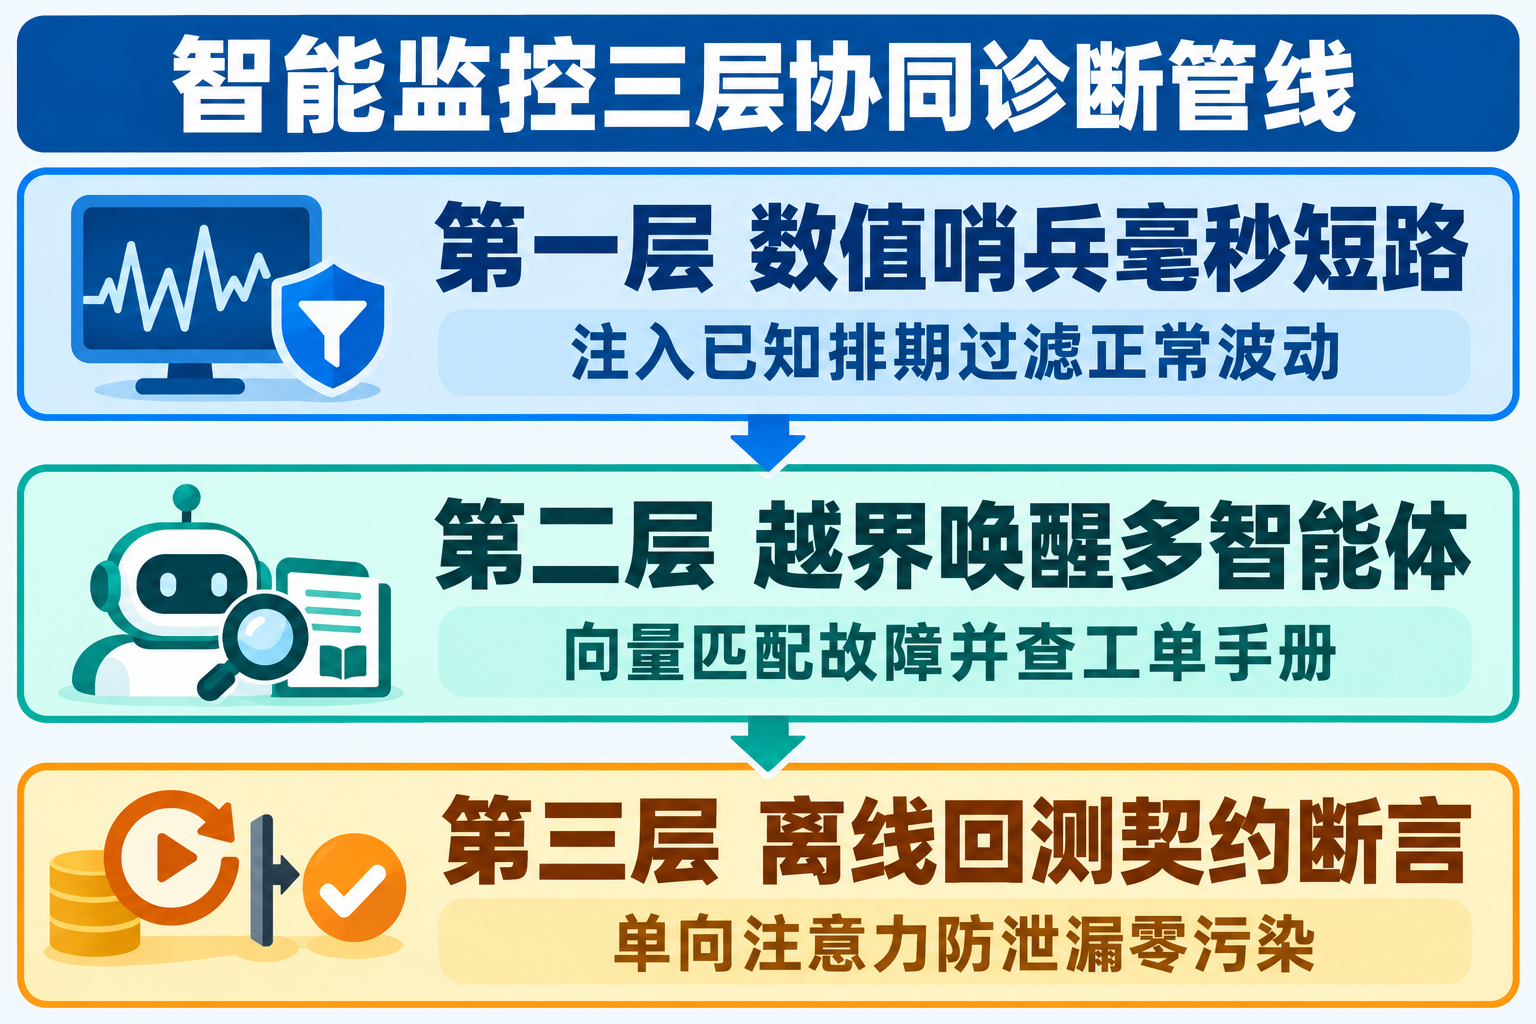
第三层是离线回测与契约断言。团队在持续集成中验证任意 NaN 缺失下 21 个分位数单调不交叉,验证停机指示器的零误报抑制,并通过 Mistral Forge 在物理隔离环境(air-gapped)下确保回测窗口与预训练数据零重叠。
用轻量时序哨兵毫秒级过滤常态波动,语言智能体才能专注根因诊断。