用户发来一句“上周买的运动鞋我想退货”,记性过好的客服智能体在上下文里翻出两年前的聊天记录,误把用户给长辈购买降压袜的订单提取出来直接发起退款。更要命的是,在未获取邮编时连续调用六次接口盲猜,陷入重试死循环,耗尽十万词元(Token)后向用户吐出一长串英文报错堆栈。
这如同两人沟通时把三年前长达八百页的往来聊天记录打印成册摔在桌上,指望对方立即理解原委,结果只会适得其反。每聊一句都得花真金白银让大模型重温一遍历史上的失误记录,不仅办不成事,反而是花钱买噪音回放。很多团队为了让智能体“记住”历史,习惯把几十场原始对话拼接塞进提示词,或者耗费巨资微调模型。面对查单、退款或改签等写库任务,单问输入往往突破十万词元,每四位用户依然会有一位遭遇业务执行失败。
2026 年 10 月 20 日,IBM 开源 ALTK-Evolve 框架,不改模型权重且无人工标注,仅靠从历史轨迹中离线提炼行为准则,就让旧模型 GPT-4.1 登顶客服基准 τ²-bench 零售榜首。同日,Databricks 发布企业生产级记忆架构 MemCurrent,将真实业务任务通过率提升三倍,同时节省 31% 词元开销并提速 26%。
旧模型零微调越级反杀专有微调大模型
从底层机制分析,把聊天记录当记忆从一开始就搞错了方向。生物记忆的真相不是录音笔,而是突触剪枝与离线提炼。人类在睡眠时通过离线做梦机制丢弃绝大多数琐碎对白,仅将关键经验沉淀为底层认知。如果一个人做饭前必须先在脑海中把过去三十年吃过的一万顿饭完整重播一遍,恐怕早已无暇生火。大模型的注意力同样受制于信噪比,长篇陈旧对话塞满窗口,核心业务规则就会被淹没在数十页无关文本中。
Sierra 的 τ²-bench 基准覆盖零售(retail)与航空(airline)两大领域。智能体面对 GPT-5.5 扮演的模拟客户,连续调用工具处理业务,最终数据库状态必须与预期完全一致。其核心考核指标 Pass^4 极其严苛,要求同一任务独立执行四轮且每一轮都保持零失误。在真实业务中,四次成功三次的系统意味着每接待四位客户就会办砸一单。
IBM 团队并未微调底层模型,保持两阶段 THINK → ACT 原生 ReAct 脚手架不变,仅在系统提示词策略块下方追加一段自动提炼的 Markdown 规则清单。在零售全量榜单上,零微调的 GPT-4.1 取得 67.5% Pass^4 成绩夺得总榜第一,击败深度微调的 RAFT-30B-A3B 模型(61.4%);在航空全量榜单上,同一方法助推 GPT-5.5 达到 82.0% Pass^4,全面压制行业常见模型组合。
两代记忆方案的核心差异如下表所示:
| 评测维度 | 传统全量历史拼接方案 | 离线记忆提炼架构 | 实际改善幅度 |
|---|---|---|---|
| 单次提问输入上下文 | 动辄 103,000 Token | 精简至 8,400 Token | 降低约 92%(节省 12 倍算力) |
| 客服任务四轮全通率 | 22.3%(第四次必定出错) | 跃升至 67.5% - 68.4% | 任务成功率直接翻 3 倍 |
| 所依赖的模型规格 | 必须堆叠高成本推理大模型 | 两年前的旧模型 GPT-4.1 即可登顶 | 摆脱对昂贵前沿模型的依赖 |
| 单次离线提炼成本 | 每次提问都在重复消耗 | 单任务离线跑完仅需 0.097 美元 | 一次提炼,全局持续复用 |
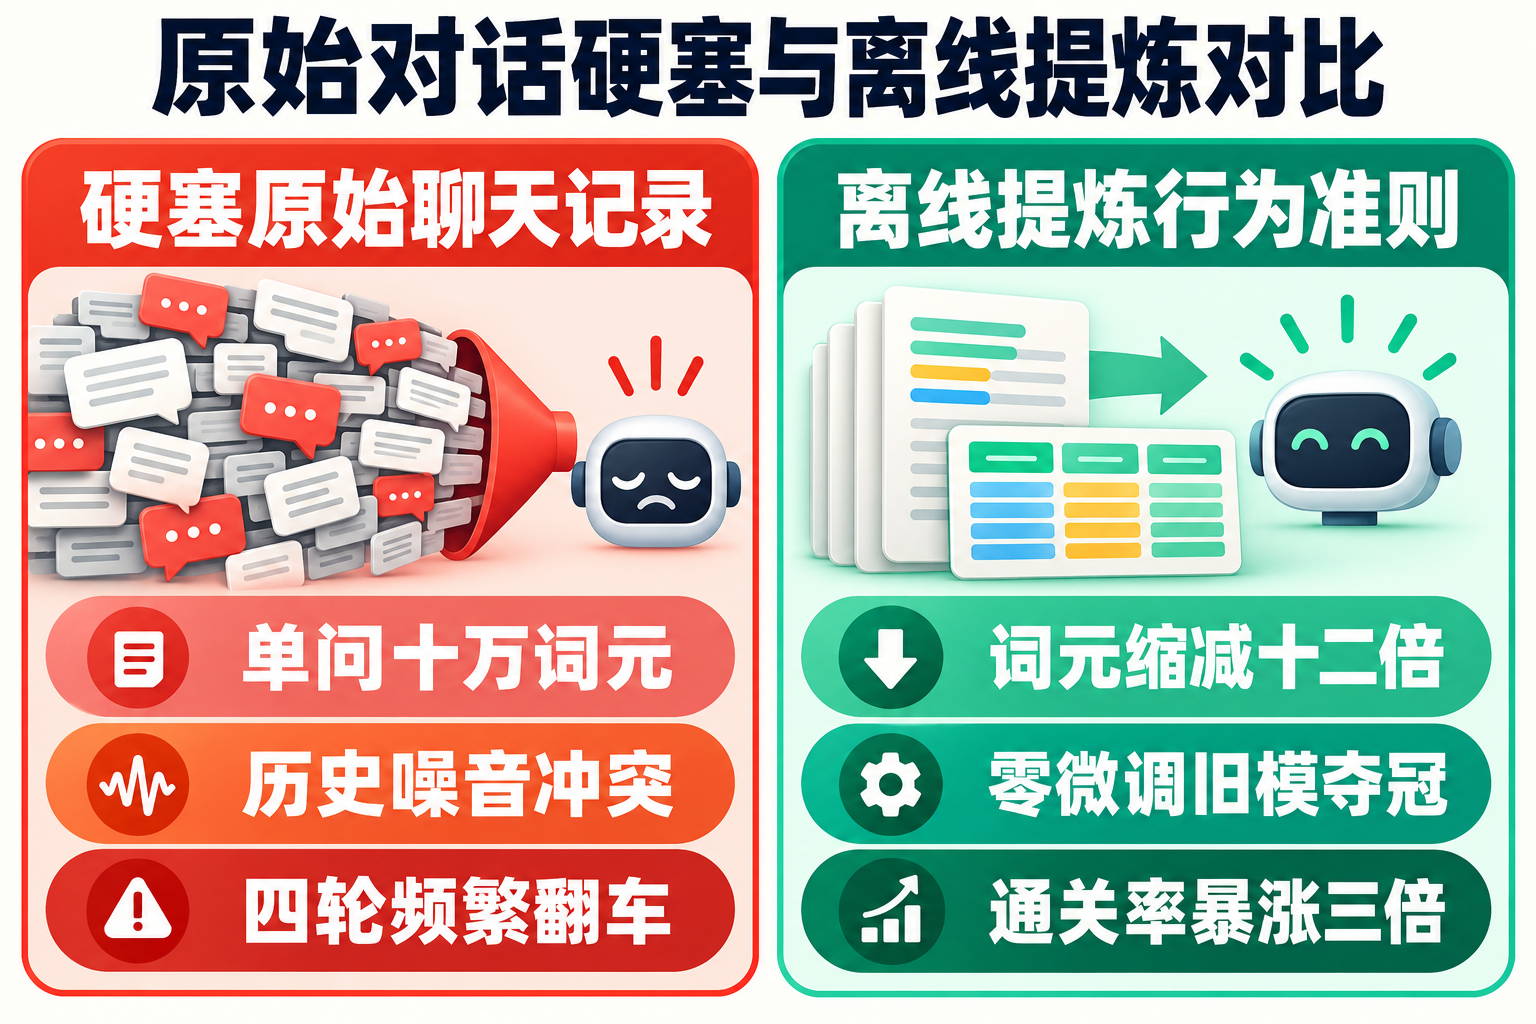
把百场原始对话塞进提示词不是记忆,只是花钱用历史噪音淹没当前指令。
支持度阈值截断与单步动作熔断锁死失误
ALTK-Evolve 从海量历史轨迹中提炼出的并非长篇大论,而是直接规范工具调用的行动准则。例如无邮箱时强制改用姓名与邮编鉴权;涉及退改等写库操作前,必须先行输出结构化摘要供用户确认;单轮交互只执行一个动作,严禁同时调用工具又拼接最终回复;遇到带数字后缀的组合用户名时自动清洗拆分,连续两次查询失败立即主动终止重试,直接向用户说明标准格式,绝不在未知状态下反复空转。
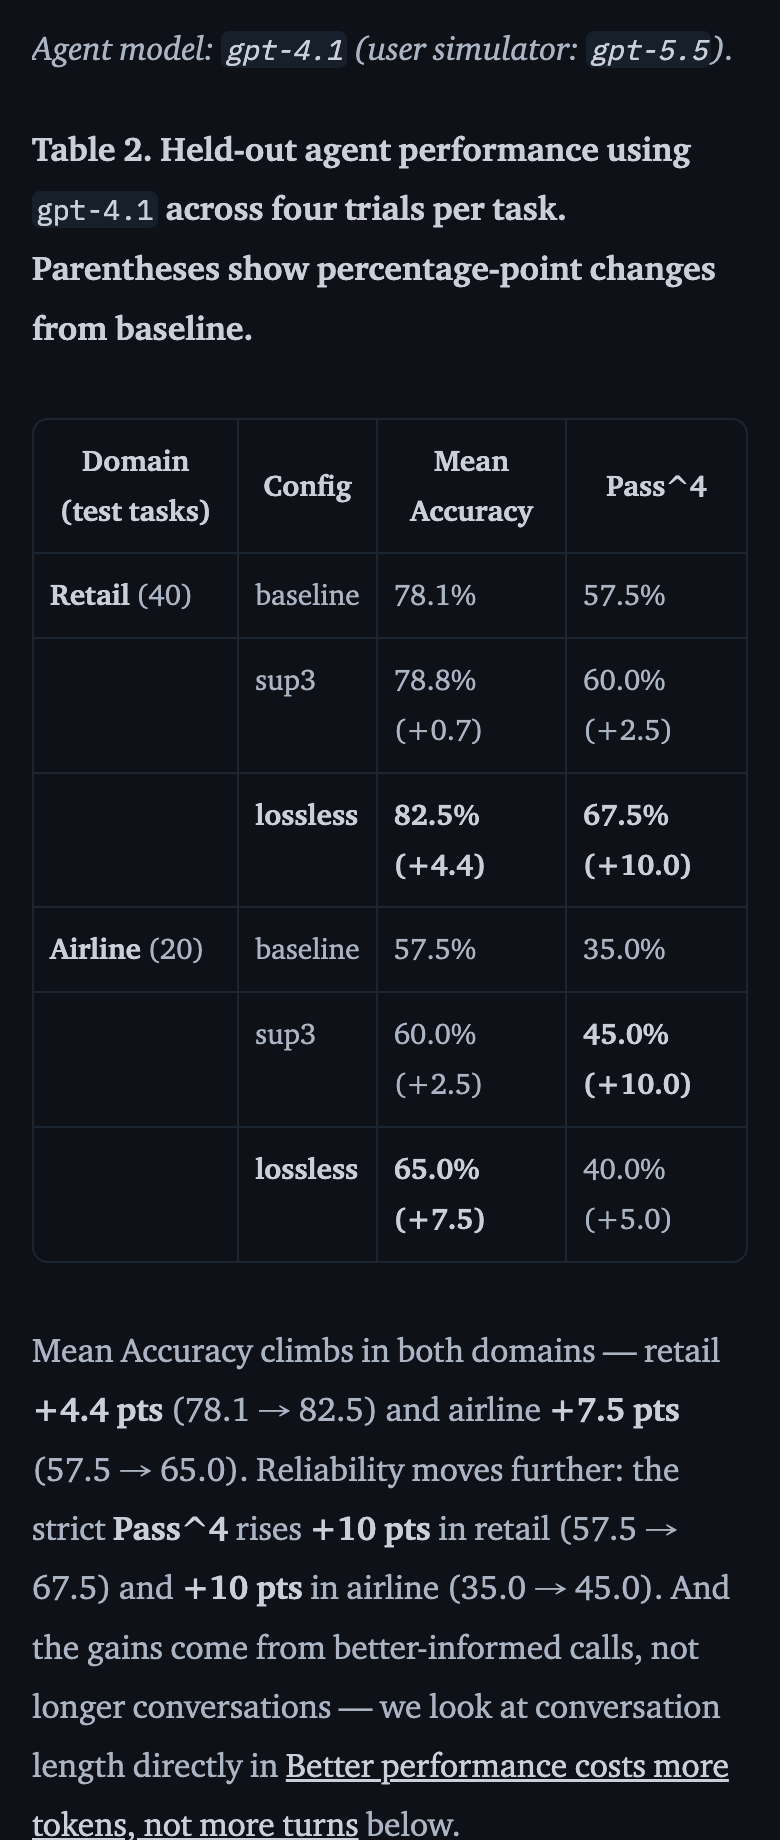
经验准则并非越多越好。在航空业务测试集上,若将全部 101 条规则无差别塞入提示词,Pass^4 全通率仅有 40.0%。偶发长尾案例提炼出的规则容易过度泛化,反而在常规任务中束缚模型。当引入支持度阈值截断,过滤偶然案例、仅保留在三个以上独立任务中反复出现的高频核心准则后,规则精简至 14 条,而全通率逆势升至 45.0%,单次提炼耗费仅 0.097 美元。在解决的任务上,平均交互轮数甚至缩短了半轮,配合提示词缓存几乎抹平了输入增量。
砍掉偶发长尾的碎片经验,高频验证过的精简铁律才能防住连续四轮零失误。
在线轻量索引与离线做梦管线解耦生产记忆
结合 Databricks MemCurrent 的落地实践,高可靠的智能体记忆系统可解耦为三个确定性工程层级。
首层是轻量索引与成熟工作流复用。无需耗资微调模型底层权重,会话初始化仅注入简短的目录索引与高频核心准则,将输入上下文控制在千级词元范围内。当用户请求查询跨表复杂统计时,智能体直接按需检索并调用固化的工作流,执行动作从原先探索阶段的 11 次工具调用大幅缩减至 2 次,办结时间从近六分钟压缩到四十一秒。
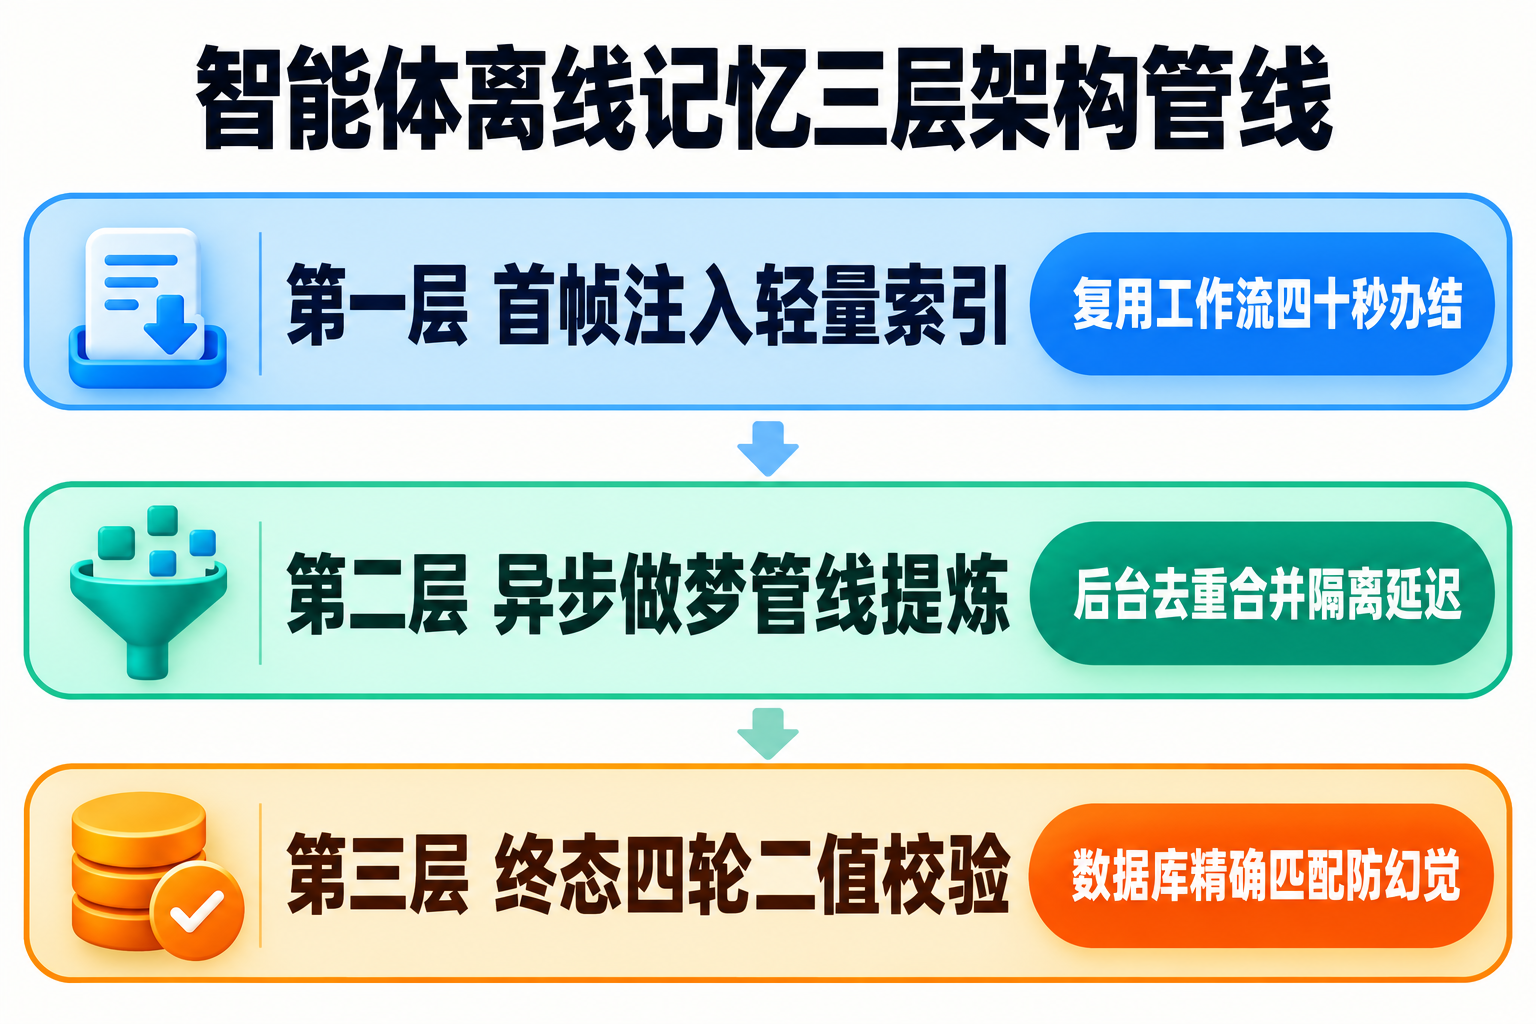
第二层是在线日志记录与离线提炼管线异步解耦。在线服务仅向底层存储追加结构化会话轨迹,避免增加实时交互延迟;后台离线批处理任务在业务低峰期启动,汇总分析历史成功与失败案例,提炼隐式规则并剔除过期冲突,实现规则库的低成本热更新。
第三层是数据库终态对齐与多轮回归检验。任何新提炼的准则在合入生产配置前,必须在留出基准集上接受连续四轮的端到端自动化测试,确保数据库写入状态毫厘不差,彻底杜绝未经检验的规则破坏线上稳定状态。
把耗时耗力的经验提炼移出实时对话,在线智能体才能既省下三成算力又把通关率翻三倍。