许多团队在部署大模型服务时常陷入硬件迷信,以为推理吞吐上不去是因为显卡算力不足,于是不断采购昂贵计算集群。然而在真实业务并发场景下,昂贵的高性能计算单元大部分时间都在空转停等,而显存总线却早已被塞得水泄不通。
这种现象如同开着八百匹马力的超级跑车,却被堵在单车道的乡村泥泞小路上走走停停。在自回归解码阶段,大模型每生成一个词元(Token),计算核心就必须把整整数百亿参数从显存完整搬运进运算单元一遍。计算单元真正进行浮点运算只花极短时间,剩下九成时间全在干等显存搬运数据。一旦并发请求增加,历史上下文缓存爆炸式膨胀,算力与显存的访存比失衡就会彻底卡死整条流水线。
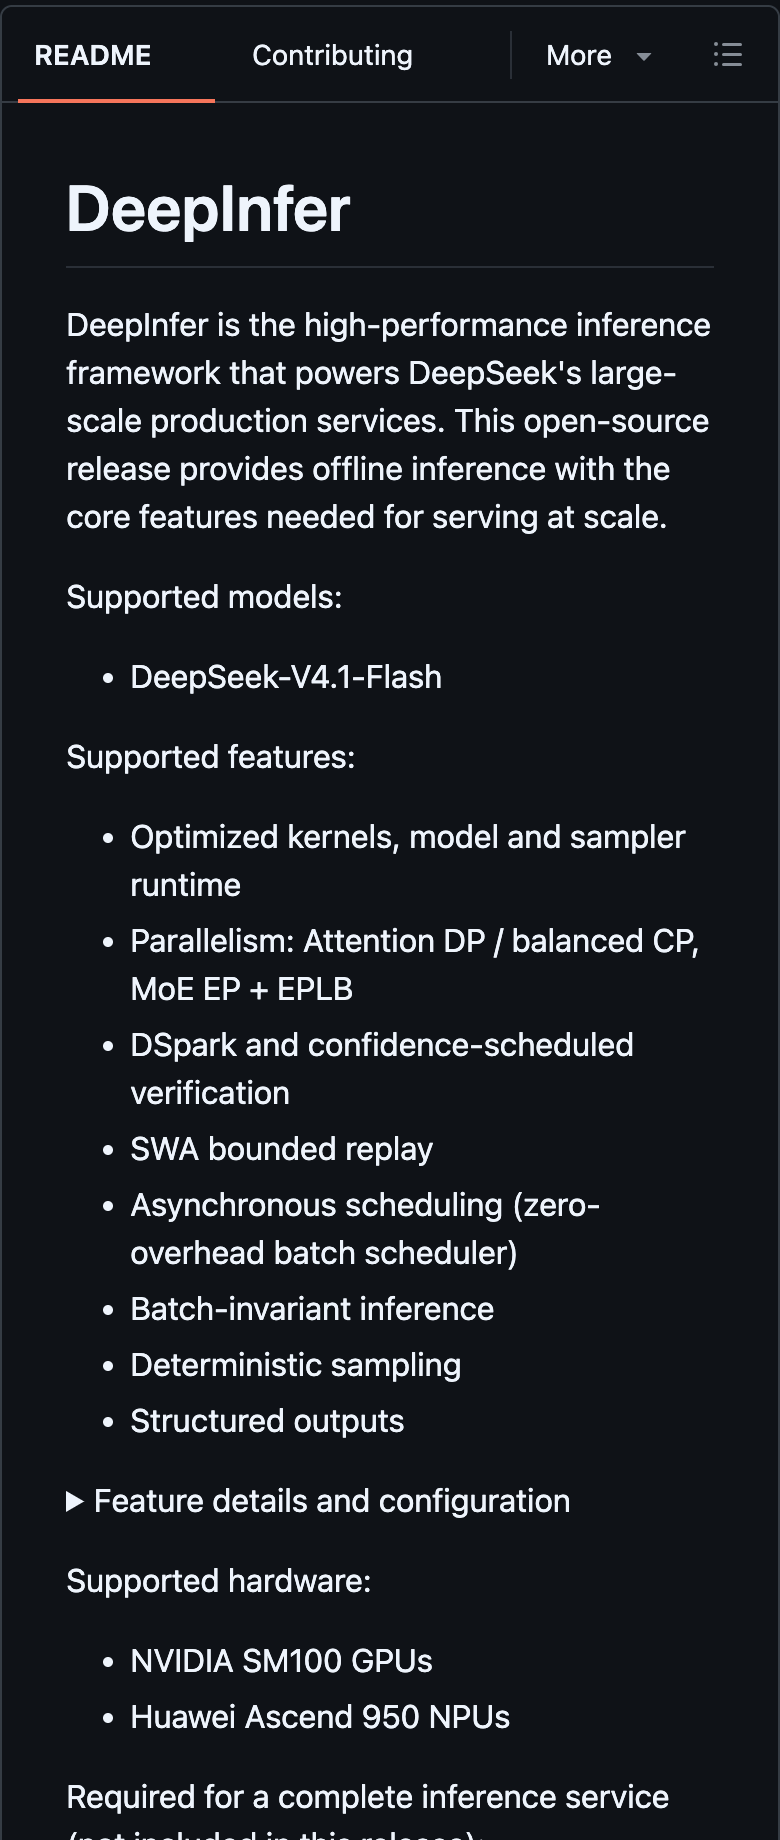
2026 年 10 月 20 日,DeepSeek 正式开源自家生产级推理框架 DeepInfer,以 Apache 2.0 协议向社区开放。该框架专为支撑旗下新一代多模态旗舰 DeepSeek-V4.1-Flash 大规模在线服务打造,在单个扩展域内以 4 张 NVIDIA SM100 显卡处理预填充、64 张卡处理解码,同时原生支持华为昇腾 Ascend 950 硬件平台。其核心价值在于不靠堆砌硬件盲目扩容,而是从底层重构了榨干物理算力的三个关键杀招。
显存带宽跑满而计算核心频繁停等
大模型推理包含输入预填充与自回归解码两个截然不同的计算阶段。预填充阶段一次性处理完整提示词,权重矩阵被充分复用,系统瓶颈落在芯片算力本身;但进入一个词一个词吐出的解码阶段后,计算性质发生根本性逆转,系统彻底退化为显存带宽受限。此时盲目扩大请求批次,不仅无法挽救停等的计算核心,反而会成倍消耗宝贵显存。
DeepSeek 团队并未沿用常规框架的粗放调度模式,而是自研了包括 FlashMLA、DeepGEMM 与 TileLang 在内的底层定制算子库,并在架构层面对推理流程进行深度重构。传统通用方案与 DeepInfer 的底层差异如下表所示:
| 架构维度 | 传统通用推理框架默认方案 | DeepInfer 生产级优化架构 | 实际工程收益 |
|---|---|---|---|
| 投机验证机制 | 固定步长机械逐轮全量校验 | 基于置信度动态调度验证步长 | 避免无效草稿词元挤占显存带宽 |
| 预填充上下文重放 | 回溯历史全量保留上下文缓存 | 滑动窗口截断仅留紧邻后缀 | 消除长文本回溯带来的显存暴涨 |
| 跨批次计算结果 | 并发批次不同导致浮点结果漂移 | 严格跨批次确定性对齐推理 | 彻底消灭偶发性幻觉并解锁自动化测试 |
| 调度开销控制 | 主机端批次调度阻塞计算执行 | 异步流水线重叠隐藏调度损耗 | 消除芯片等待指令的间隙停顿 |
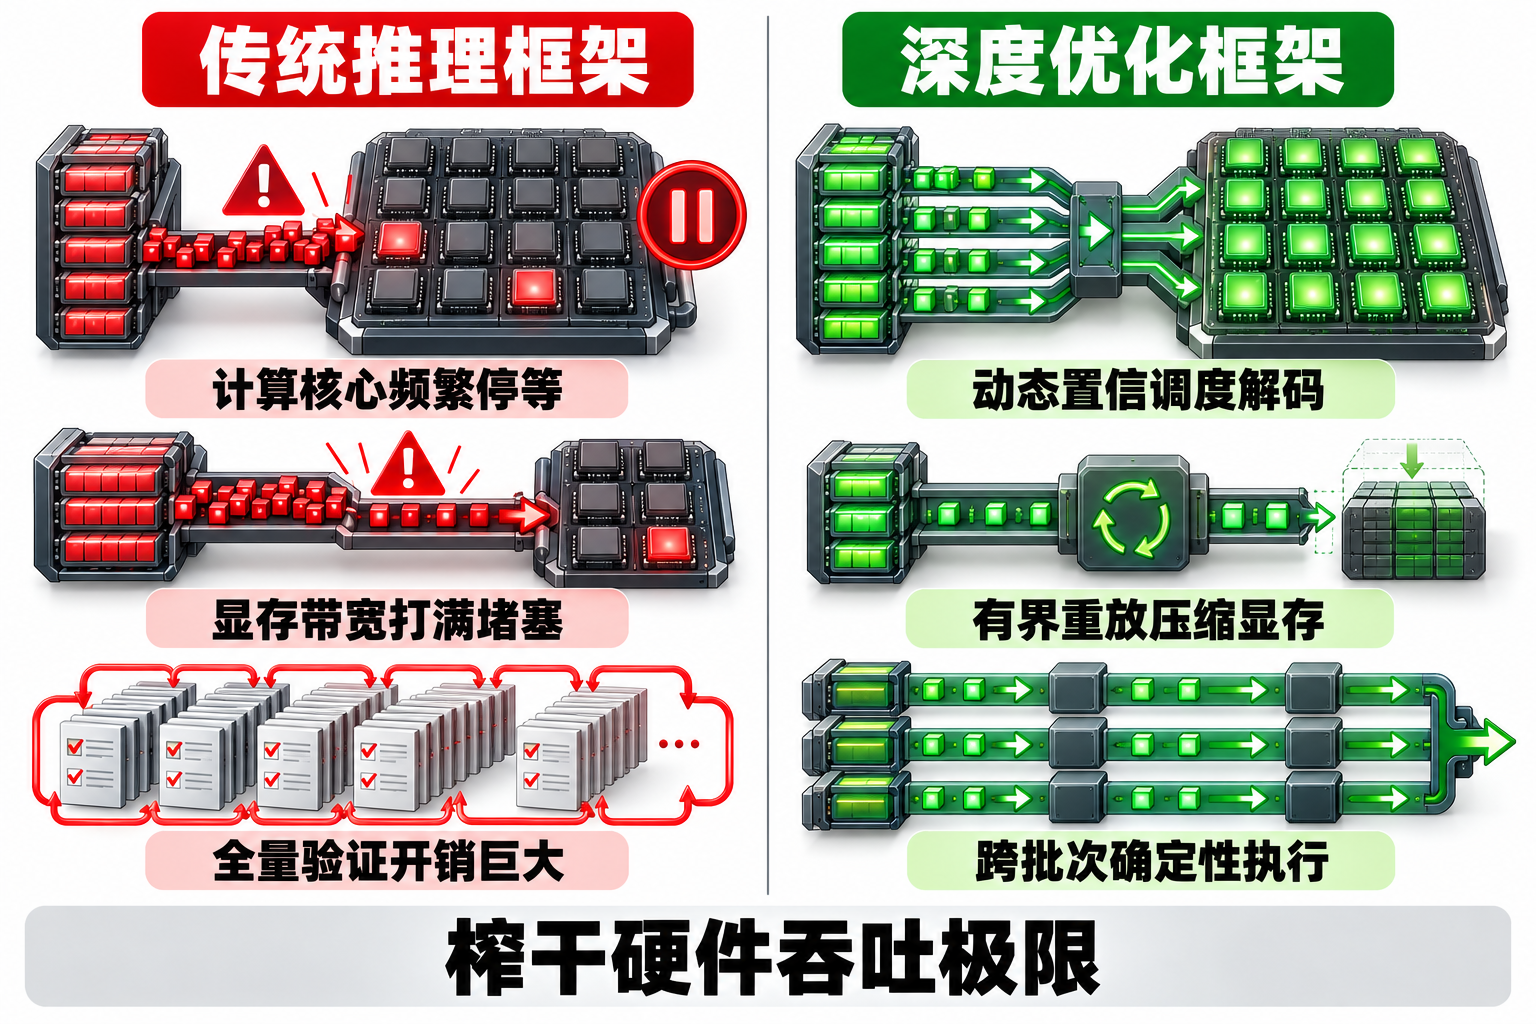
显存带宽是自回归解码的物理铁墙,算力跑得再快也救不了被搬运堵死的流水线。
动态置信调度与有界重放卸下重担
投机解码通过小模型生成草稿词元、大模型批量验证来加速推理,但在实际落地中常演变为负优化。若每一步都机械验证固定长度的草稿,遇到生僻词或逻辑分叉时,低置信度的错误草稿反而会触发大规模回退重算,白白浪费显存带宽。
DeepInfer 引入 DSpark 置信度调度验证机制。系统实时评估草稿词元的置信度分数,高置信度时平滑延展验证跨度,一旦置信度跌破安全阈值则立即主动熔断验证,绝不在低概率分支上反复空转消耗带宽。
与动态验证配合的是解码器滑动窗口注意力有界重放。在处理长上下文回溯任务时,传统架构倾向于完整保留全部历史缓存,导致显存占用随长度呈阶梯式激增。DeepInfer 通过紧凑截断模式,将预填充重放严格限制在覆盖滑动窗口与最大回溯长度的紧邻后缀上,默认仅保留 140 个词元。这一设计将预填充工作量从全量历史中剥离解耦,既保留了上下文局部相关性,又卸下了数十万历史词元的内存包袱。
在未知分支上主动熔断停手,轻量组装局部上下文才能为硬件卸下无效负担。
跨批次确定性推理消灭并发漂移故障
在企业生产落地中,最令工程师头疼的莫过于偶发性故障。同一道提示词,在本地单测运行时能稳定返回标准 JSON,上线接入高并发网关后,却因每次拼入的请求批次不同导致浮点累加顺序改变,生成的内容随之随机漂移。这种非确定性让自动化回归测试与安全合规验收几乎沦为空谈。
DeepInfer 在底层实现了跨批次确定性推理。通过重构底层核函数与算子累加机制,框架保证模型输出严格独立于同批次其他请求的存在或排列顺序。当启用确定性采样参数并固定随机种子时,无论系统处于单请求闲置状态还是高并发满载批次,相同的输入必然产生绝对一致的二进制输出。
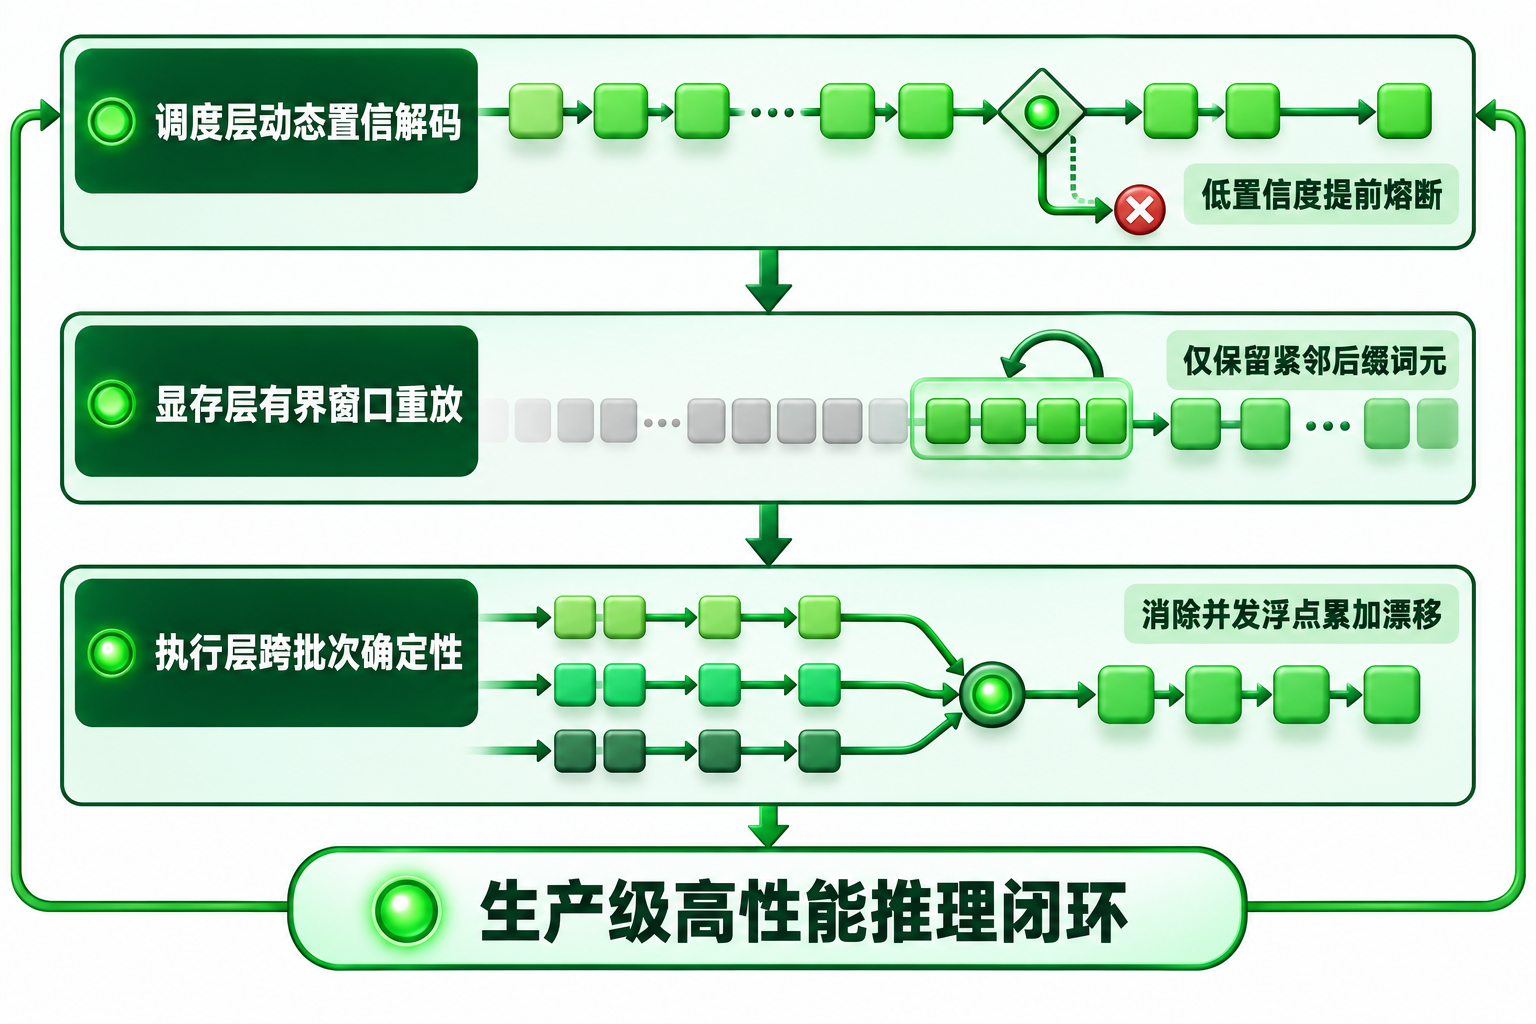
这一特性首次在生产环境消除了高并发与确定性测试之间的鸿沟。研发团队无需在发布前靠运气抽检,而是能够像对待传统核心数据库一样,为智能体与模型服务建立严格的端到端自动化断言流水线。
消灭并发批次的随机漂移误差,确定性可复现才是大模型走向生产的真正底线。