很多团队在给智能体搭建运行沙箱时,最先见顶的物理资源往往直奔服务器内存。
为了让智能体验证一段带数据库交互的代码,传统做法通常是起一个独立的容器,或者在公用数据库里新建一个库。一个测试任务往往只执行三秒钟,但为了这三秒钟,宿主机却要老老实实拉起完整的后台服务进程。这就好比一位租客只是想进屋洗个手,房东却非要在空地上现场给他盖一栋带地基的大楼;洗完之后,再开挖掘机把大楼推倒重来。
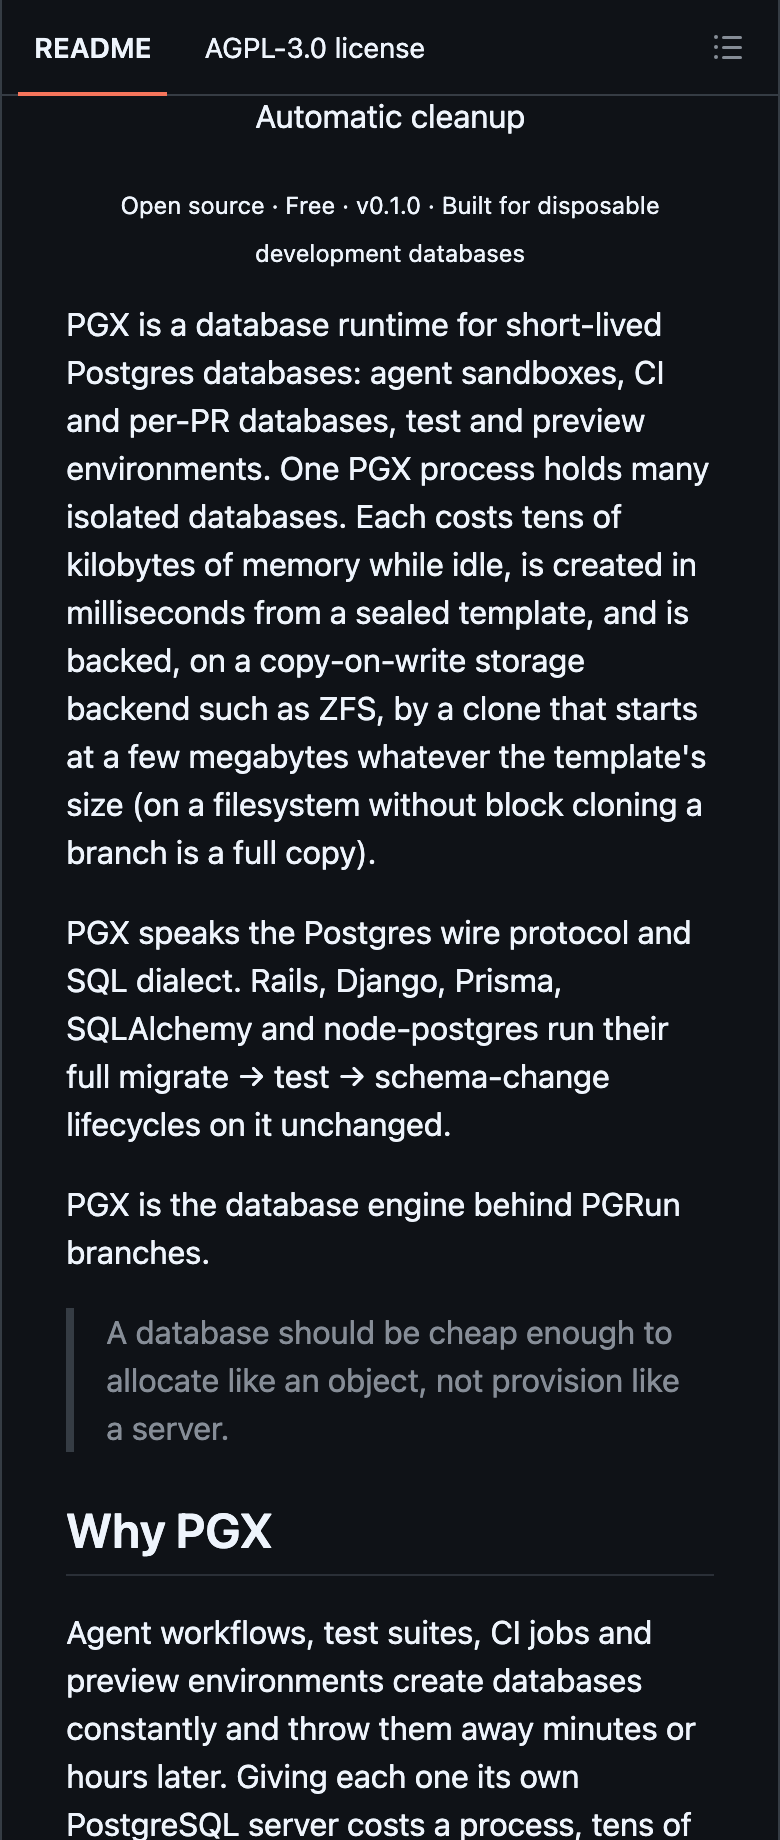
并发跑几十个智能体,机器内存就会被吃得一干二净。冷启动的漫长等待,甚至远超智能体写代码的时间。最近在开源社区受到广泛关注的轻量数据库运行时 PGX,从底层架构打破了这一僵局。
为测两行业务代码非要开整台数据库吗
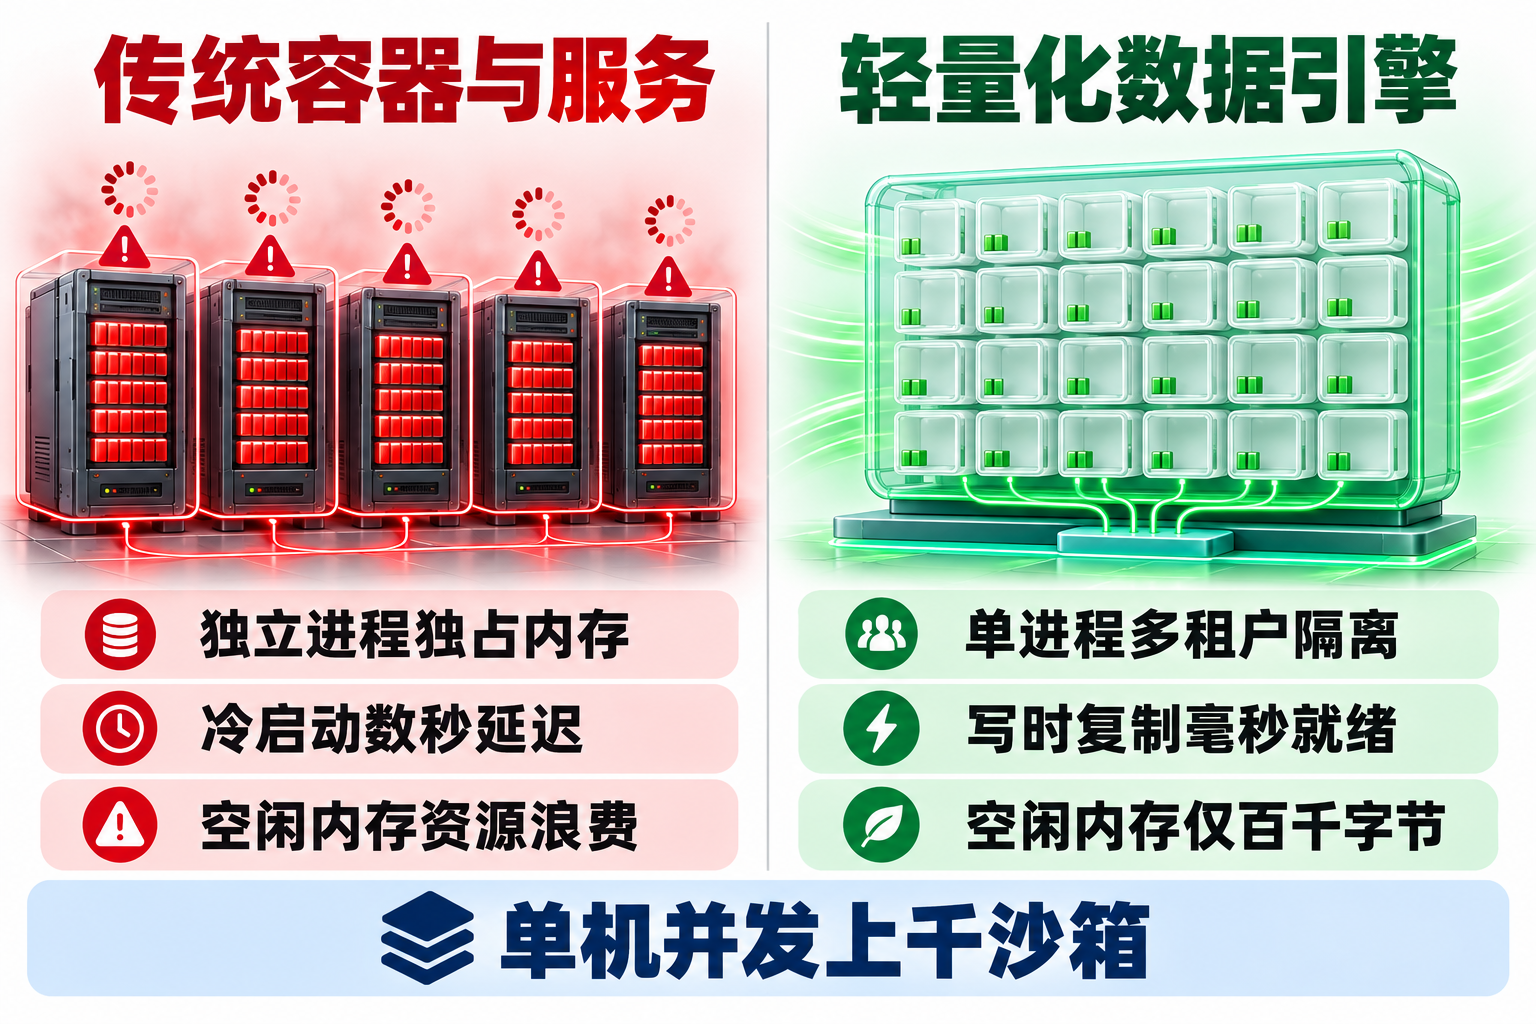
传统数据库在诞生之初,底层预设就是为长期运行的中心化主库服务的。
它默认自己要稳定运行数年不宕机。为了达成这个目标,系统会预先划走几十兆甚至上百兆共享内存缓冲区,常驻专门的数据字典与后台清理线程。一个完全不写入数据的原生空闲数据库实例,什么都不干就要常驻近十七兆内存。
但智能体对数据库的需求彻底反过来了。它的执行生命周期极短:连上库、跑完数据迁移、塞入测试数据、执行验证、随即彻底扔掉。
把专为常驻数年打造的重型服务,硬塞给每分钟起停上百次的智能体任务,系统必然走向资源内耗。智能体需要的仅仅是一个毫秒级随用随扔的一次性纸杯。
| 对比维度 | 传统容器或原生数据库实例 | 轻量化多租户数据引擎 | 实际工程收益 |
|---|---|---|---|
| 单库空闲内存开销 | 单个实例常驻约十六兆内存 | 未触碰约七十千字节查询后百余千字节 | 内存占用暴降九成以上 |
| 沙箱创建等待延迟 | 容器数秒至云服务数十秒 | 预热池六毫秒冷克隆七十四毫秒 | 消除等待实现无感随连随用 |
| 大模板分支存储 | 全量拷贝耗时数分钟占满磁盘 | 写时复制数百毫秒初始增量十余兆 | 磁盘与存储读写节省九成 |
| 多租户隔离与清理 | 手动脚本清理残留僵死进程 | 分层配额主动熔断超时自动注销 | 杜绝多任务并发相互打扰 |
| 场景定位与边界 | 稳定运行数年的生产数据主库 | 专为测试和沙箱打造的抛弃型实例 | 明确边界各司其职不越界 |
只读元数据全量共享每个分支只买单差量
面对短生命周期沙箱的物理约束,轻量化的核心哲学就是把不可变的数据全量共享,让每个分支只为自己的差量买单。
在传统模式里,一个数据库对应一套服务进程。而在轻量架构下,单个运行时进程内部采用线程级模型,统一承载成百上千个彼此独立的逻辑数据库。同一个模板派生出的所有沙箱实例,在内存中直接复用完全相同的表结构与元数据字典缓存。这意味着,未被任何请求触碰过的空闲数据库,在内存中仅仅占七十千字节;即便执行完查询,也只留存百余千字节上下文。
在底层存储方面,系统借助写时复制技术实现块级克隆。一个十吉字节体积的模板数据,派生出一个独立可写的全新分支仅需六百多毫秒,初始新增的物理存储只有十三兆。
各个分支虽然在底层共享绝大部分只读数据块,但在逻辑上完全独立互不影响。智能体在沙箱里随意增删改查甚至回滚,都只会把修改写在自己的私有差量层上。这种解耦组装的思路,让系统彻底摆脱了全量拷贝历史数据的沉重包袱。
分层资源限制直接熔断闲置实例自动注销
多智能体高并发场景下,另一个令人头疼的问题是邻居干扰。
某个智能体生成了一段死循环联表查询,或者试图往表里塞入几百万条假数据,极易把整台宿主机的资源全部拖垮。为此,引擎在内部构建了会话级、数据库级和运行时级的三层内存配额防线。一旦单个会话或数据库超出预设额度,系统会直接返回错误码主动熔断该连接,而绝不让失控任务拖慢其他正常运行的沙箱。
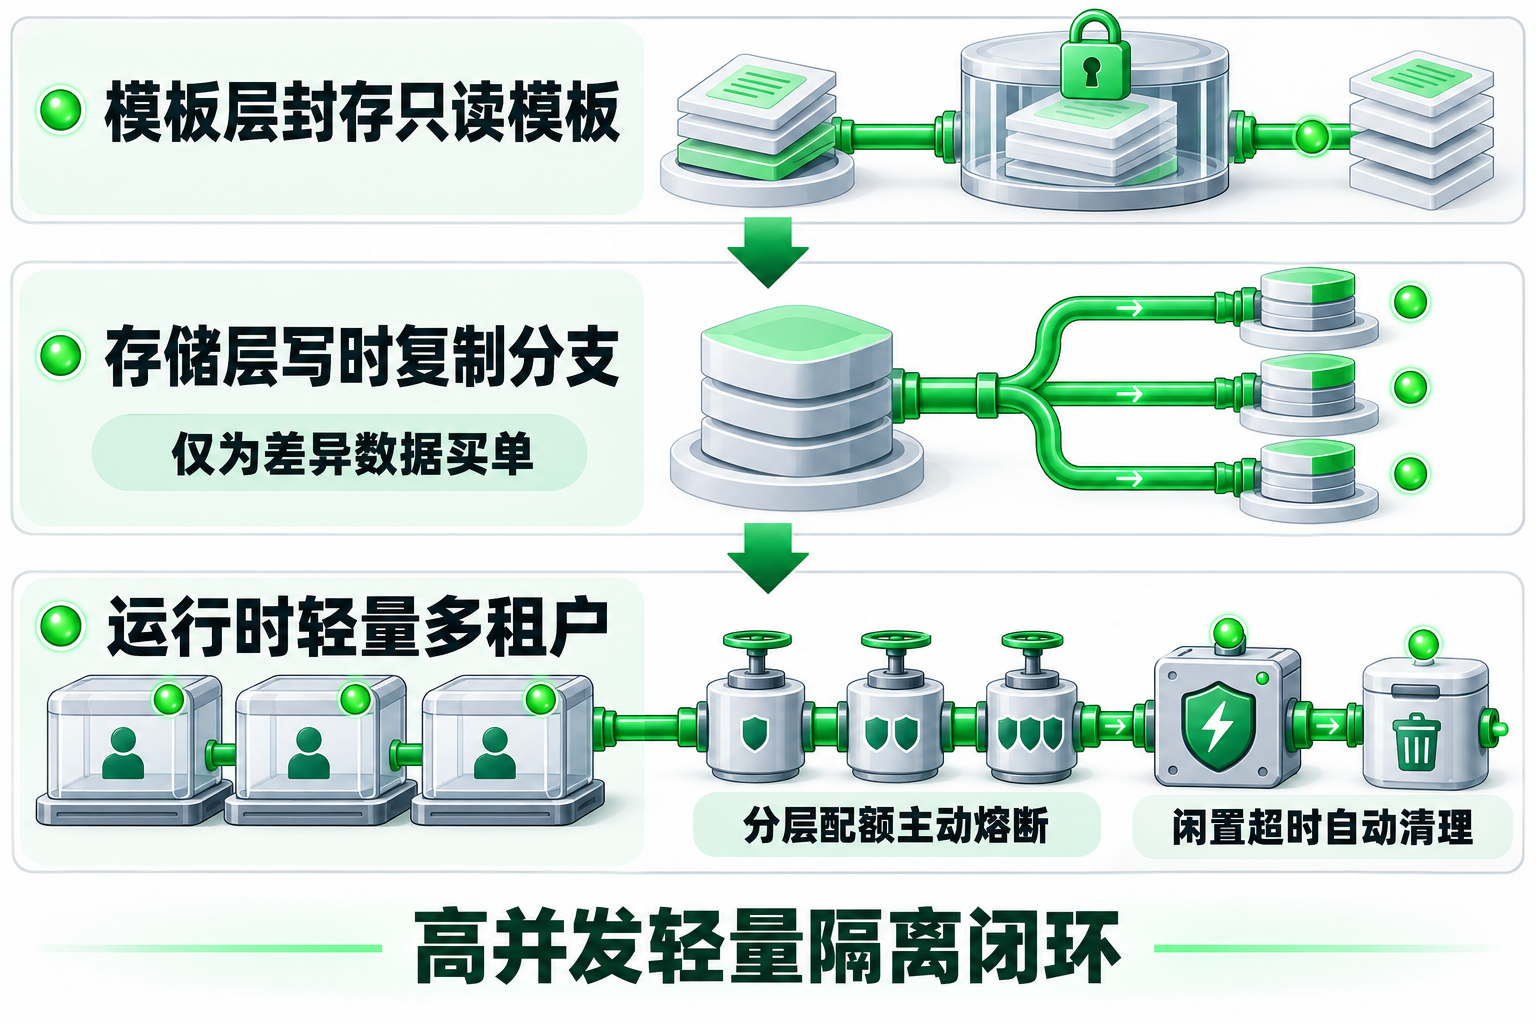
同时,系统内置了连接即创建机制。客户端只需按约定名称发起连接,系统便会在几毫秒内就地激活沙箱。任务结束且连接全部断开后,后台清理协程会在宽限期后自动注销并回收该数据库,无需工程师编写复杂的垃圾回收脚本。
在测试兼容性上,官方回归测试套件中有二百二十三项达成字节级完全一致。主流框架涵盖迁移、测试、表结构变更的数十项综合测试全部顺利通过。拥有干净且确定性的执行环境,自动化测试流水线才能给出真正可信的验证结论。
必须清醒指出的是,这种抛弃型轻量引擎有着极为严格的使用边界。它默认关闭了事务持久化落盘,追求的是极致吞吐与高并发密度,绝不能拿来当做生产环境的持久化主库。承认工具的局限性,把一次性沙箱做到极致,这正是智能体基础设施进化的正确方向。
