在常见的研发流程中,智能体提交改动并提示完成后,工程师仍需启动测试、检查日志,把失败信息送回对话,指定下一次修改。代码生成结束了,实验却还在等人推进。在 KDD 2026 的演讲中,Jeff Dean 介绍了新团队 Discovery Loop 的探索方向,希望把这个断点交给机器接管。
传统研发被拆成多个环节,团队需要协调进度、争用计算资源。该团队计划让机器自主跑完“提出设想、落地运行、评估结果、持续迭代”的完整实验闭环。他们计划先从机器学习自身的研发与工程任务入手,把内部技术栈作为初期验证对象。需要说明的是,这次查阅的官网和演讲材料没有提供可供比较的产品基准或成本数据。在当前规划中,自动化闭环成立的前提,是被测系统允许机器自主执行完整操作。
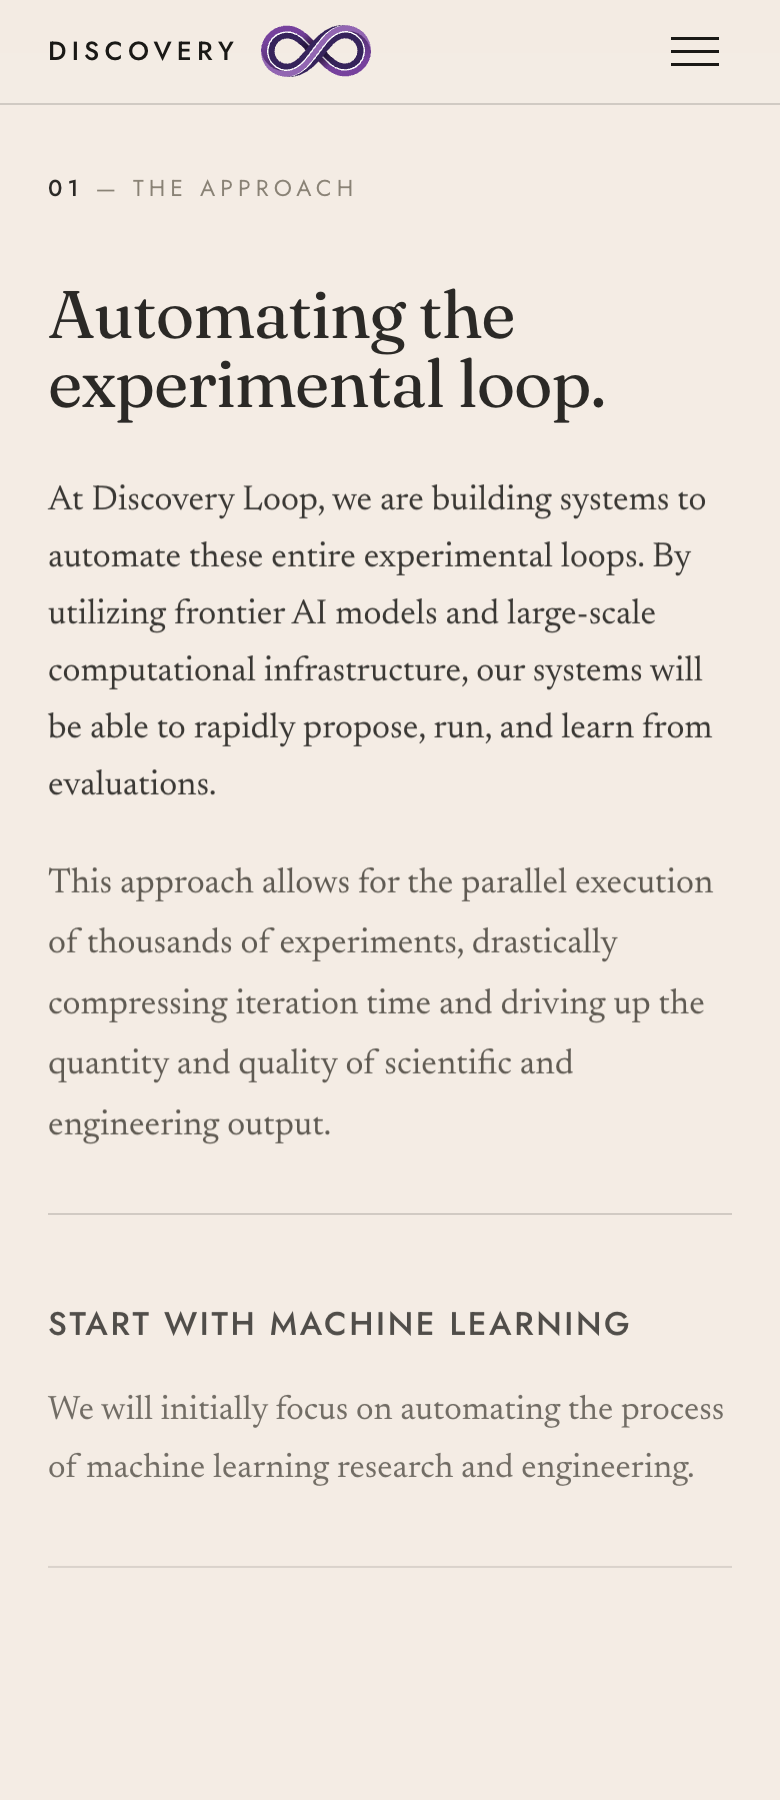
截图来自 Discovery Loop 官网。页面使用“正在建设”和“将会”的措辞。
验收结果驱动下一轮修改
自动迭代需要一套能排除噪声、自主判定改动好坏的验收机制。 如果评估流程无法独立稳定运行,智能体的后续探索就会失去参照。
以服务接口优化为例,可以先固定请求集、测试环境和运行条件,在隔离分支运行候选改动。正确性通过后,再重复测量延迟与内存消耗,避免把一次偶然波动当成改善。
假设第一轮修改缩短了耗时,却漏掉空输入处理。验收程序将失败请求、预期输出和实际输出返回智能体。模型补回处理逻辑,再用同一请求集重测。只有正确性通过、重复测量也显示改善,候选才进入合入评审;失败候选不合入,但记录保留。这是设计示意,并非 Discovery Loop 已公开的实测。
每轮结果都应参与下一次修改。达到验收目标,或耗尽预设的资源与轮数预算时,流程停止并留下结果。这些停止条件是工程建议,需要由团队事先定义。
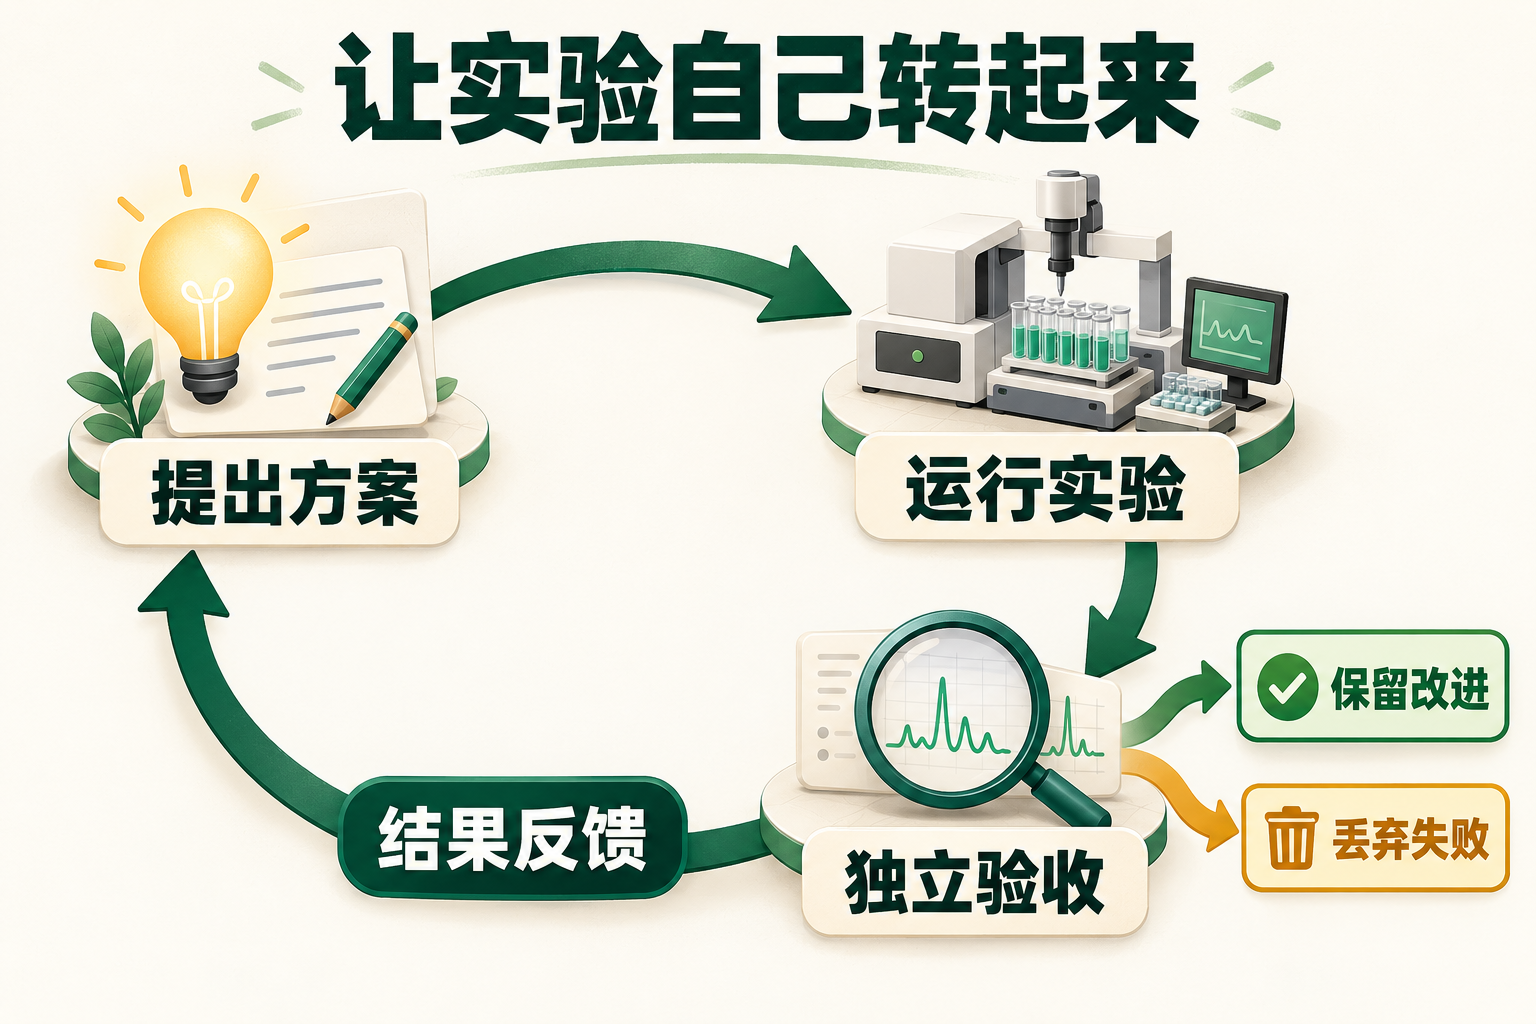
图中丢弃失败候选,仍保留实验记录供下一轮使用。
演讲中提及的分级推进策略也遵循类似逻辑。在机器学习与硬件设计中,流程通常先用轻量级小实验或高层模拟筛选大量设想,再将少数方案送入高成本验证。这种逐步放大的过滤机制,目的是减少昂贵试验的浪费。
离线指标仍需线上验证
这种机制允许团队重新探索早期的基础架构选择,但是否划算仍需测量。它并不意味着所有复杂的科学探索与系统架构问题都能在短期内直接交给脚本托管。
自动化闭环天然依赖可量化的客观标尺。离线测试集上的指标提升,并不等同于真实生产环境能够获益;如果评估标准覆盖不全,片面的数值提升甚至可能损害未覆盖的边界路径。目前这类闭环更适合规则明确、反馈周期较短的工程任务,例如慢 SQL 调优、检索相关性对比或预训练数据的清洗配比。
在机器接管实验之前,工程师的核心任务依然是在代码之外定义好严密、可复现的验证标准。
参考来源
