很多工程师在搭建自主智能体工作流时,都遭遇过令人窒息的延迟瓶颈。智能体每往前执行一步,后台调用就要原地愣住 2 到 3 秒。
这种感觉就像铁路调度员在道岔前拦停了高速列车。调度员不看信号灯指示,非逼着司机当场写一篇几百字的议论文,论述接下来该走左轨还是右轨。表面上看推理非常严谨,但整条干线的运行效率已经被彻底拖垮。
在多步骤的生产系统中,智能体九成以上的调用根本不需要文采。在智能体的控制流水线里,做决定不需要文采,需要的是毫无歧义的道岔;把概率生成模型从控制台上请下来,系统才能真正跑进毫秒级闭环。让自回归大模型在每一步吐出长段文本,是用耗费几千个 token 的沉重算力,在做极其简单的离散路由。
提取一个布尔标记让模型写满屏幕
日常开发中最常见的反模式,是让大模型在每一步都输出一段包裹着思考过程的结构化文本。
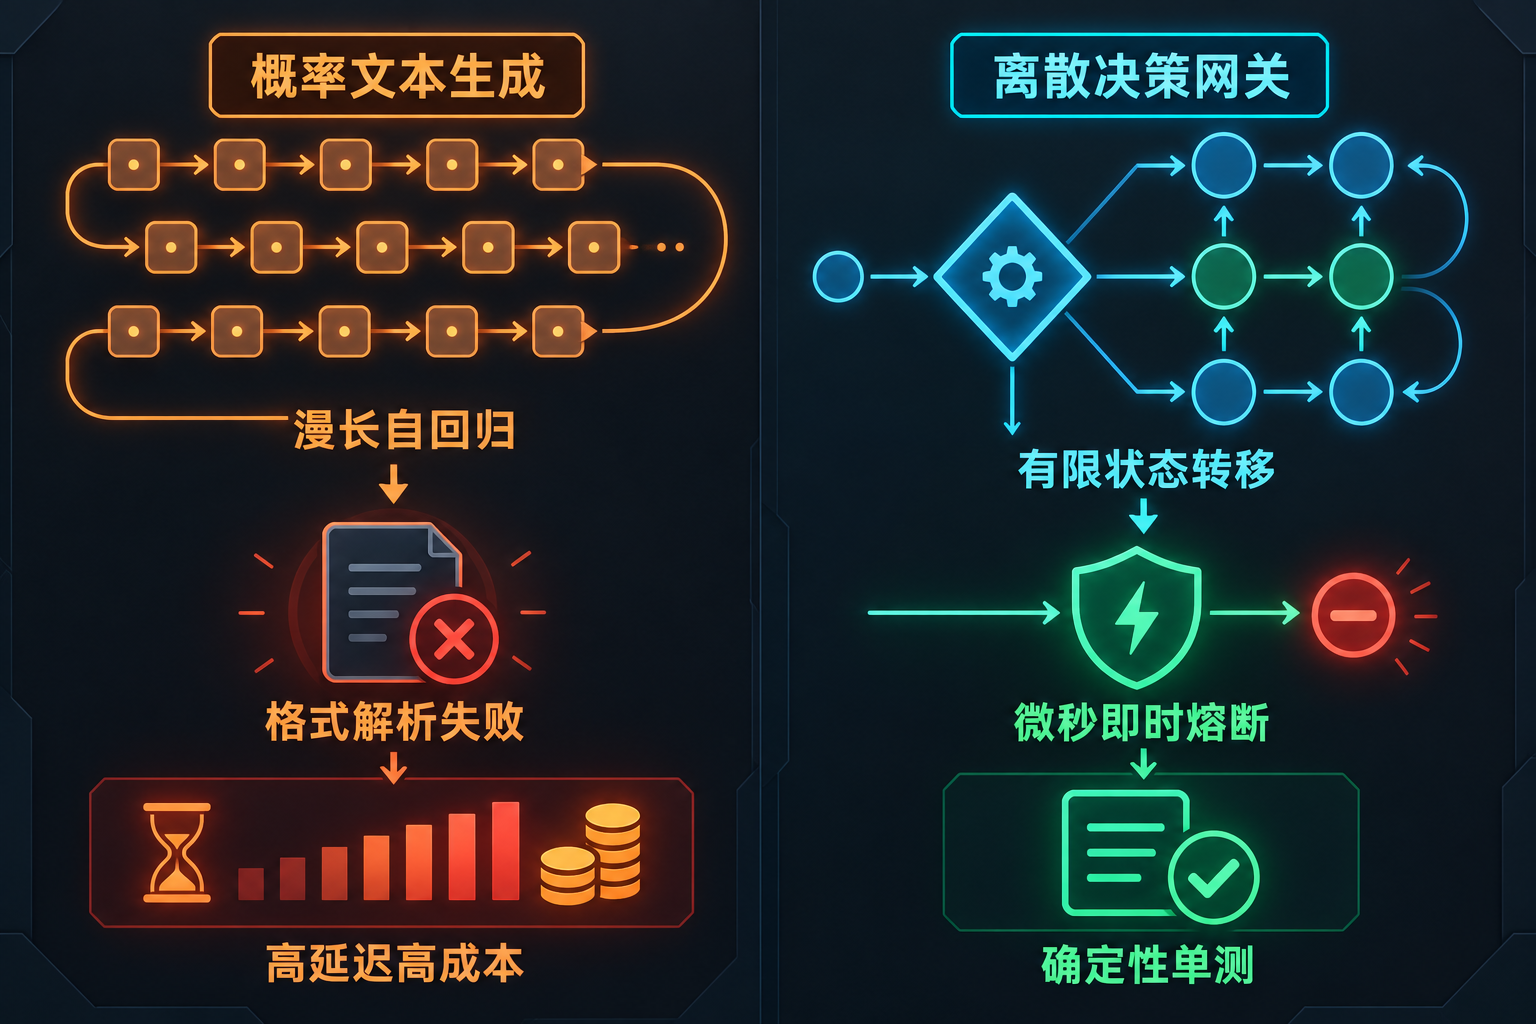
工程师为了让智能体决定下一步是继续执行、调用工具还是转交人工,往往在系统提示词里写满规则。模型只能从第一个词元开始逐字自回归推演。它先输出一大段前因后果分析,最后才在末尾吐出包含决策字段的代码块。
我们在生产日志里经常看到这类片段。为了提取一个简单的布尔标记,系统硬等了两百个词元。机器在网络两端不断传输冗长字符。一旦模型在末尾漏掉反括号,或者在文本中插入了解释性废话,下游的反序列化解析器当场崩溃。
让自回归生成模型负责系统的状态转移,本质上是在用概率推演替代确定性开关。 这种做法平白浪费算力,更让原本坚固的状态机时刻面临解析崩溃风险。在面对高并发业务或者实时交互时,整套流水线很快就会被漫长等待拖垮。
彻底砍掉生成框的调度网关跑进毫秒级
针对这一工程痛点,OpenAI 近期商用上线的 Decisions API 走向了完全相反的方向。
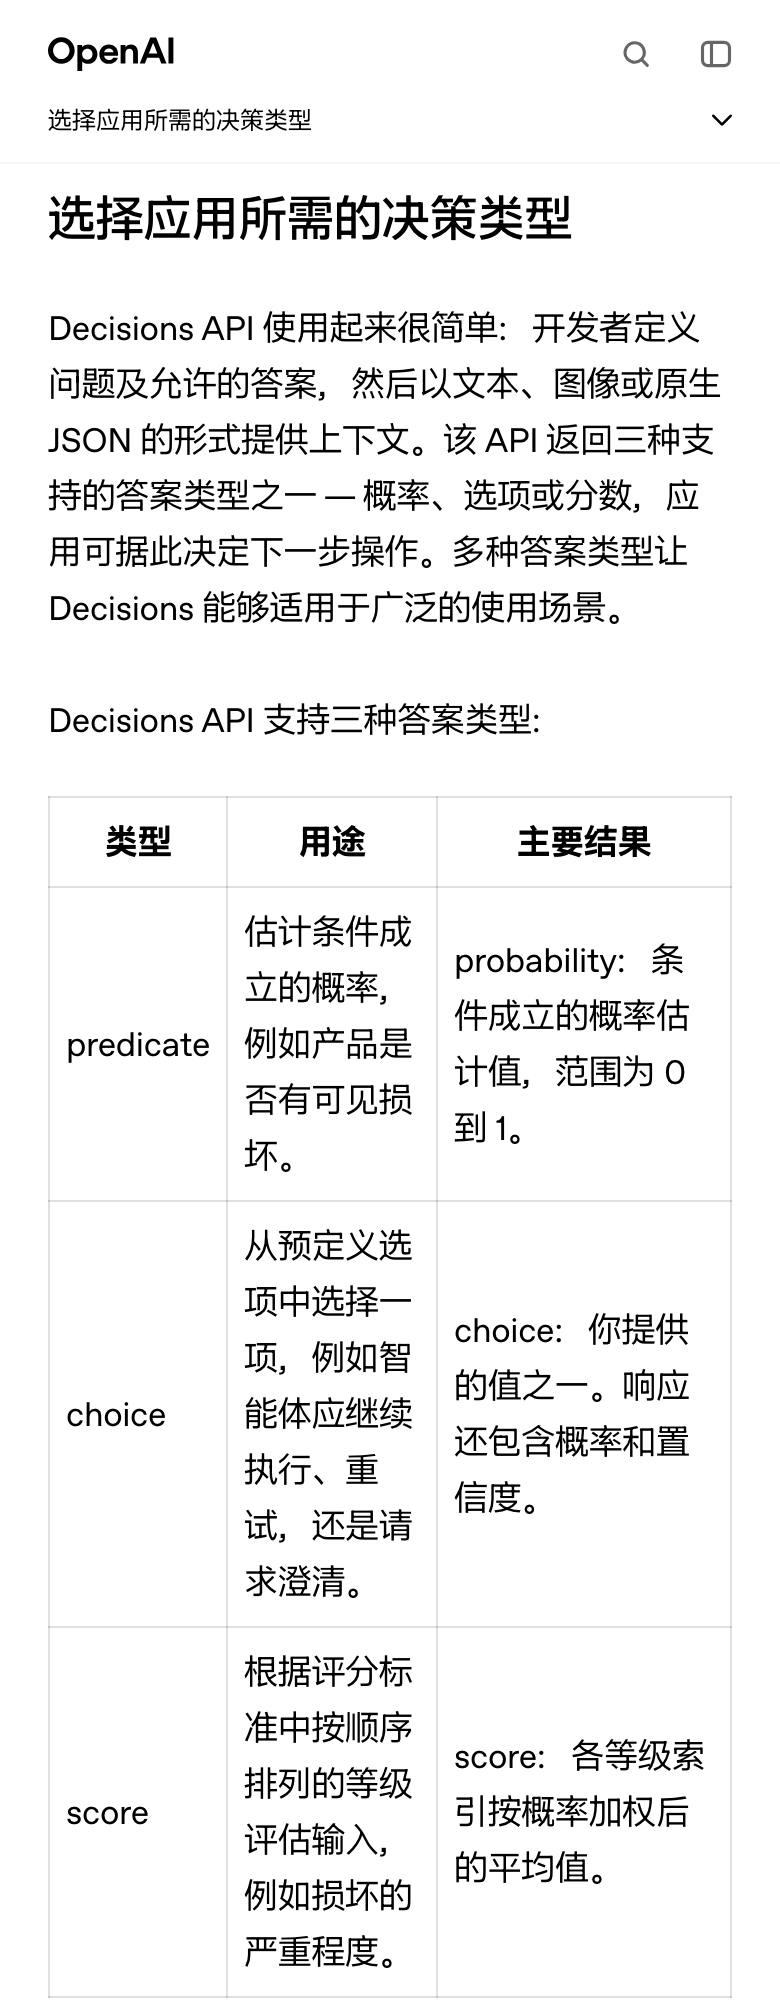
这个基于 GPT-6 Luna 的接口彻底删除了自由文本生成框。模型完全不吐自然语言文字,输出被严格锁死在三种确定性数学类型中。第一种是条件概率 predicate,直接评估某个风险假设的发生概率。第二种是枚举选项 choice,直接在预设选项中做单选并附带置信度。第三种是规则评分 score,按照预定标准直接计算综合分值。
裁剪掉文本生成后,性能出现了断崖式改变。Datadog 用它在智能体执行自动化排障命令前实时审查终端命令风险。过去调用前沿模型审查风险,响应耗时往往长达十多秒,根本无法放入热路径。改用离散决策网关后,端到端延迟直接缩减了 40 倍,稳定压进 280 毫秒以内。
智能体客服调度耗时同样压缩至 280 毫秒以内,单次通信成本大幅下降了 90%。语言学习工具的动作响应时间从 1.4 秒压缩到了 0.13 秒。没有了长文本的自回归等待,状态流转终于跑进了真正的毫秒级闭环。
| 评估维度 | 传统自回归生成模式 | 专用离散决策网关 | 工业落地收益 |
|---|---|---|---|
| 输出形式 | 带有推导过程的长文本 | 严格有界的概率或枚举 | 彻底消灭文本反序列化崩溃 |
| 执行时延 | 单次交互数秒至十余秒 | 稳定收敛至数百毫秒内 | 首次允许放入核心执行热路径 |
| 计算成本 | 随着上下文和生成词暴涨 | 仅针对有限答案计算分值 | 关键节点单次调用成本骤降九成 |
| 工程定位 | 适合发散的内容创作生产 | 专职担任状态机的逻辑道岔 | 控制逻辑与生成执行彻底物理隔离 |
把状态道岔与沙箱生成彻底做物理隔离
工业级系统的演进历史反复证明,控制面与数据面绝不能混为一谈。做决定的道岔越简单坚固,上层奔跑的列车才能开得越快。
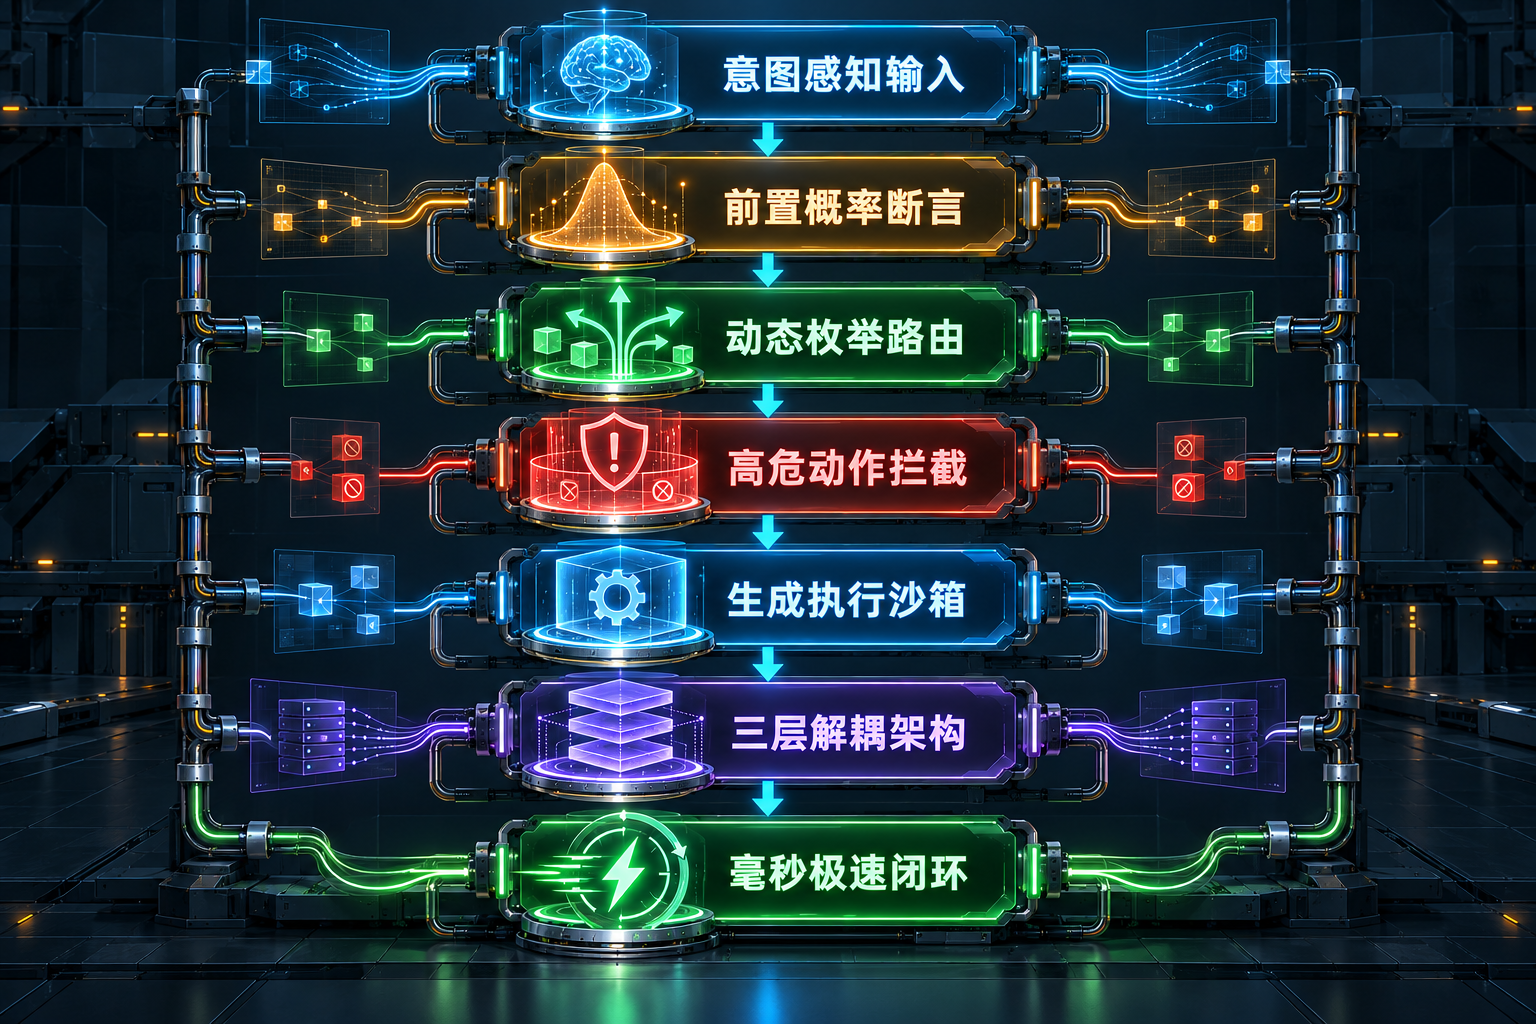
面向大规模生产环境,团队必须把控制流与生成执行解耦为三层防线。
第一道防线是前置快速熔断。在任何危险物理命令执行前,先通过概率断言进行毫秒级风险扫描。实测只要不到 10 毫秒即可返回判定。一旦风险评分超标立刻在入口阻断,根本不需要启动大模型去编写详细的拒绝理由。
第二道防线是正交枚举路由。把原本塞在巨大提示词里的调度规则拆分出来,外挂成独立的轻量决策节点。每个节点只负责判断当前状态的唯一流向,让状态机清晰可测,不再因为提示词相互踩踏而失控。
第三道防线是真正的沙箱生成。只有当状态流转明确需要创作复杂内容或者编写代码时,才派发给全尺寸大模型。此时模型被安置在隔离容器中专注处理文本,不再分心去兼顾底层状态的维护。
把状态道岔交还给离散网关,把内容创作交给生成模型。卸下自回归生成的繁重枷锁,智能体流水线才能真正兼顾确定性与极速响应。
