很多工程师在调试长周期智能体时,都经历过当场抓狂的失控现场。前十分钟里,模型像个经验丰富的大架构师,三言两语就把业务模块拆得清清楚楚。可随着几轮测试命令跑下来,控制台吐出几万行编译与报错日志后,它突然像换了一个脑子。它开始反复执行刚刚报错的命令,甚至把最初立好的架构规范忘得干干净净。这就像让一位顶级大夫做精密手术,助手却把拆下来的满地带血纱布和废旧器械全堆在了手术台上。
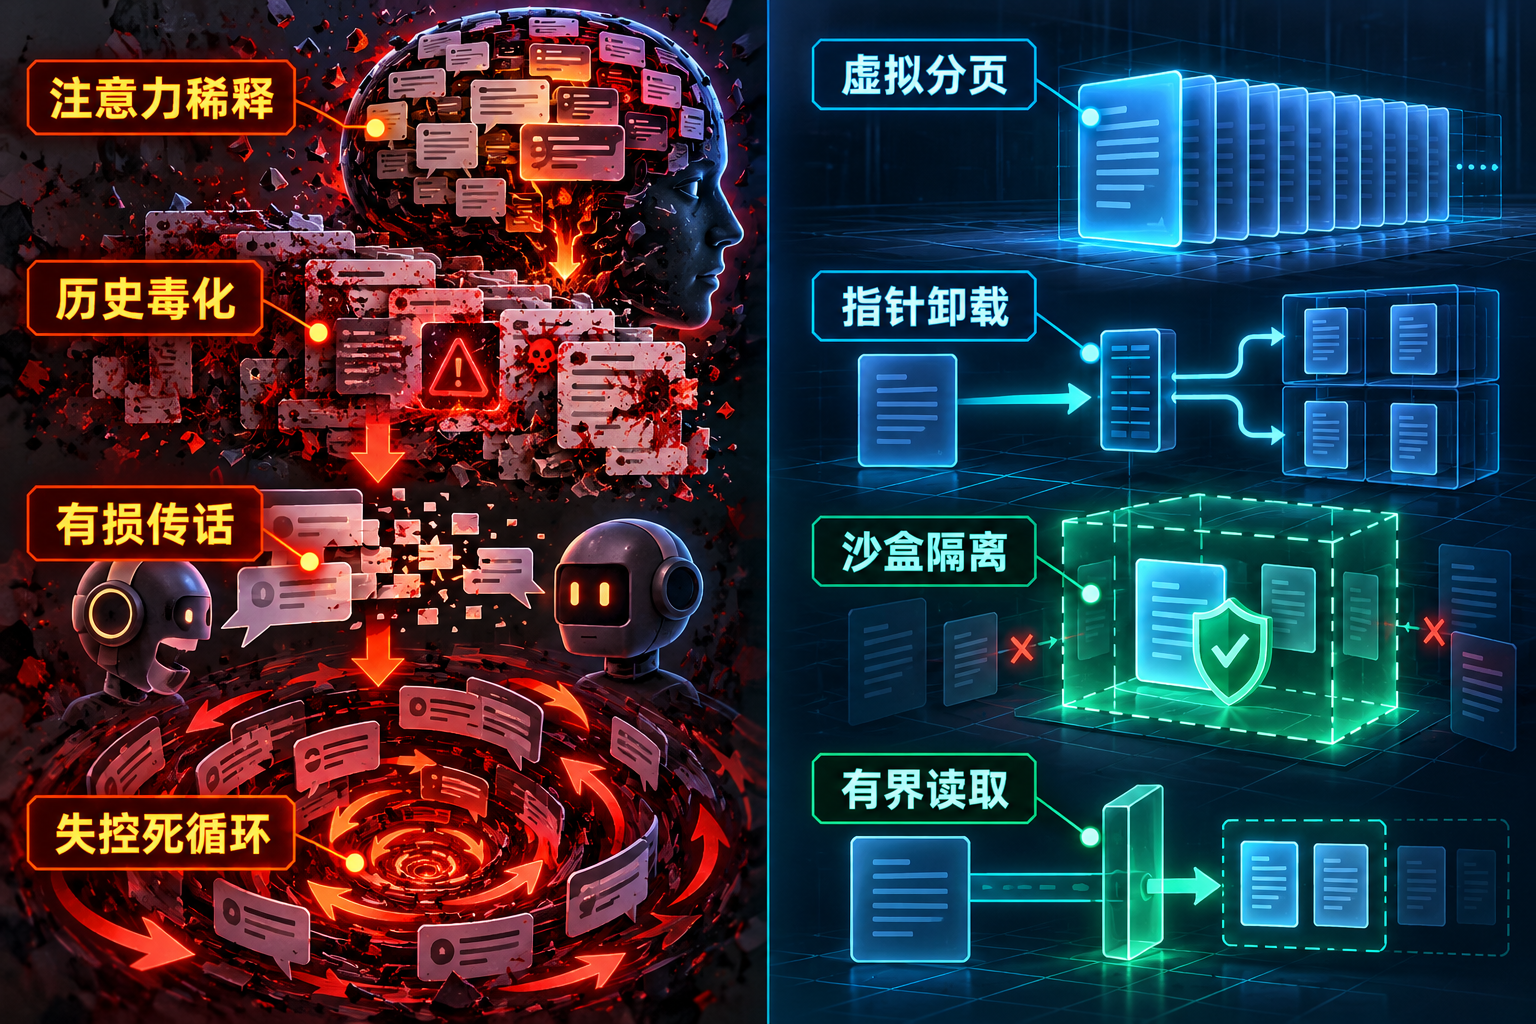
漫长日志把模型的注意力稀释成了白噪声
很多人的第一反应是去找更大窗口的模型。行业宣传动辄百万级上下文,让人产生了一种把整个代码库硬塞进去就能解决问题的错觉。
然而注意力的数学本质是一场残酷的零和博弈。自回归模型的注意力权重总和永远是一。当上下文只有两千字时,核心指令和架构规范占据了三成以上的注意力权重。当控制台涌入数万行冗余的依赖警告和长日志后,最初的业务约束在数学上被稀释到了不足百分之一。模型没有真正失忆,但在海量文本噪音的淹没下,核心指令在计算层面彻底跌破了召回阈值。
更糟糕的是自回归的错误级联。模型生成的每一个字都会成为下一轮推理的前提事实。一旦历史记录里混入了一次失败的尝试,这个错误动作就会变成牢不可破的先验经验。模型为了迎合过去的错误历史,最终陷入难以自拔的死循环。
经过传话的历史切片正在放大误解
很多框架试图用自动摘要来拯救膨胀的上下文。只要会话快装不下了,就让大模型把前面的对话压缩成一段简报。
但自然语言压缩是一场充满损耗的传话游戏。第一轮压缩丢掉了具体的函数签名,第二轮压缩丢掉了边界检查条件,到了第三轮只剩下一堆正确的空话。大模型会根据模糊的概括脑补出不存在的参数,让整个系统在暗中脱轨。LangChain 刚刚开源的 Deep Agents 底座揭示了一个冰冷的事实。长任务智能体随着运行时间拉长必然遭遇上下文腐烂。盲目在聊天窗口里堆叠记忆,只会让系统的推理能力加速崩塌。
| 维度 | 全量聊天记录堆叠 | 外挂虚拟内存换页 |
|---|---|---|
| 存储载体 | 模型有限上下文窗口 | 本地结构化文件系统 |
| 数据形态 | 冗长原始日志与会话 | 精简摘要加路径指针 |
| 执行机制 | 混乱单体混合调用 | 专职短命子任务沙箱 |
| 状态追踪 | 飘忽不定的概率记忆 | 确定性物理文件快照 |
像操作系统换页一样把脏数据挡在门外
真正的解法在半个世纪前的计算机体系结构里早就写清楚了。上下文窗口远非容纳一切的硬盘,它是极其昂贵精密的计算寄存器。长跑智能体需要的是一套类似操作系统的虚拟内存换页机制。
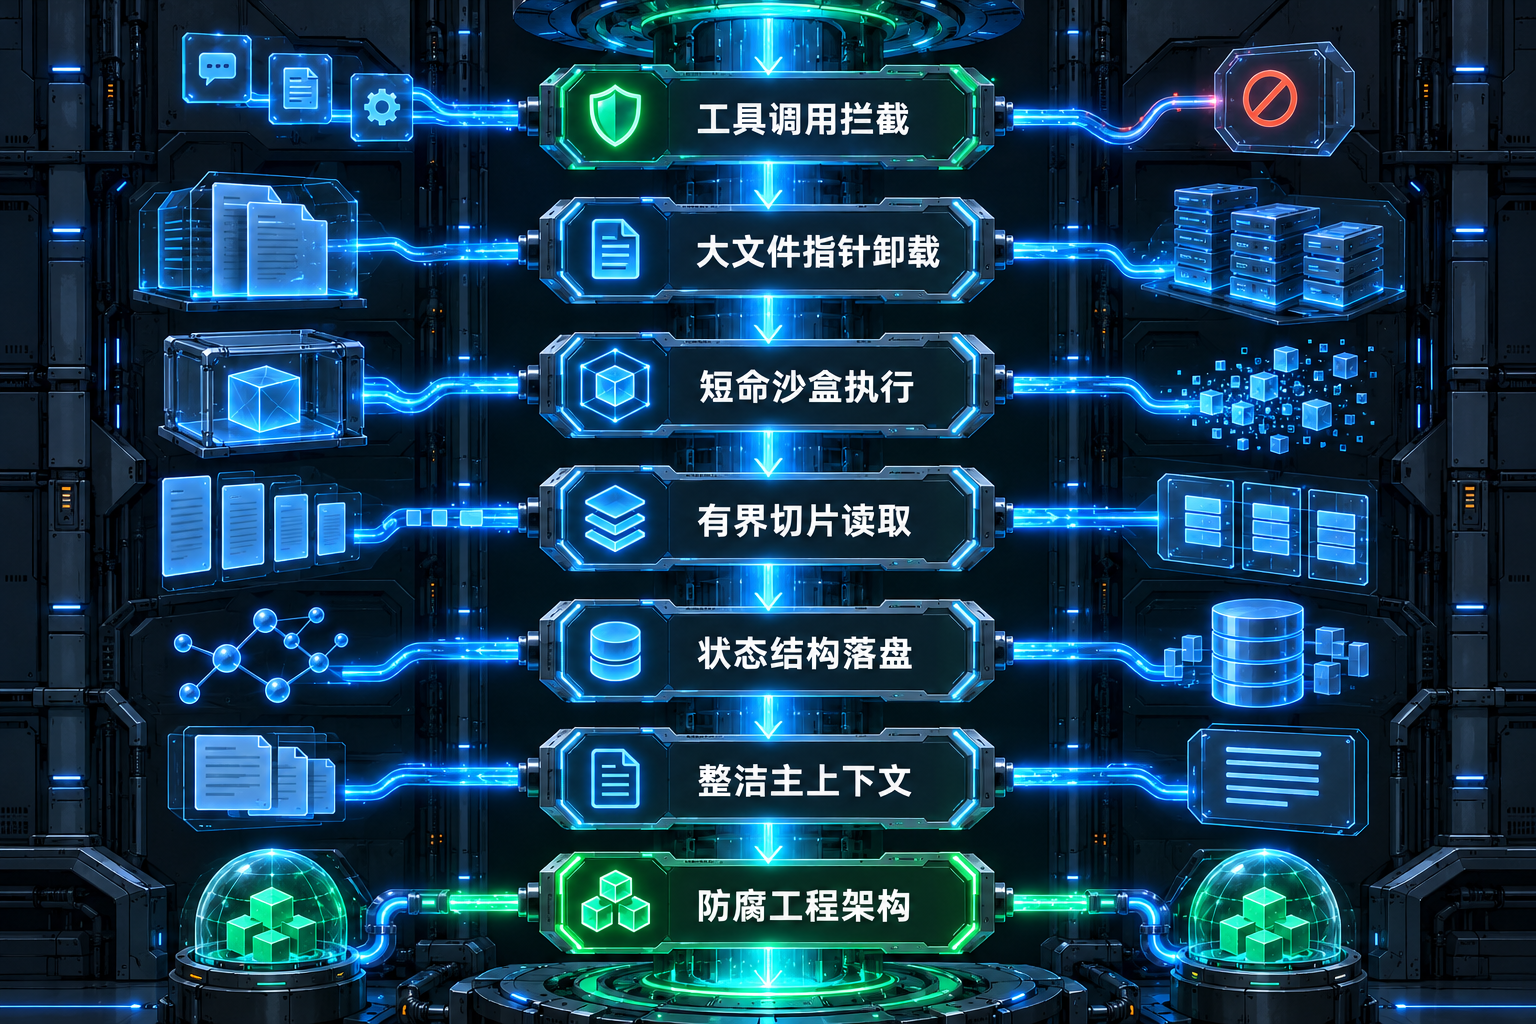
第一道防线是工具输出前置拦截。当测试或检索命令吐出超过两万字的超大结果时,中间件立刻在模型窗口之外强行截断。数据完整写入本地磁盘文件,只给大模型递过去五行内容预览与物理路径指针。大模型需要特定细节时,再通过切片工具去按需翻阅。脏数据从源头被挡在门外,手术台永远保持干净。
第二道防线是短命专职沙箱。复杂的排查任务交给独立子智能体去办。它带着专属检查项在独立沙盒里摸爬滚打,产生数万行调试过程也不要紧。任务完成后它只向主干交回简短结论并立刻销毁。主干上下文纤尘不染,没有沾上任何调试污垢。
第三道防线是物理状态文件落盘。不再依赖模型凭感觉记住任务进度。把全部状态和决策写成结构化的工作清单。决定长跑智能体上限的根本指标,是能否把脏流彻底阻挡在门外。
当大模型上下文窗口越来越大时,聪明的工程团队反而开始做减法。让上下文回归核心思考,把庞杂信息交给成熟的文件系统,智能体才能在复杂的现实任务中真正跑完马拉松。
公开参考
- LangChain Deep Agents 开源底座 https://github.com/langchain-ai/deepagents
- LangChain 上下文工程技术博客 https://www.langchain.com/blog/context-engineering-deep-agents-remember
