半夜三点被警报惊醒是每个值班工程师的噩梦。监控面板上的核心指标全面泛红,排障频道里的报警消息快速刷屏。面对突发的线上故障,很多人都曾设想过让全自动智能体接管一切,直接冲上去敲几行命令把服务救活。然而在真实的分布式系统里,如果盲目给大模型开放生产环境的写操作权限,模型在自回归概率的扰动下敲错一行配置,往往会让局部的偶发波动瞬间演变成全线宕机的巨大灾难。这就好比机房线路冒烟时,值班员没有排查短路电表,反而把灭火器交给了盲目奔跑的机器人。
概率推导不具备生产写操作的确定性
为什么生产环境绝不能把修改权限交给大模型?
大模型在本质上是一个自回归概率推导引擎。面对海量堆栈日志,它极度擅长生成一段听起来合情合理的逻辑解释。
然而线上系统的真实故障往往伴随着错综复杂的跨服务链路依赖。一个表面上的 HTTP 504 超时请求,真实根因可能是上游配置提交失误、下游数据库锁竞争或者偶发网络丢包。
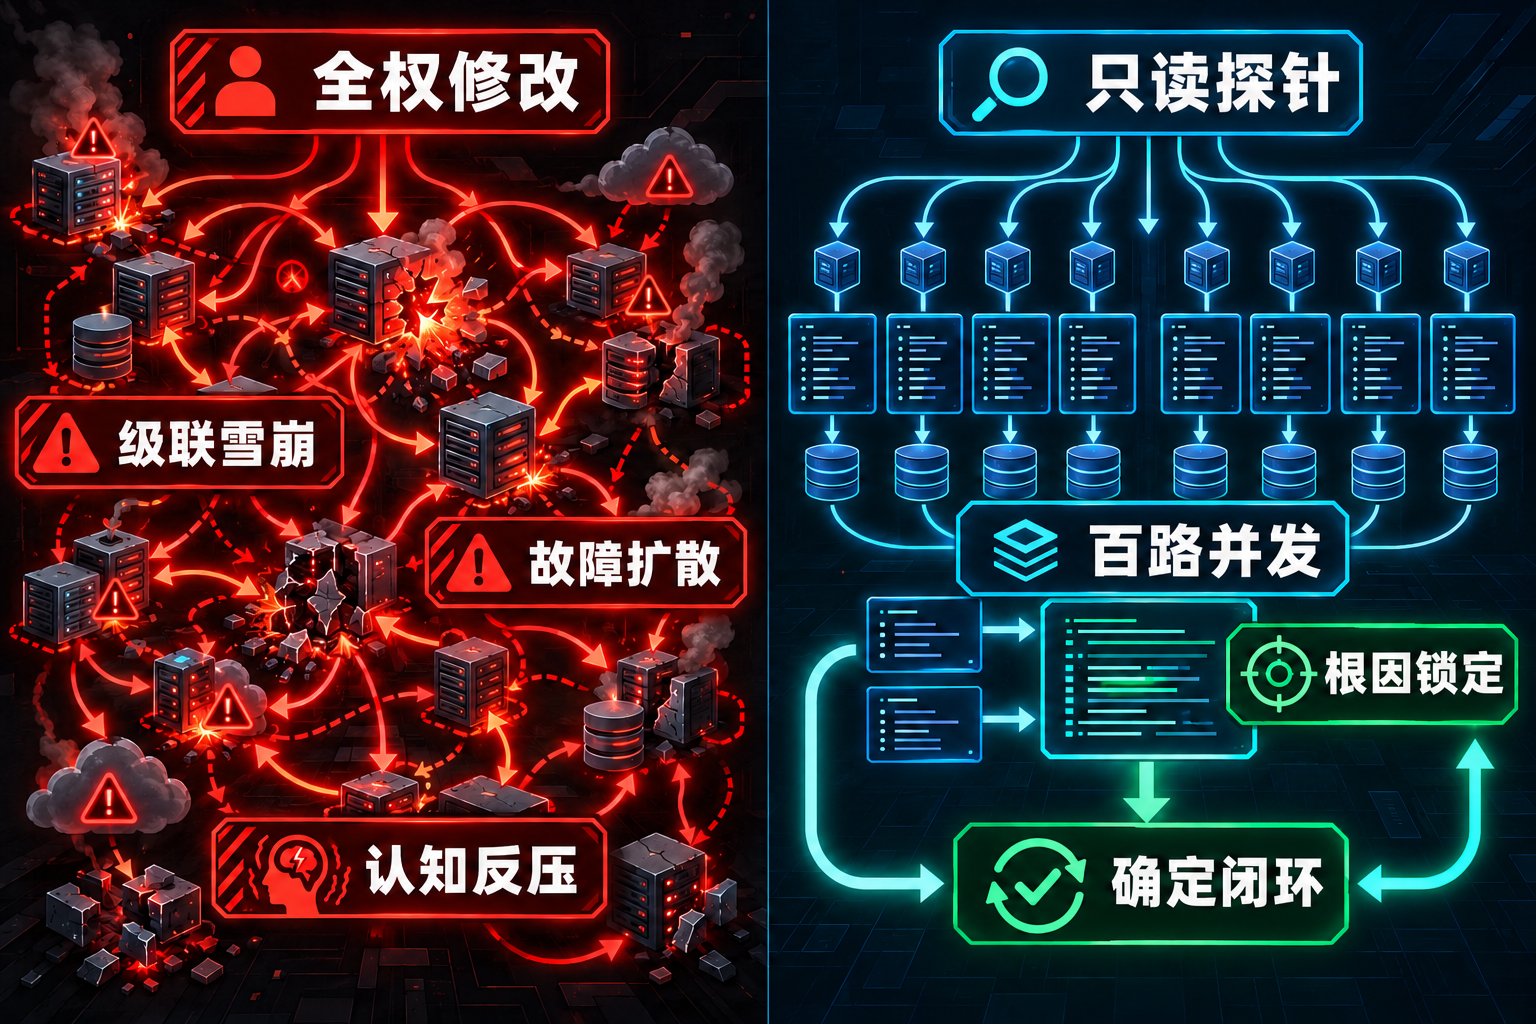
如果赋予智能体直接修改线上状态的权限,模型在遇到连续报错时,本能动作是不断重试、变更配置或强行重启进程。把线上写权限盲目交给概率模型,是在用不可控的随机动作放大系统爆炸半径。
一旦错误的修复操作穿透到了真实数据库与流量网关,后续排查的难度将呈几何级数攀升。
极速响应打破了人类三十秒注意力断层
既然不能让模型直接动手修服务器,前沿团队在实际故障响应中究竟把什么交给了大模型?
在最新公开的技术实践中,数据中心安全架构师公开了内部排障的真实轨迹。以往需要花费一到两小时聚合异构日志的安全调查,如今被压缩到了十分钟左右。
工程师并没有把写权限交给模型,而是把模型当成了极其强大的只读并发探针。
在事故发生的第一时间,负责人将模型接入排障频道。面对海量报错,模型在数万行日志、配置变更记录与过往讨论中同时展开数十路假设检索。
更为关键的指标是响应时延。工程测试表明,如果辅助工具的响应时间超过三十秒,工程师的注意力就会被迫切换,原本连贯的排障思路会被彻底打断。将并发调查压进实时区间,人类工程师才能始终保持高效的判断节奏。
生产排障的核心在于建立只读证据闭环
真实的工业级落地证明,大模型在运维中的胜负手从来不是替代人类做主观决定。
AI 在排障中最核心的价值不是替人做决定,而是作为只读探针替人在海量日志里并发翻线索。
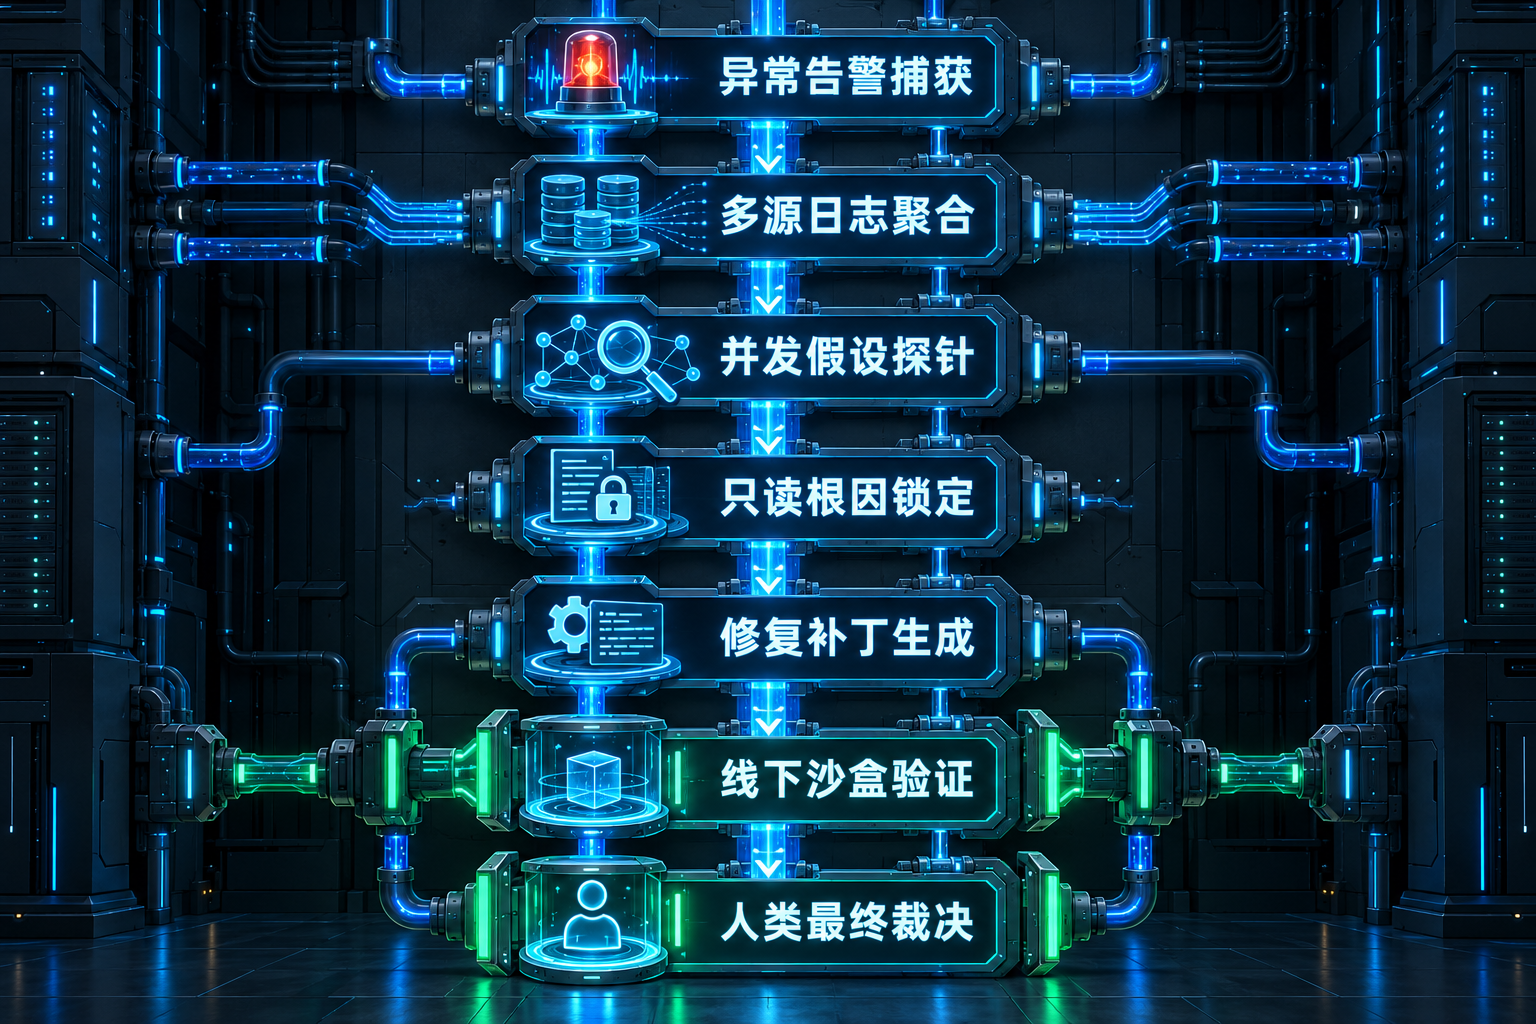
第一道原则是严格收口物理写权限。排障智能体在生产环境中必须处在绝对的只读隔离域,彻底切断模型直接下发破坏性指令的可能。
第二道原则是多源信息异步并发聚合。将指标波动、分布式链路追踪与团队变更记录统一汇入只读总线,让模型专职负责不同维度的关联匹配。
第三道原则是离线验证与客观指标闭环。任何修复补丁都必须在线下仿真沙盒中经过重放验证,线上恢复必须以客观的监控曲线回正为唯一准绳。
生产级智能体运维的本质,在于用只读的超快探针消除信息迷雾,把最终的确定性裁决权留给人类。
不要试图把线上修复的火控权草率交给大模型。守住只读探针的安全底线,让机器负责在海量数据中极速捕获线索,工程师才能在复杂的故障面前掌握真正的主动权。
公开参考
- OpenAI 官方事故调查博客 https://openai.com/index/openai-cut-incident-investigation/
