很多工程师让智能体搭建全栈项目时,都经历过这种崩溃的工位时刻。前端页面两分钟飞速写好,但一到接入后端,灾难便接踵而至。模型在独立的认证服务、分立的向量引擎和外部消息队列之间疲于奔命。原本用来写业务的上下文窗口,瞬间被各种鉴权密钥与网络配置占满。这就好比刚进工地的施工队配了一打各不相通的专用工具箱,工人还没开始砌墙,先在找扳手的路上彻底迷了路。
碎裂的中间件把智能体逼进了胶水地狱
很多团队直觉上认为,给智能体配置越现代、越专用的独立服务,系统架构就越高级。然而在真实工程落地中,分散的架构恰恰是智能体最致命的绊脚石。
每一个独立服务都意味着一道全新的跨网络调用边界。智能体必须自行处理连接池管理、跨服务事务一致性与网络重试。
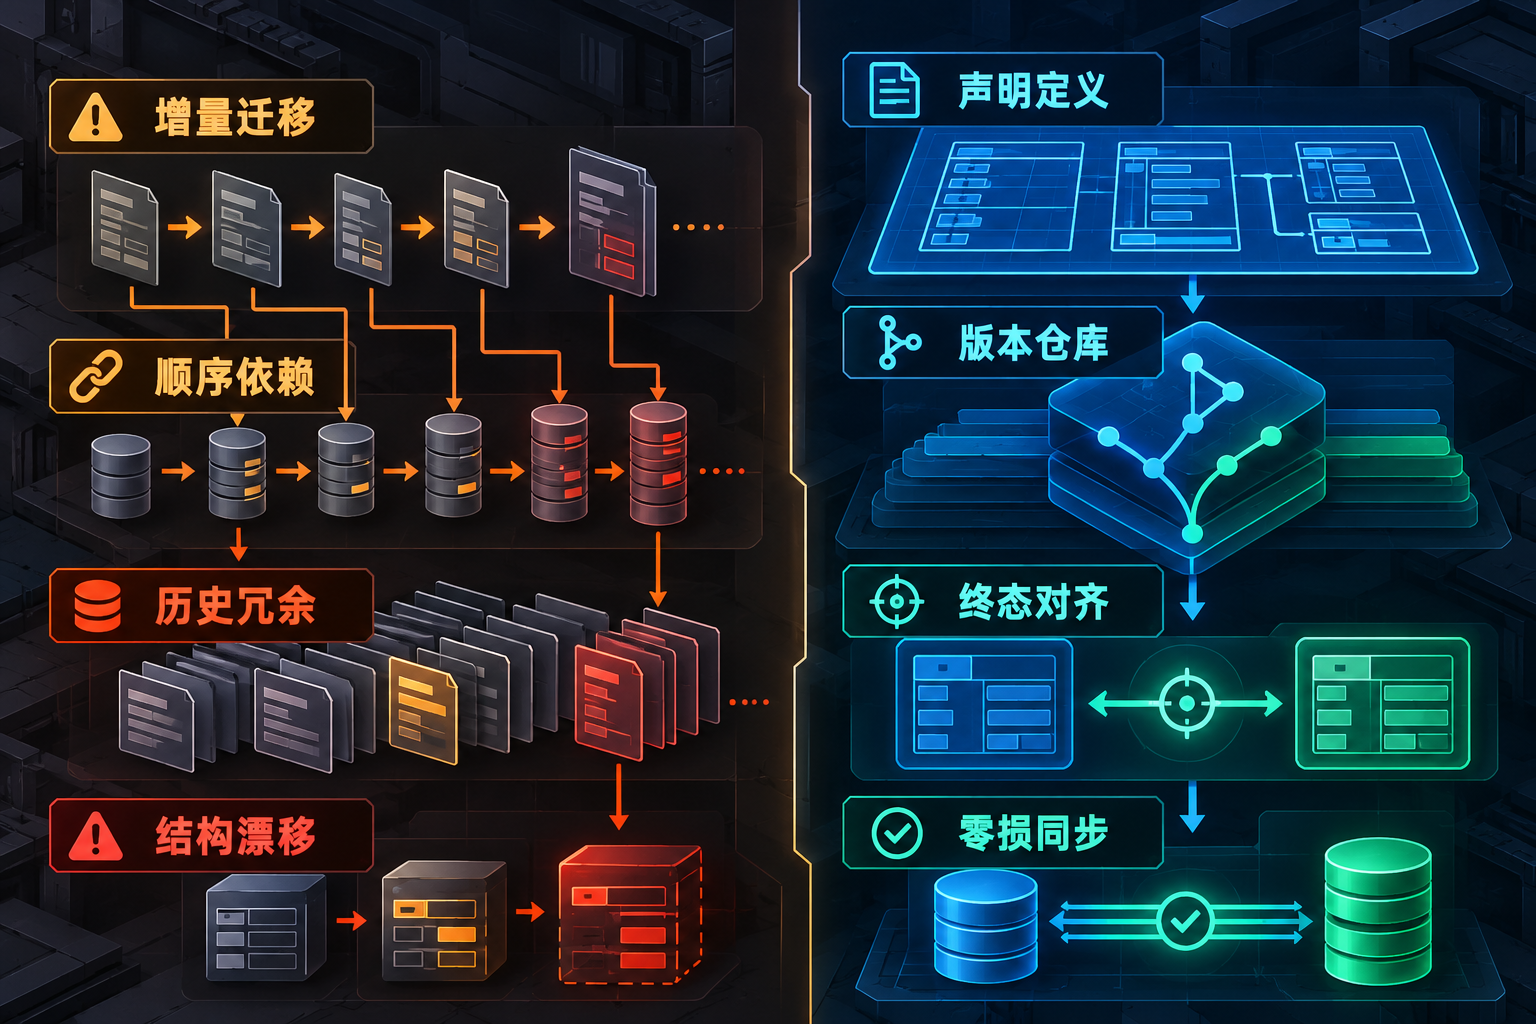
更为严峻的挑战来自于传统数据库的过程式迁移脚本。人类工程师习惯按顺序累积迁移文件,从最初的表结构,一路追加到第几十个补丁文件。
让智能体去通读几十个历史脚本,不仅造成巨额的上下文消耗,还会诱发严重的推理漂移。反复阅读过程式迁移脚本的大模型,极易在冗长的历史依赖中迷失真实终态。
一旦出现版本分叉,模型便会在错误的历史假设上反复试错,导致数据库结构彻底失控。
前沿智能体在全栈生成中做出的集体选择
行业都在狂热追捧眼花缭乱的新型存储,主流前沿模型在真实业务交付中却走了一条完全相反的道路。
在最新公开的行业访谈中,估值达百亿美元的 Supabase 联合创始人公开了一个反常现象。面对长周期全栈交付,前沿智能体在实际选型中几乎全量首选成熟的关系型数据库。
智能体的偏爱并非盲目怀旧,而是现代工程接口演进的必然结果。
关键的第一步是数据库的声明式改造。传统数据库依赖顺序执行的迁移命令,而现代工具允许将期望的表结构直接以单一声明式文件存入代码仓库。
智能体不需要再回溯漫长的建表历史,只要读取当前版本的静态声明,即可一眼看清系统当前的最终状态。这就是数据库领域的基础设施即代码时刻。
把物理算力紧贴着业务数据放置
除了声明式结构带来的推理降维,架构拓扑的物理收拢更是决定性的分水岭。
传统微服务架构强行把计算逻辑、业务数据与文件存储分散在不同的物理节点。每一次数据过滤与状态更新,都必须跨越公网进行序列化传输。
现代关系型底座将通用计算容器直接放置在数据库物理近端。
需要处理复杂的数据转换与后台任务时,算力在存储近旁直接吞吐。智能体不必再编写臃肿的外部通信胶水,调用拓扑被大幅收敛。
环境初始化的轻量化同样是不可忽视的物理防线。摆脱对庞大容器镜像的沉重依赖,本地数据库实例实现瞬间拉起。智能体在本地隔离环境中能够迅速试跑验证,获取确定性的执行反馈。
关系型数据库不是旧时代的遗老,而是被长期低估的确定性底座。
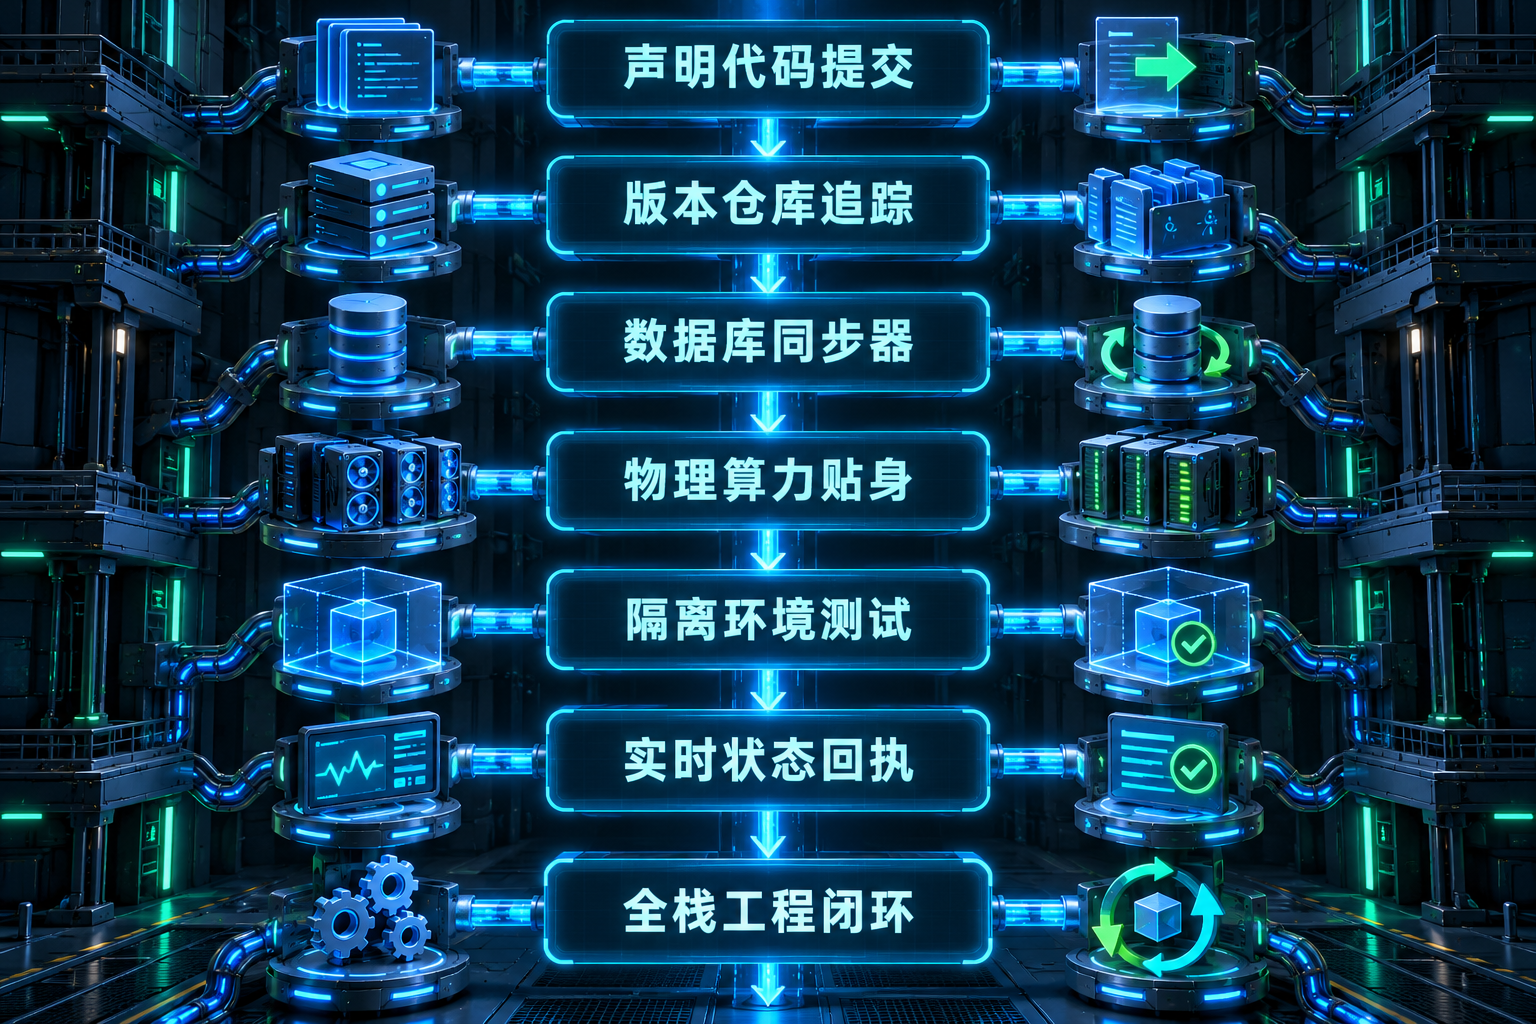
不要再给智能体编织过度碎裂的微服务网状迷宫。让数据结构回归直观透明的声明式表达,让计算逻辑紧贴核心存储,智能体才能在复杂的现实任务中稳定交付真正可靠的生产级系统。
公开参考
- Latent Space 官方专访 https://latent.space/p/supabase/
