很多团队在面对高并发智能体业务时,容易陷入一种架构躁动。一旦系统遭遇响应迟缓,开发者便急于推倒现有存储,盲目引入各类打着新型旗号的数据库引擎。但在支撑十亿用户与五百 PB 数据的真实战场上,OpenAI 给出了务实的工程答案。高并发智能体背后的数据层瓶颈,从来不需要推倒重来搞伪创新;真正的工程底力,是用分层解耦的近端缓存精准失效与代理重构,在成熟老数据库上榨出十二倍读性能跃迁。
默认多租户原语遭遇热点碰撞
主流智能体平台往往依赖高频会话持久化与状态读取。海量用户与自动化工作流并发调用工具,最先承受高压的往往是底层在线存储。
OpenAI 构建的存储平台 Habitat 承载着逾十亿 ChatGPT 用户的请求。底层数据总量超过五百 PB,最大单一数据库账户承受着两千万 QPS 的峰值访问。系统最初直接依赖托管数据库 Azure Cosmos DB 的默认多租户原语,试图通过云服务自带的分区配额应对业务扩张。
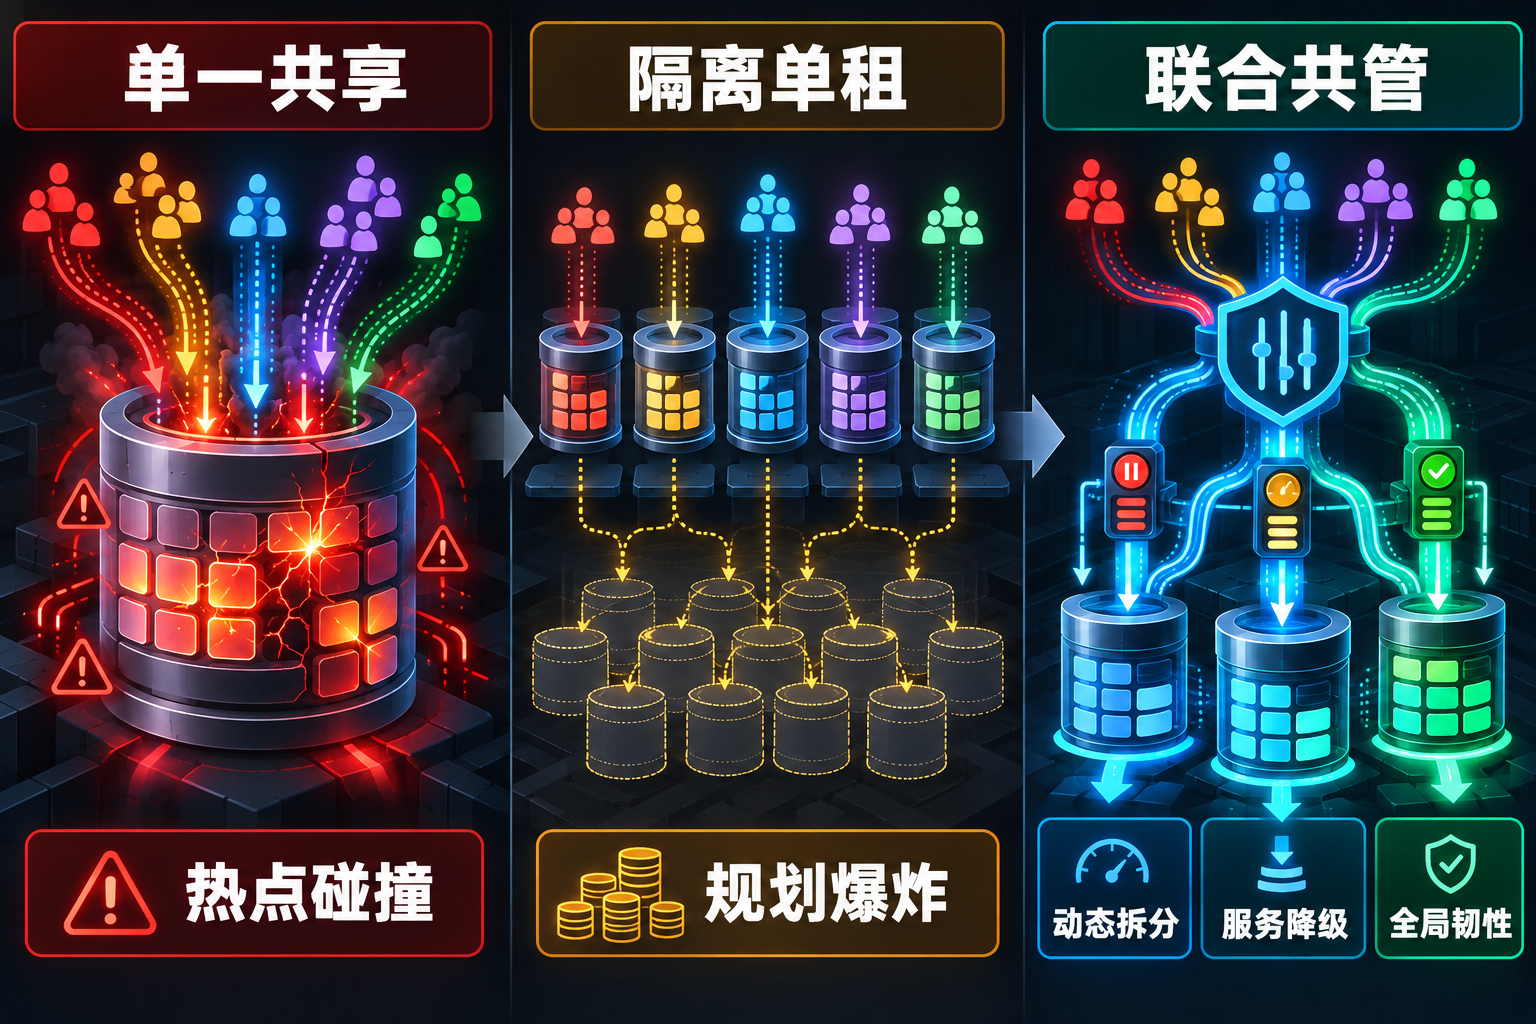
这种过度依赖单一默认容器的做法迅速碰壁。早期设计将逻辑分区键直接暴露给调用方,导致不同业务在 user_id 等常用主键上频繁重叠。由于物理分区由多个逻辑分区共享,单个热点租户发起的大量读取请求,就会瞬间吃光物理分区一万 RU/s 的吞吐上限。
更为棘手的是底层存储的弱分区缺陷。当存储数据量膨胀触发物理分区自动拆分时,容器的总预配吞吐量保持不变。拆分后的物理子分区只能分到五千 RU/s 吞吐配额,导致活跃业务在写入速率平稳时,反而因底层数据拆分遭遇性能腰斩。
盲目推倒重来陷入规划爆炸泥潭
为了摆脱热点碰撞与噪声邻居干扰,工程团队一度转向激进的单租户隔离方案。运维人员为每个核心业务独立创建专属容器,试图在物理层面划清资源界限。
这种物理隔离隔绝了单个业务的故障扩散,却彻底破坏了多租户系统的平滑负载红利。在一个庞大的共享大池中,单个新功能从零并发增长到百万 QPS 通常会被总体容量吸收。但在独立容器中,同样的突发流量相比最初基线暴增上千倍,瞬间击穿单容器预配上限。
每个专用容器都需要独立预估容量并手工配置。工程团队在上线新功能时经常遗漏提前扩容,导致容器在突发流量下出现严重过载。这种粗暴隔离带来的容量规划开销,最终拖垮了研发团队的迭代速度。
OpenAI 最终选择重返多租户路线。团队与云服务商展开联合工程,在共享租户内引入基于请求优先级的服务质量调度。离线批处理与分析任务被赋予较低优先级并在高压下率先受限,保护了核心用户交互读取免遭限流阻断。
分层解耦在老系统榨出十二倍跃升
稳定了多租户防线之后,高并发智能体系统的下一个瓶颈是跨区域网络延迟。在 Habitat 承载的全局流量中,读取请求占比超过百分之九十。
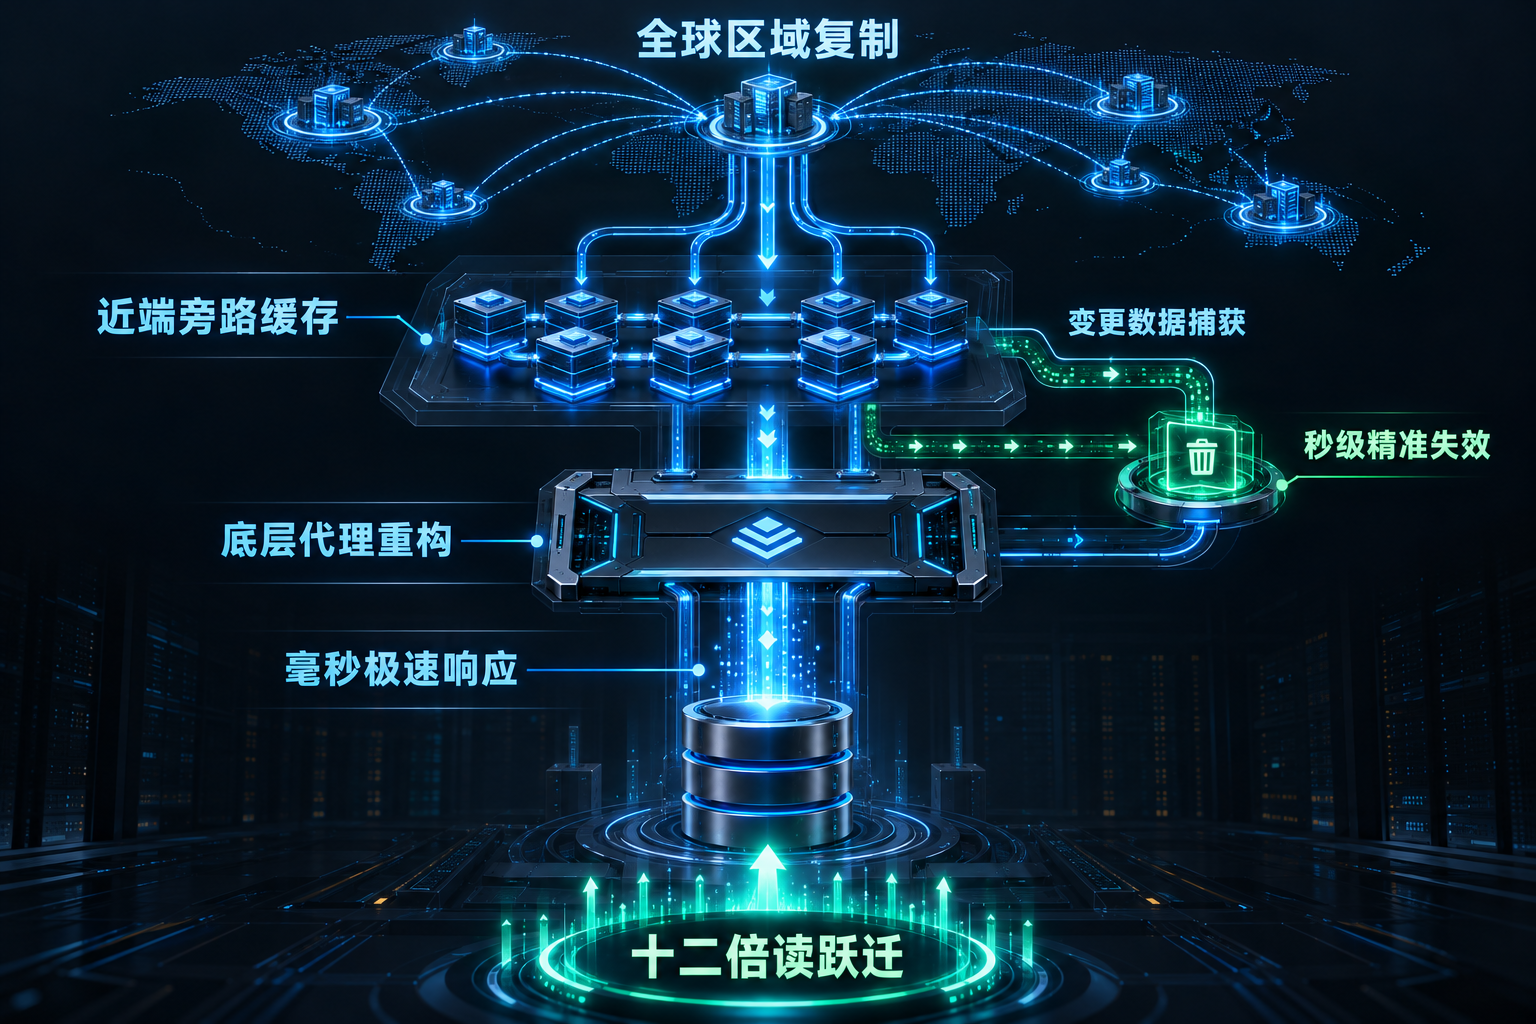
为了彻底终结跨大洲请求带来的数十毫秒延迟,OpenAI 搭建了三层加速防护管线。第一层是极度克制的地理复制。团队仅将体积极小且对延迟极度敏感的鉴权元数据在四十个区域广泛同步,严禁将全量数据无节制异地备份。
第二层是近端分布式旁路缓存。系统在靠近处理节点的边缘部署 Valkey 缓存集群,承担高频状态读取。针对传统 TTL 过期时间难以兼顾新鲜度与命中率的缺陷,平台借鉴工业级失效机制,通过数据库更改源进行全量变更捕获。变更事件流在数秒内精准推送到全球节点淘汰脏数据,兼顾了极高命中率与数据新鲜度。
第三层是代理服务消除自损。团队使用性能优越的 Rust 语言彻底重写了原本由脚本语言编写的代理中间件,大幅降低了代理转发的自身消耗。
这套组合拳让全球读取延迟的中位数从一百二十毫秒暴跌至十毫秒,在成熟老系统上跑出了十二倍的性能跃迁。优秀的软件架构从不沉迷于颠覆一切的幻象,而是以分层解耦的克制设计,将成熟基础设施的物理极限推向极致。
