在设计大模型流水线时,很多工程师习惯把顶会论文中的学术结论当成永恒法则。
大模型不会真正的多步逻辑推理,大模型做文献综述有半数是编造的,大模型处理长文本时存在严重的位置偏见。为了防御这些曾经被权威论文白纸黑字验证过的缺陷,技术团队往往在业务架构深处堆砌了极其繁杂的校验与拦截代码,动辄注入数千个额外 Token 的防范提示词。
大模型的技术缺陷往往只是特定训练阶段的临时工伤,而不是不可逾越的物理定律;在系统里为一年前的过时论文过度设防,本质上是在为空气交税。
静态学术权威把业务架构带入过度防御
把特定历史时期的模型短板当成客观真理,是工程实践中最昂贵的认知惯性。
很多架构师依然在根据两年前关于某代模型的测试数据,给整个业务管线增加层层前置过滤。团队为此付出了翻倍的代码维护成本,每一次端到端交互还被强行增加了数百毫秒的额外判定延迟。
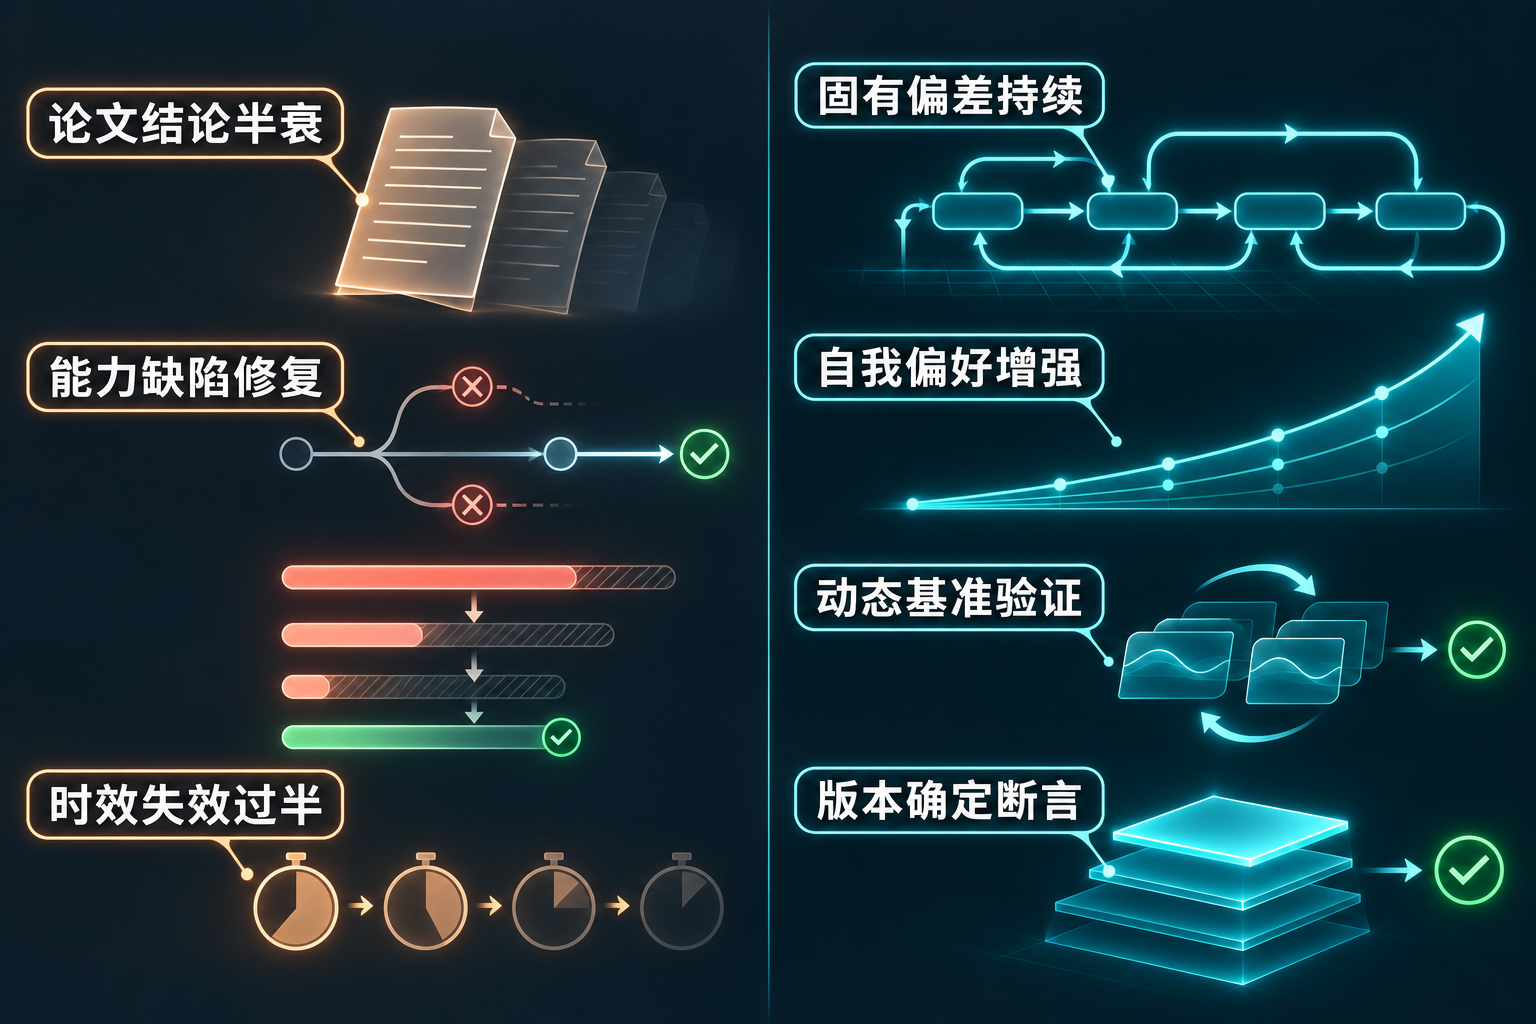
更为隐蔽的损耗在于认知锁死。模型底层权重在持续进化,但外围的工程代码却还在原地打转。
当开发者花费数周时间搭建起一套精密的防范框架时,最新发布的模型版本可能早已在预训练阶段彻底消除了该项缺陷。曾经被视为核心资产的防御工程,一夜之间退化成了阻碍吞吐的无用包袱。
缺乏针对模型演进的时效性度量,让整个团队在对抗早已不存在的假想敌中白白耗散算力与 API 预算。
经典实证在现代前沿模型前显露半衰期
学术研究团队最近用一组严谨的实测数据戳穿了这种学术迷信。
研究人员选取了学术界与工业界过去几年被高频引用的五十项大模型行为经典结论,涵盖逻辑推理、幻觉倾向、谄媚偏好、越狱漏洞与评估基准等核心领域。团队随后调集了横跨八家顶级机构的二十个现代模型,展开了严格的重现性对比检验。
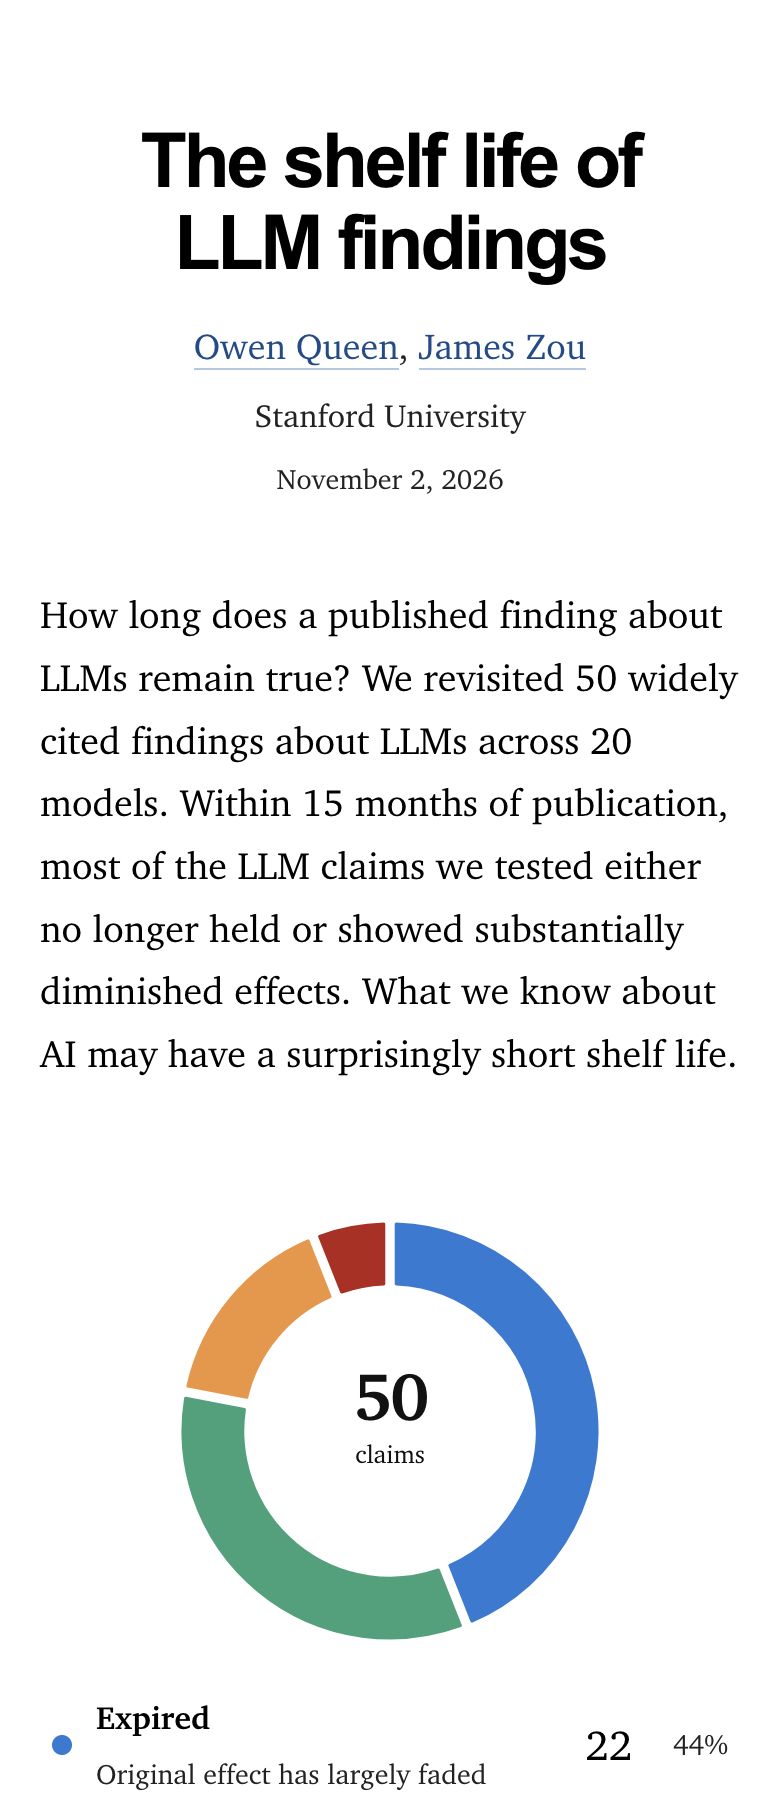
重测跑出的统计分布展现出学术结论极其残酷的短半衰期。整整百分之四十四的经典结论在现代模型中彻底失效,其相对效应值跌落至原论文的五分之一以下;另外百分之三十四的结论也出现了显著的效应削弱。
这意味着绝大多数关于大模型缺陷的论文结论,真实有效寿命仅仅只有短短十五个月。
以两年前轰动一时的参考文献造假测试为例,早期模型撰写综述时虚构了过半的论文引用;而在前沿模型上重新执行相同任务时,编造引用的现象几乎已经彻底绝迹。真正得以持续甚至增强的极少数结论,基本局限在大模型作为裁判时的自我偏好等固有机制中。
动态能力探针取代静态教条代码
这项重测实验为现代智能体系统的架构演化确立了清晰的治理准则。
工业级的生产流水线应当建立自动化的模型能力时效探针。一旦监测到底层模型通过版本迭代自发补齐了特定逻辑短板,系统必须即刻触发提前终止,果断熔断并跳过下游那些过时的冗余校验链路。
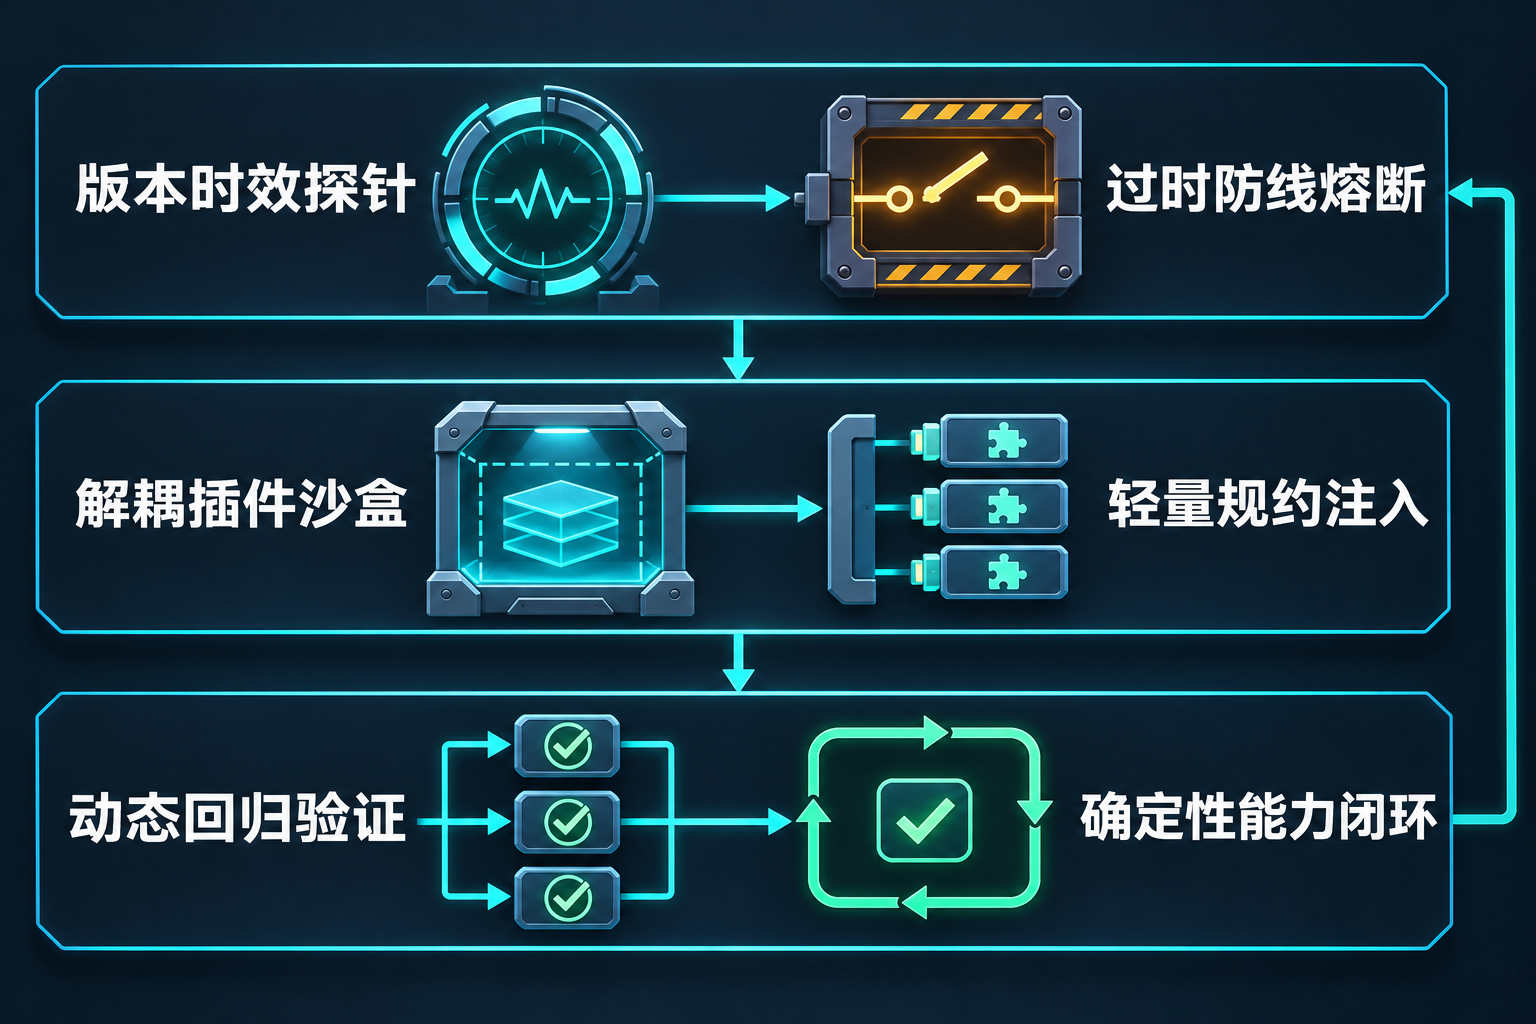
架构设计绝不能在核心逻辑深处与特定模型版本的缺陷深度绑定。应当坚持轻量解耦的插件化组合原则,将所有防御性规则剥离为独立外挂组件,确保能够随着底层模型的升级而实现无感知的随时摘除。
面向生产环境的验收流程更需要建立确定性的动态断言套件。依托贴合自身业务的真实回归用例,团队能够对系统的实际效能进行客观量化,而不是盲信陈旧学术报告中的二手定论。
唯有摆脱对过时论文的盲从,大模型工程才能在算力与复杂度的平衡中走向真正可控的演进路径。
