如果不是上周在工位上亲手把本地版本库搞崩溃了一次,我可能也会轻信那些“一个人挂上十个智能体,软件研发效率就能暴增十倍”的传闻。
那天下午,我在本地同时运行了五个代码智能体,分别给它们指派了不同的模块重构任务,准备体验所谓代码印钞机的高效。
开始的十分钟确实节奏飞快。终端控制台里代码流式下刷,分支提交记录不断向上增长。
但到了第二十分钟,工程现场开始失控。
最先发生故障的是本地命令行。当我试图把其中一个分支合进主干时,终端进程突然陷入漫长等待。紧接着,连续几个智能体同时触发代码推送,终端接连甩出平时极难碰到的底层报错,提示分支锁冲突、网络握手超时与远程连接被强行切断。
原本以为这只是本地网络抖动,或者是个人设备无法承受并发。
直到本周 OpenAI 官方公开自家的工程窘境,一线开发者才看清了真相。原来全世界最顶尖的技术团队,也在同样的工程断点上遭遇了严重瘫痪。
命令行连续阻塞引发本地仓库瘫痪
OpenAI 官方在一篇长篇工程复盘中承认,在内部单体大仓里,工程师名下并发挂载的海量智能体同时写代码,直接将老旧的 Git 底层彻底打爆。代码推送延迟暴增近五倍,合并失败率持续走高,整个代码仓库的可用性一度跌破 90%。
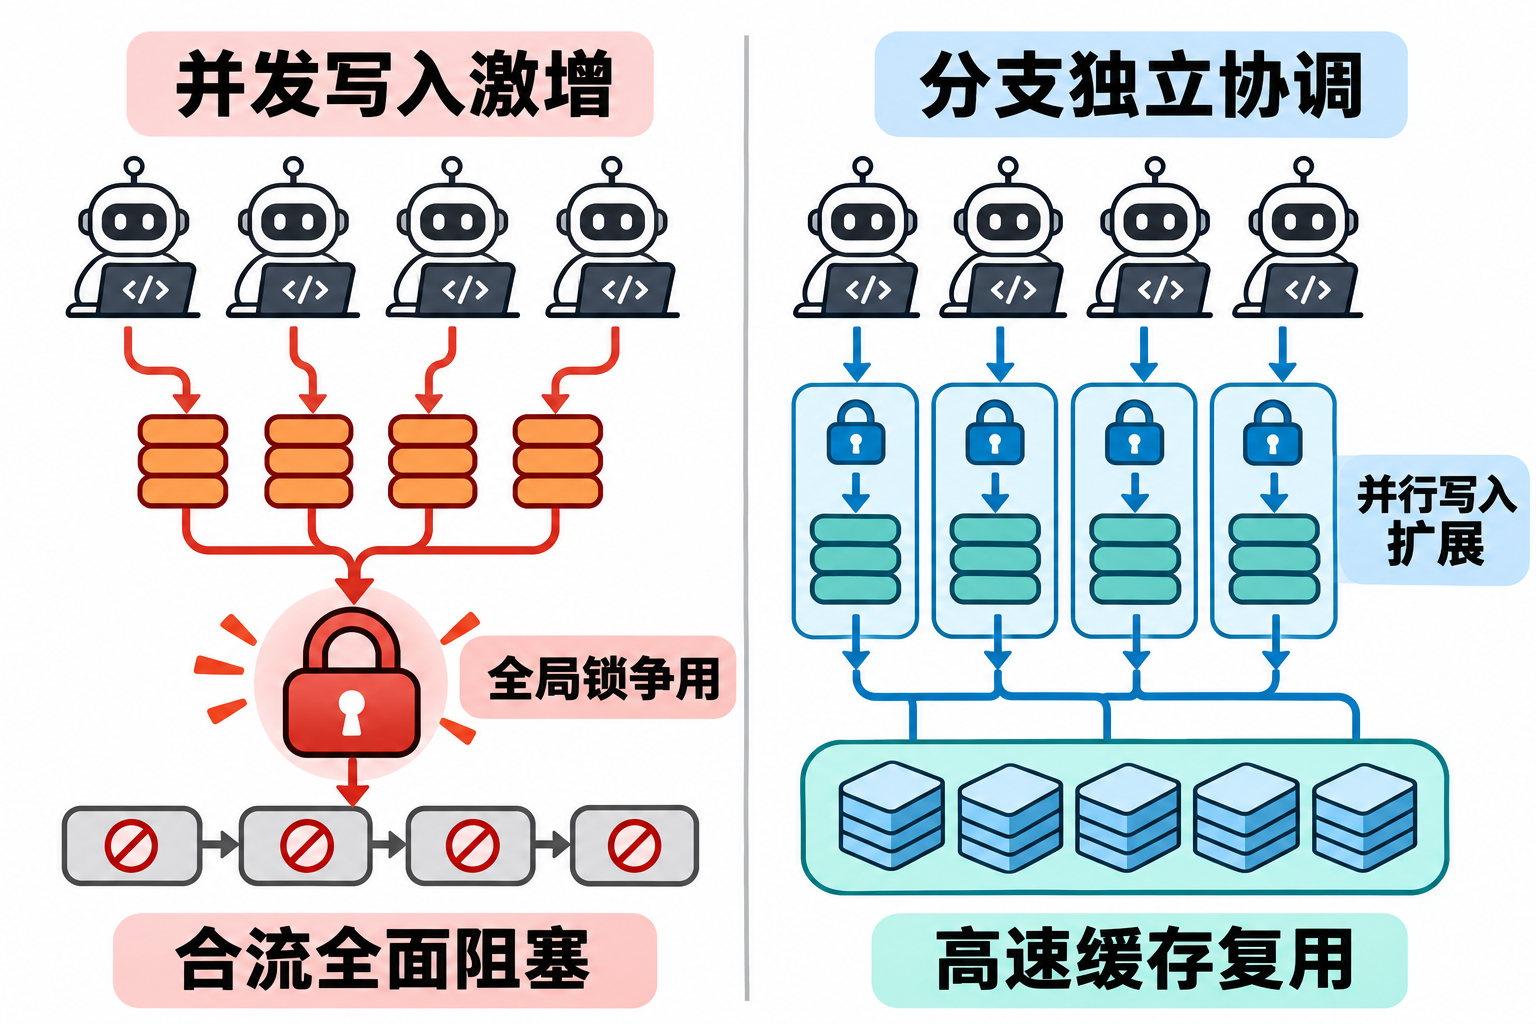
不少人总以为给开发团队配齐大模型就能带来产能跃升。软件工程最真实的物理限制,从来不是代码生成速度,而是传统基础设施根本无法承载机器的倾倒速度。
现有版本控制体系诞生于二十年前通过邮件列表传递补丁的慢节奏时代。底层机制默认使用者是人类开发者,每天思考数小时,谨慎敲下两三次提交。
当代码仓库同时涌入数十个不需要休息、每秒都在尝试写入数据的机器智能体,人类低频操作掩盖的性能短板会瞬间演变成系统级堵塞。
OpenAI 最终耗费数月重写了兼容 Git 的底层存储后端 Pando,甚至主动牺牲部分跨分支的即时一致性,才接住每天近 1 PB 的数据海啸。
但底层存储还只是第一道关卡。
海量差异倾倒直接击穿审查防线
真正让研发流程彻底停摆的环节,是下游的人工代码审查。
当五个智能体在半小时内接连提报十二个拉取请求,每个改动动辄修改数百行代码时,面对代码平台卡顿的差异比对界面,人类大脑负荷会迅速陷入熔断。
网页高亮不断掉帧,滑动页面频繁卡死。面对模型一秒生成的密集语法差异,工程师的理性审查防线往往迅速瓦解。没有精力逐行审查上下文,审查者最终只能麻木地移动鼠标,闭着眼睛点击通过。
这一幕在顶级团队同样发生过。OpenAI 在公开底层存储的同时,闪电宣布收购代码审查团队 Pierre。他们非常清楚,如果审查界面无法实现毫秒级流式渲染与行内原地快修,人工审查最终只能退化成毫无意义的人肉橡皮图章。
折腾完这次并发实验之后,我彻底放弃了盲目多开智能体的做法。
代码生成正在变得极其廉价,如同拧开水龙头便喷涌而出的自来水。但下游的管网、滤网与沉淀池,依然停留在大工业时代的设计标准。
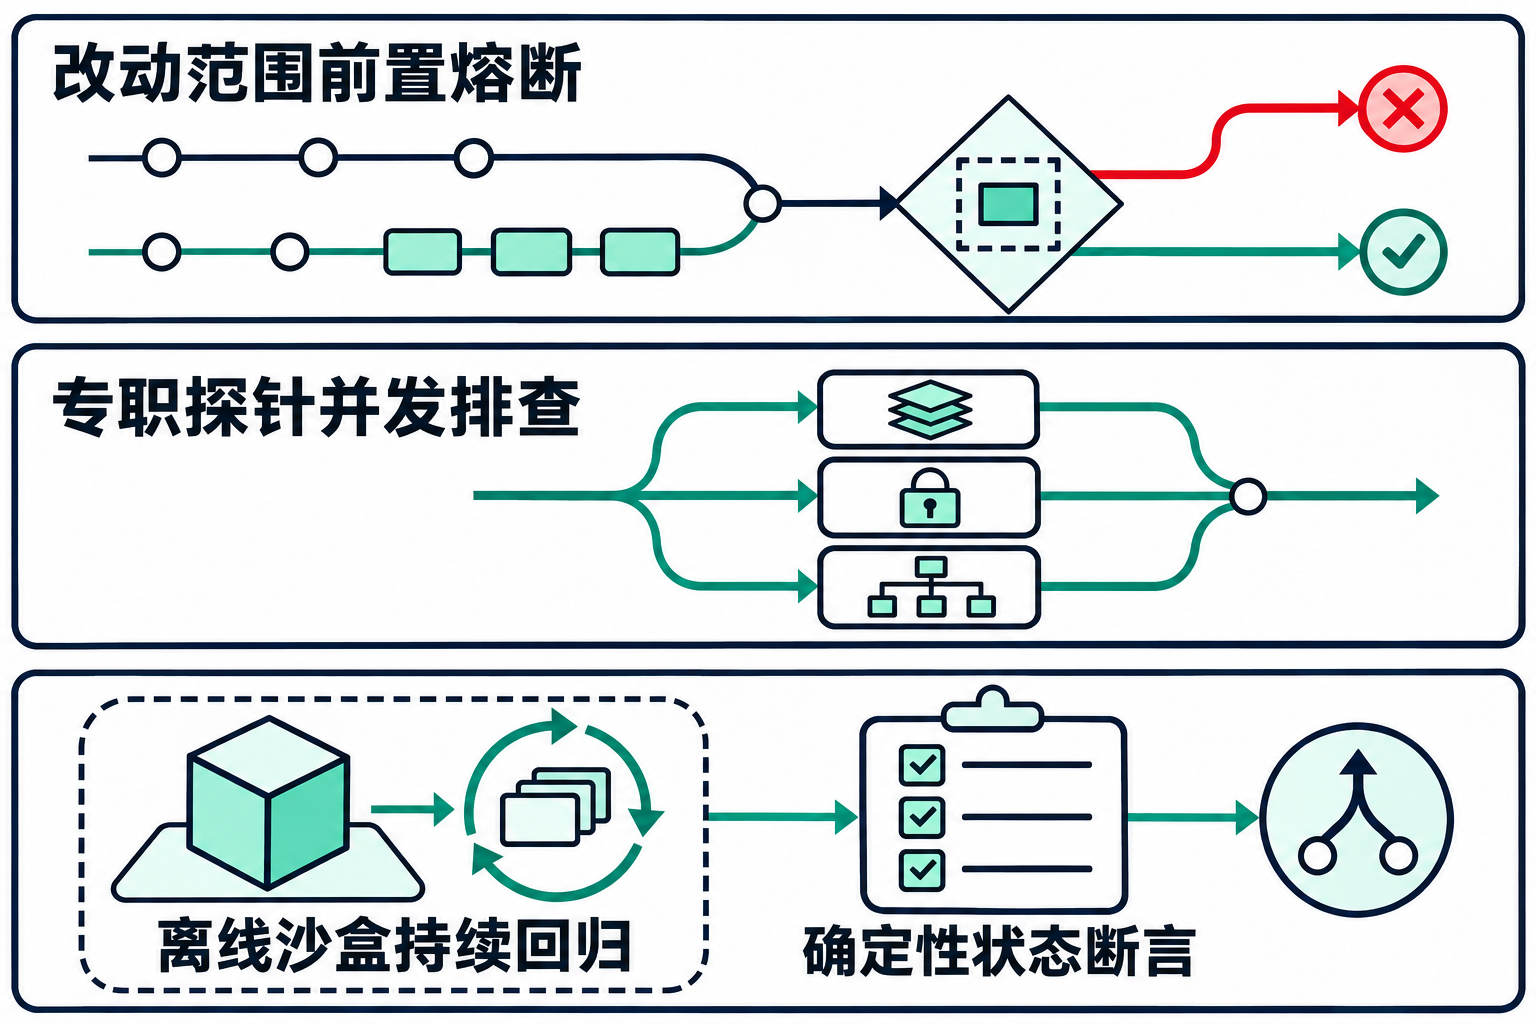
不要盲目追求模型每天产出了多少行代码。在交付流水线建立严格的变更范围熔断、专职探针审查与确定性离线沙盒断言之前,全速开动智能体,只会用过量的数字垃圾把整个团队当场卡死。
