在计算机科学过去六十年的工程铁律里,软件开发必须严格依赖语法抽象。
无论是古老的汇编指令,还是现代的高级语言,程序员的职责始终是将业务逻辑编写为精确的代码文本,再交由编译器与解释器翻译为二进制指令。而在深度学习领域,即便模型规模增长到万亿参数,算法工程师依然需要编写 Python 代码搭建网络结构,并通过海量数据反向传播梯度来更新模型。
大模型正在彻底击穿传统的代码抽象层级,直接在没有语法规则的高维浮点流形上理解并重构神经网络。
纯浮点数输入打破代码层级常识
麻省理工学院研究团队在 2026-11-02 公开的一场实验,把四组无注释的纯浮点权重塞进了大语言模型。
研究人员进行了一场极具反差的受控测试。他们没有让模型编写任何 Python 脚本,也没有挂载计算器或执行工具,直接将包含数万浮点数的强化学习策略网络权重作为纯文本提示词输入。
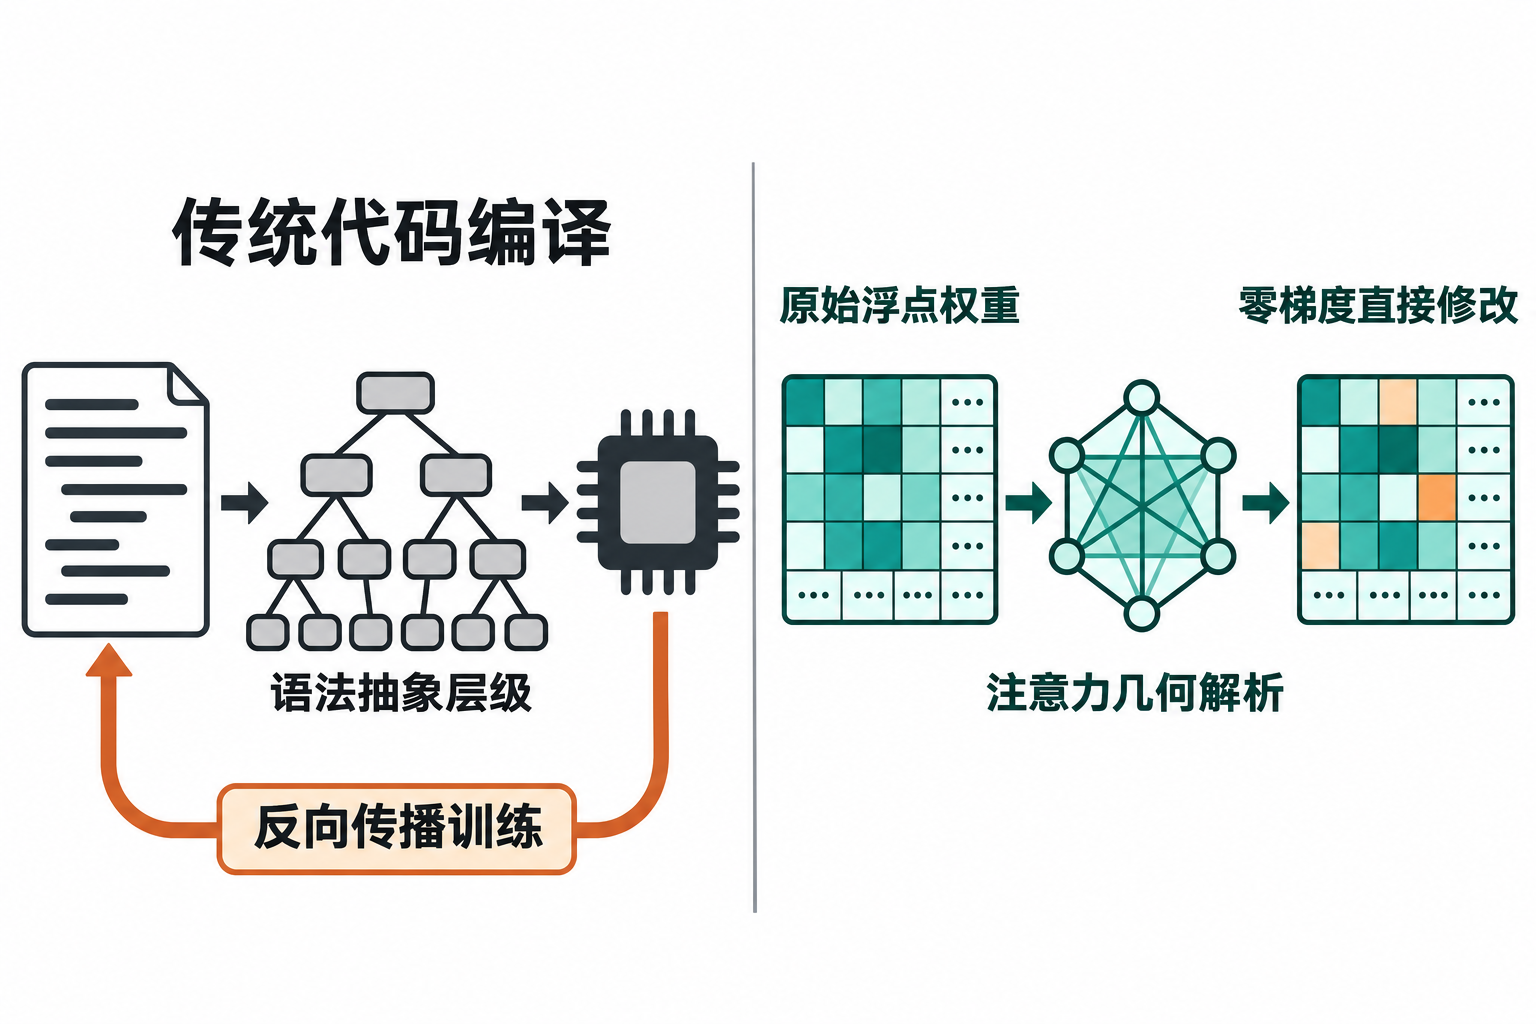
模型面对的不是算法伪代码,而是一片没有变量名或控制流的稠密数字矩阵。
测试要求模型直接推断该组浮点数究竟对应哪种游戏环境。结果 GPT-6 Astra 在没有外部环境反馈的情况下,不仅辨别出 Breakout 与 Freeway,还能零样本写出直接战胜 PPO 训练一亿步策略的小型游戏网络。
笔记本小模型精准还原游戏策略
开源开发者随后在普通的笔记本电脑上完成了本地独立复现。
开发者在个人设备上使用 LM Studio 运行 17GB 的开源模型 Qwen 3.8 27B,使用开源测试工具输入纯浮点权重文本。本地模型在离线状态下运行四十六分钟,消耗 43506 个 reasoning tokens,准确判断出这批权重是在 8 乘 8 网格中收集奖励并躲避移动障碍的吃豆人策略。
在随后的乒乓球对抗网络测试中,本地小模型耗时 1 小时 4 分钟,同样精准定位出击球挡板移动与截击目标的数值分布。
这意味着大模型并非在做简单的随机猜测,而是真实建立起了直接解读高维权重几何形态的内化理解能力。传统逆向工程需要反编译器与符号执行,如今大模型越过语法外壳,把神经网络本身当成了可阅读的底层数据。
极少量修改直接拉升数学推理极限
理解模型参数只是这场范式转移的起点,更具颠覆性的突破发生于原生权重的直接修改。
在轻量化模型排障测试中,开源小模型 Qwen3.5-0.8B 常因参数分布异常陷入推理死循环,传统方案往往需要数万条数据与多卡训练集群重新拟合。
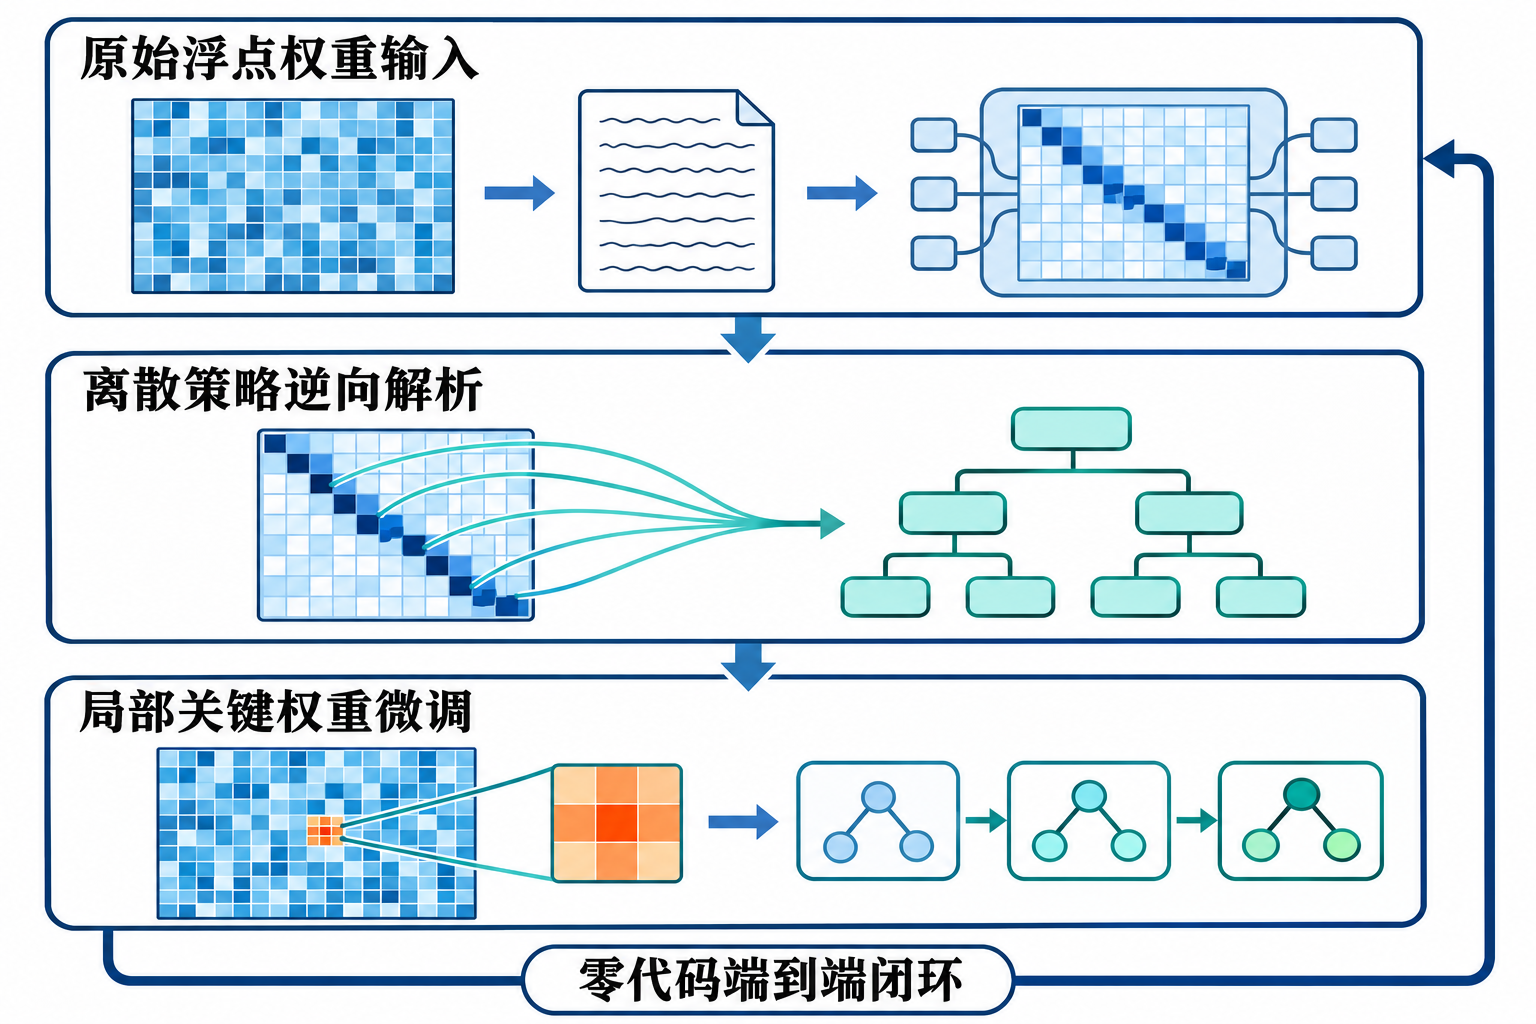
实验中的前沿模型仅仅通读目标网络的原始权重,便精确定位出引发死循环的特定参数节点。
在没有执行任何训练代码的情况下,模型直接在权重矩阵中修改了万分之一点六的浮点数值。这次极其微小却精准的参数矫正,直接将目标小模型的 MATH-500 评测基准成绩从 7.9% 提升至 48.1%,指令遵循能力同步提高三倍。
当大模型学会直接读写底层权重,软件工程的重心正从编写离散的语法指令,退守为在连续的高维空间中校准物理参数。
这种能力并不意味着常规工程代码会在一夜之间彻底消亡。对于追求绝对确定性与事务一致性的关键系统,结构化的高级语言依然是构筑防线不可逾越的护城河。但它清晰地揭示了未来编程的演进分水岭:当符号代码的中间翻译成本被跨越,软件的物理形态终将被高维直连重新定义。
