许多开发者在本地部署或接入 DeepSeek 开发代码智能体,满心期待能低成本复刻顶尖工业助手的交付表现。但在真实业务开发中,开发者频繁遭遇极其痛苦的场面。面对一个偶发的编译报错或接口变更,智能体在一两个文件里来回修改反转,连续执行十几次依然毫无进展,反而在短短几分钟内把数十万上下文配额彻底耗尽。
这种费钱又死循环的工程困境,正在成为开源模型落地应用中最普遍的暗坑。开发者往往习惯归咎于模型能力不够强,或者试图通过更换更大的模型版本来碰运气。但最新的一组控制变量实测与学术界深度研究揭示了一个冷酷的物理事实:同一个模型交给不同的工程架构,交付成功率能直接拉开数倍差距。决定智能体能否跑完全程的物理分水岭,从来不在模型权重本身,而在于包裹在模型外面的底盘工程。
同样的代码任务裸跑四轮耗尽上下文
为了验证底盘工程对模型产出的决定性影响,测试团队在相同环境内设计了一组严格的控制变量对撞实验。实验选定完全相同的 DeepSeek 开源模型权重,处理同一个中型工程的模块重构任务,唯一改变的变量是模型外围的执行底盘。
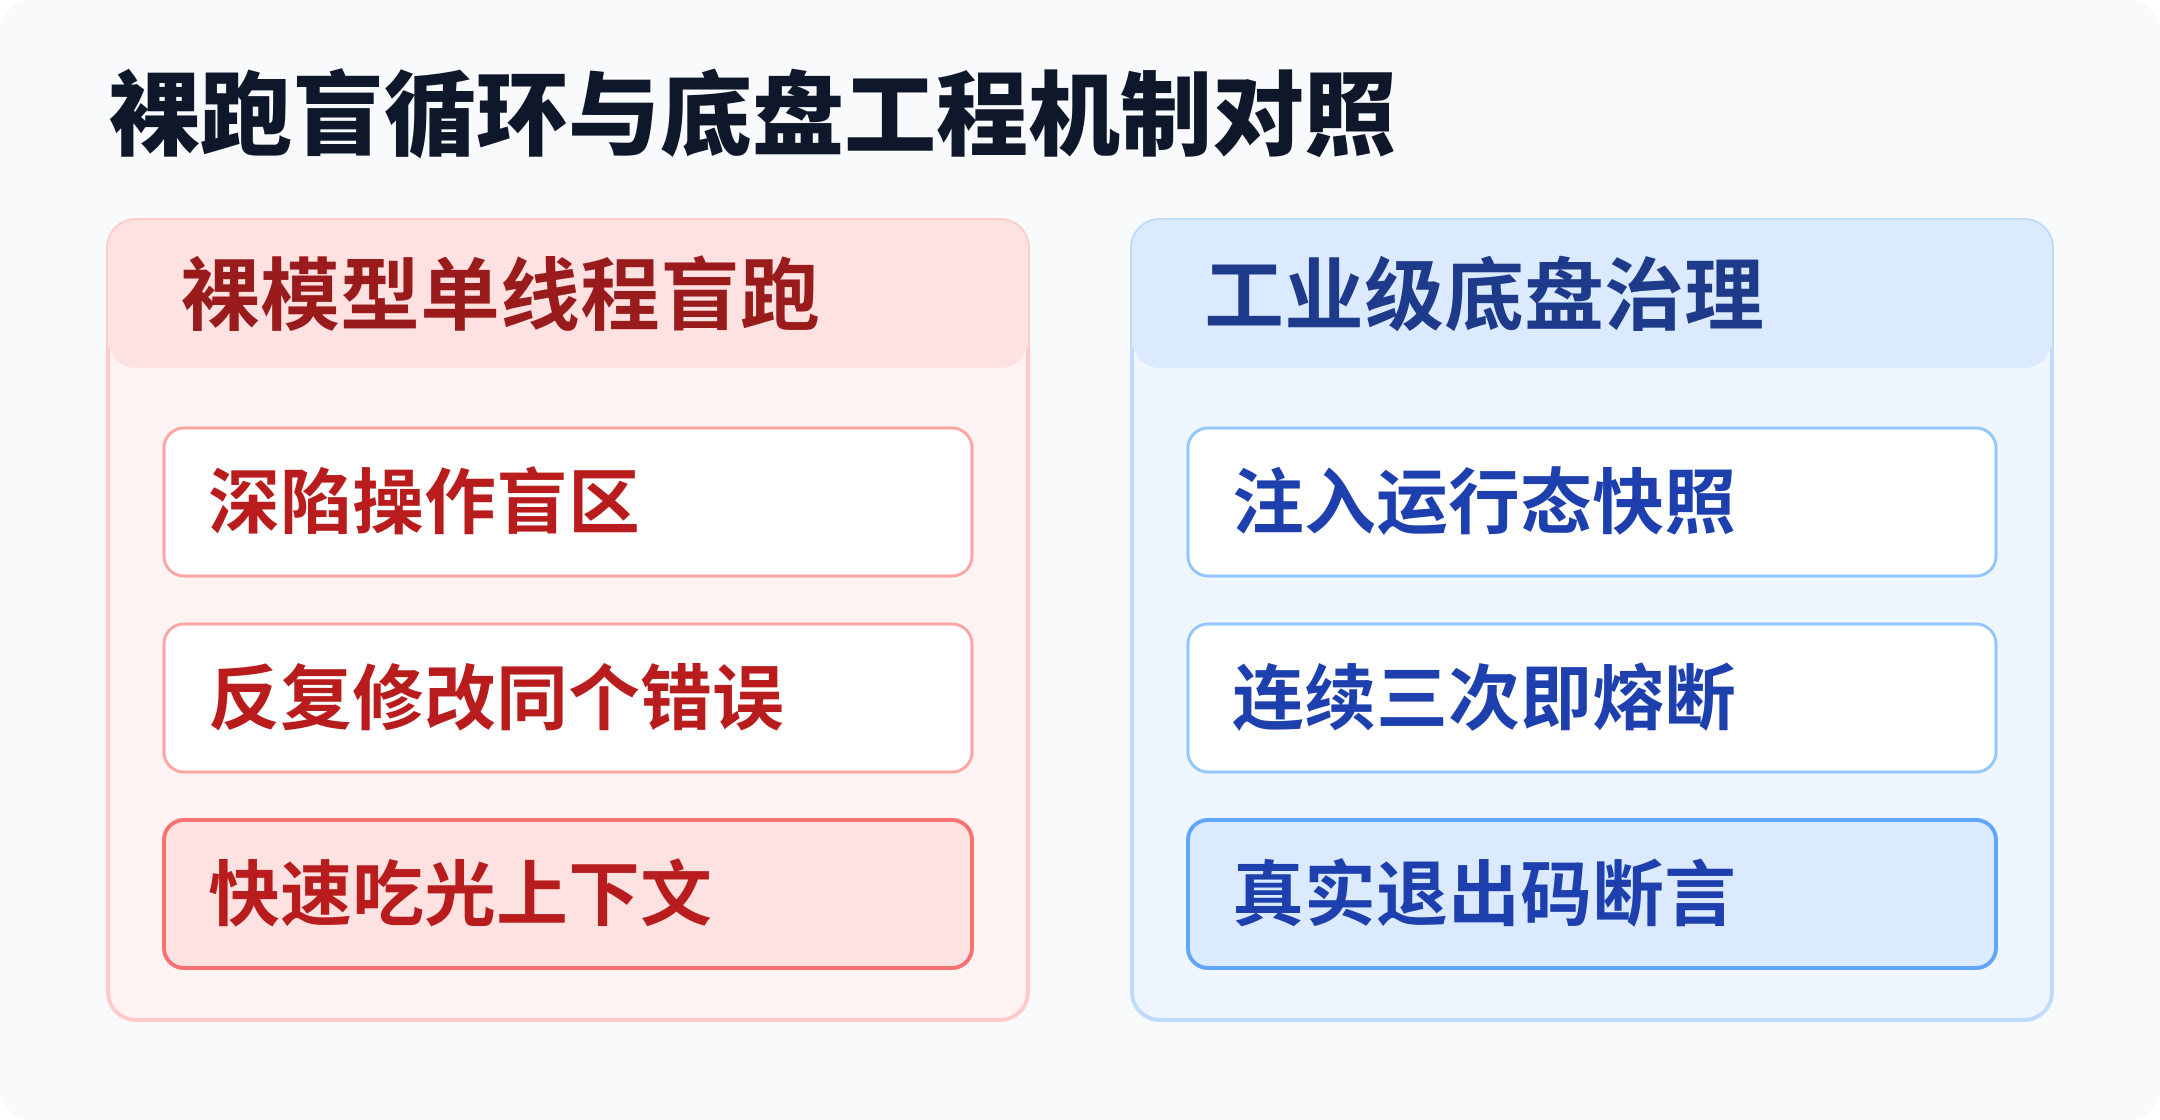
在缺乏状态管控的裸单线程循环中,智能体的表现迅速演变成一场灾难。面对依赖冲突,模型在第一轮做出了合理的代码修改;但在第二轮测试失败后,由于缺乏全局运行态的快照感知,模型开始自我怀疑,并在第三轮推翻了之前的正确改动;进入第四轮,模型开始来回修改同一行变量名,陷入典型的自证死循环。整场任务不仅没有完成,还无谓消耗了超过十四万词元,最终由于上下文窗口耗尽而强制崩溃,全套任务完成率停留在 32%。
而在加装了工业级底盘工程的对照组中,同样的模型展现出了截然不同的成熟度。系统在任务分发前自动注入环境快照,并在第三轮尝试产生重复错误指纹时主动切断无效路径,最终仅耗费四万九千词元,在三轮内收敛并交付了全部代码,重构完成率跃升至 84%。
连续三次相同报错直接触发快速熔断
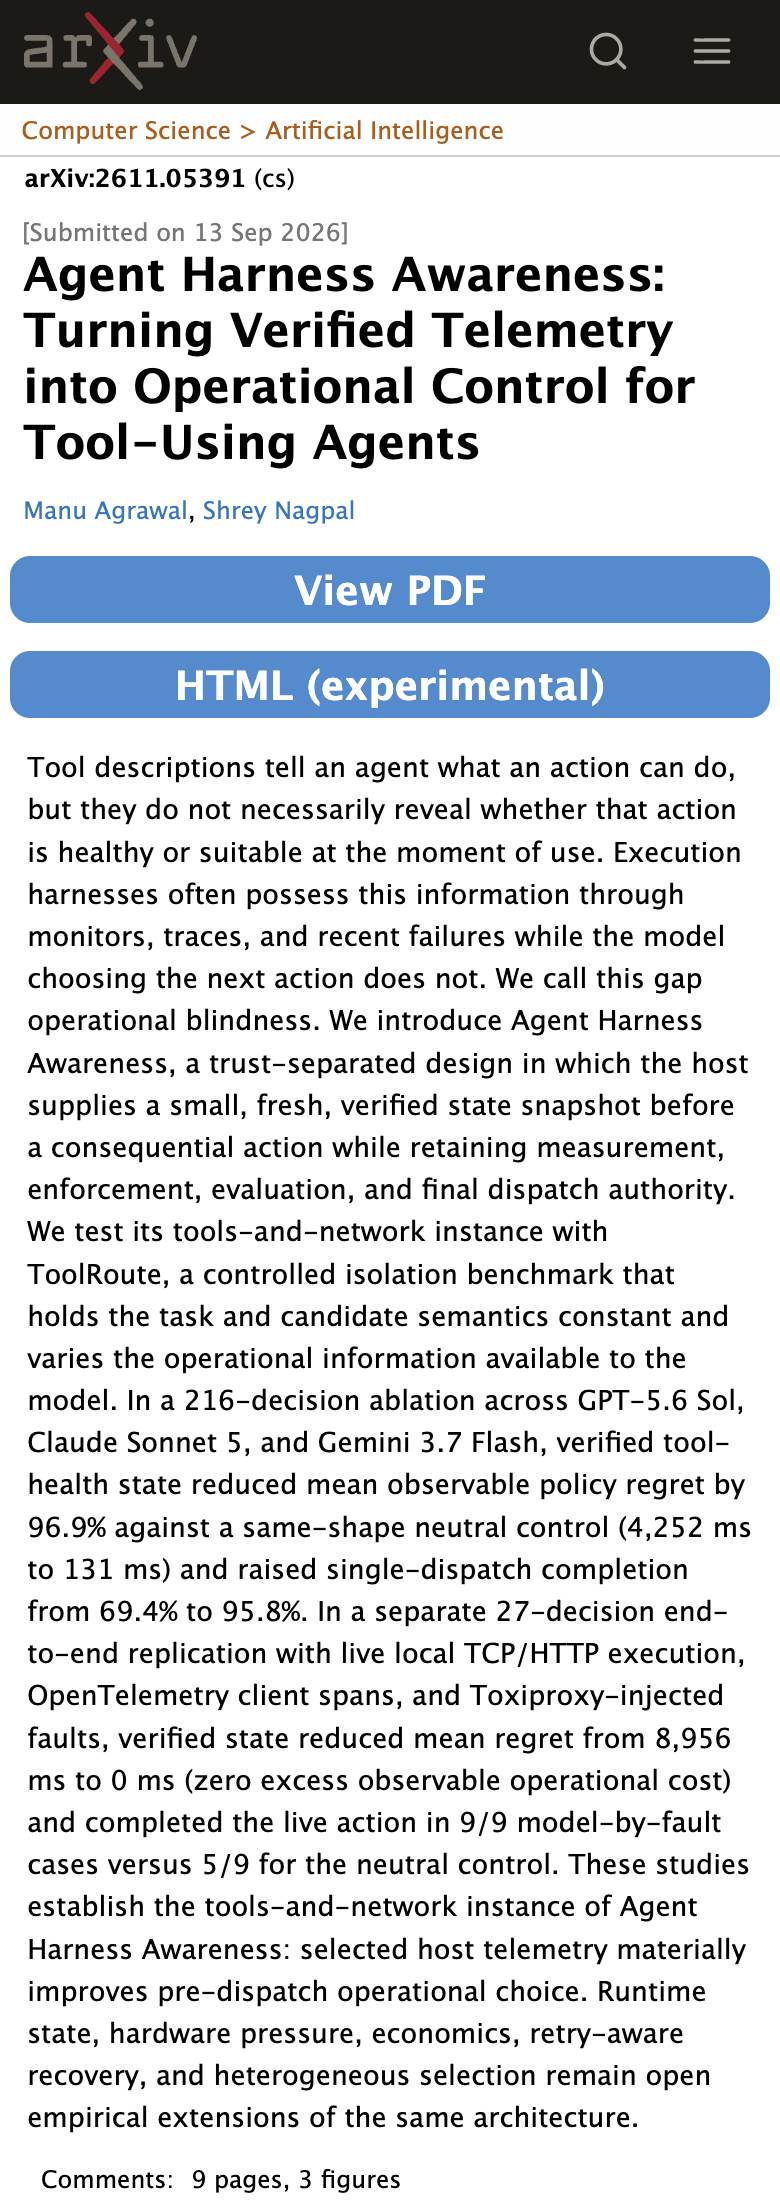
最新公开的前沿学术长文《Agent Harness Awareness》为这组对撞实验给出了严密的理论解释。论文指出,传统智能体设计普遍存在严重的“操作盲区”。工具描述只告诉了智能体某项操作具备什么功能,却从未向模型同步当前系统的健康度与历史失败轨迹。
单步推理的大模型就像一个被蒙上双眼的数学天才,它拥有顶尖的符号逻辑能力,却对自己正坐在漏油的跑车里浑然不知。当智能体陷入死循环时,外围的监控与调用日志早已记录下多次重复的退出错误,但处于操作盲区中的模型依然在自信地自我脑补,以为多试一次就能创造奇迹。
要破除这种高昂的算力浪费,底盘必须建立起前置的短路熔断机制。工程框架绝不能放任模型在同一条错误轨迹上无休止试错。只要底盘检测到连续三次工具调用的错误哈希完全一致,或者改动范围超出了初始工单的声明边界,必须在第一时间强行熔断执行流,切断无效推理的资源消耗。
离线沙盒硬核断言杜绝自我脑补修复
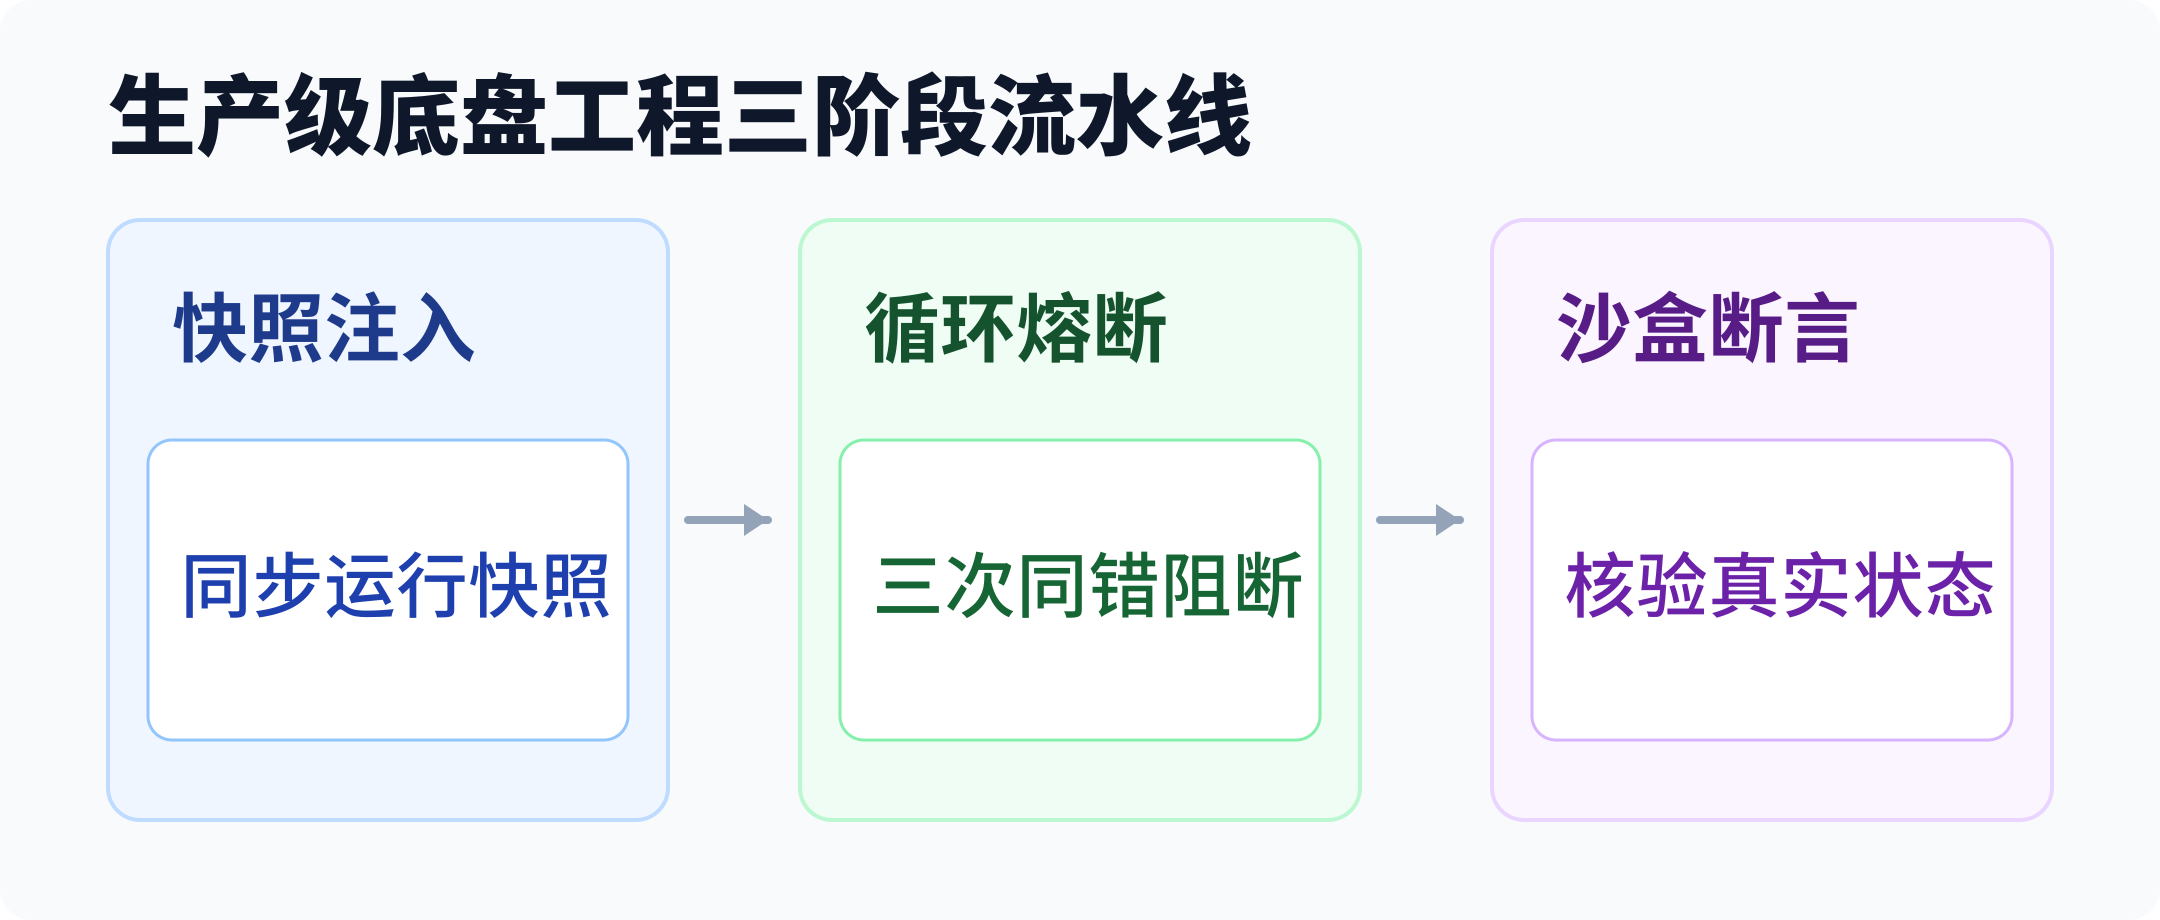
要将强大的开源模型真正转化为工业级生产力,开发团队必须在外围建立起三层严密的底盘工程体系。
第一道底盘防线是遥测感知的轻量注入。底盘在发起关键写操作前,必须向模型提供一份微小但经过验证的环境状态快照,清晰告知当前剩余的上下文预算、上一次执行的精确报错以及受保护的文件清单,彻底扫除单步推理的操作盲区。
第二道底盘防线是业务执行与状态监控的解耦切分。代码生成只负责单点逻辑推演,绝不将系统监控与调度逻辑混杂在提示词里。外围底盘作为独立的观察者,实时盯紧代码差异与调用耗时,随时准备介入阻断异常的递归扩散。
第三道底盘防线是退守至隔离沙盒的物理断言。智能体在思考链里把解决方案论证得再天花乱坠,底盘也绝不采信。所有的改动必须被推进隔离的沙盒容器,由外部测试脚本注入真实执行,只核验操作系统底层返回的真实退出状态码。模型只是单次推理的发动机,底盘才是保证整车安全跑完全程的转向机构与制动踏板。用确定性的底盘遥测与熔断取代对模型单兵能力的盲目幻想,才是开源智能体跨越玩具阶段的核心分水岭。
