很多在团队内部尝试并发跑几十个代码智能体的工程师,都曾遇到过一种极为怪异的卡顿。
智能体生成代码只用了两秒,但在最后推送分支与合并请求时,终端里却频繁报出连接超时、引用锁争抢与漫长的重试等待。整个流水线仿佛撞上了一堵无形的高墙。
这并非网络线路发生了故障,而是版本控制系统的底层物理支柱正在被剧烈的并发读写冲垮。
过去二十年里,Git 的底层存储架构完全是围绕人类的生物学特征设计的。人类程序员写代码需要思考、查文档与本地调试,往往隔几个小时甚至一整天才会向远程仓库推送一次变更。在那种负载模式下,哪怕是全球最活跃的代码仓库,每秒承受的写入请求也仅仅是数十次的短暂脉冲。
然而当成百上千个编程智能体进驻研发管线后,这种平静的物理假设被瞬间撕得粉碎。
智能体并发读写掀起服务器海啸
智能体不需要休息,更不会停下来喝咖啡。数十个智能体可以在同一时间高频并发派生分支、重构接口并推送测试代码。
这种全天候不间断的高强度轰炸,在代码仓库后端引发了恐怖的读写放大海啸。每一次看似微小的代码推送,都会瞬间触发下游持续集成流水线、拉起全新容器镜像,并引来其他并发执行的智能体疯狂拉取最新上下文。
GitHub 官方工程博客近日公开披露了一组令人心惊肉跳的监控曲线。
在其平台上最繁忙的核心仓库中,整体请求量在短短两个月内直接暴涨了整整四倍,并且呈现出陡峭的指数级上升轨迹。面对这种持续的读写洪峰,旧有的单节点存储架构迅速被逼到了崩溃边缘。
AI 时代代码生产力爆发最先击穿的并非工程师的键盘,而是那套为人类低频提交写了整整十年的底层版本控制单点。
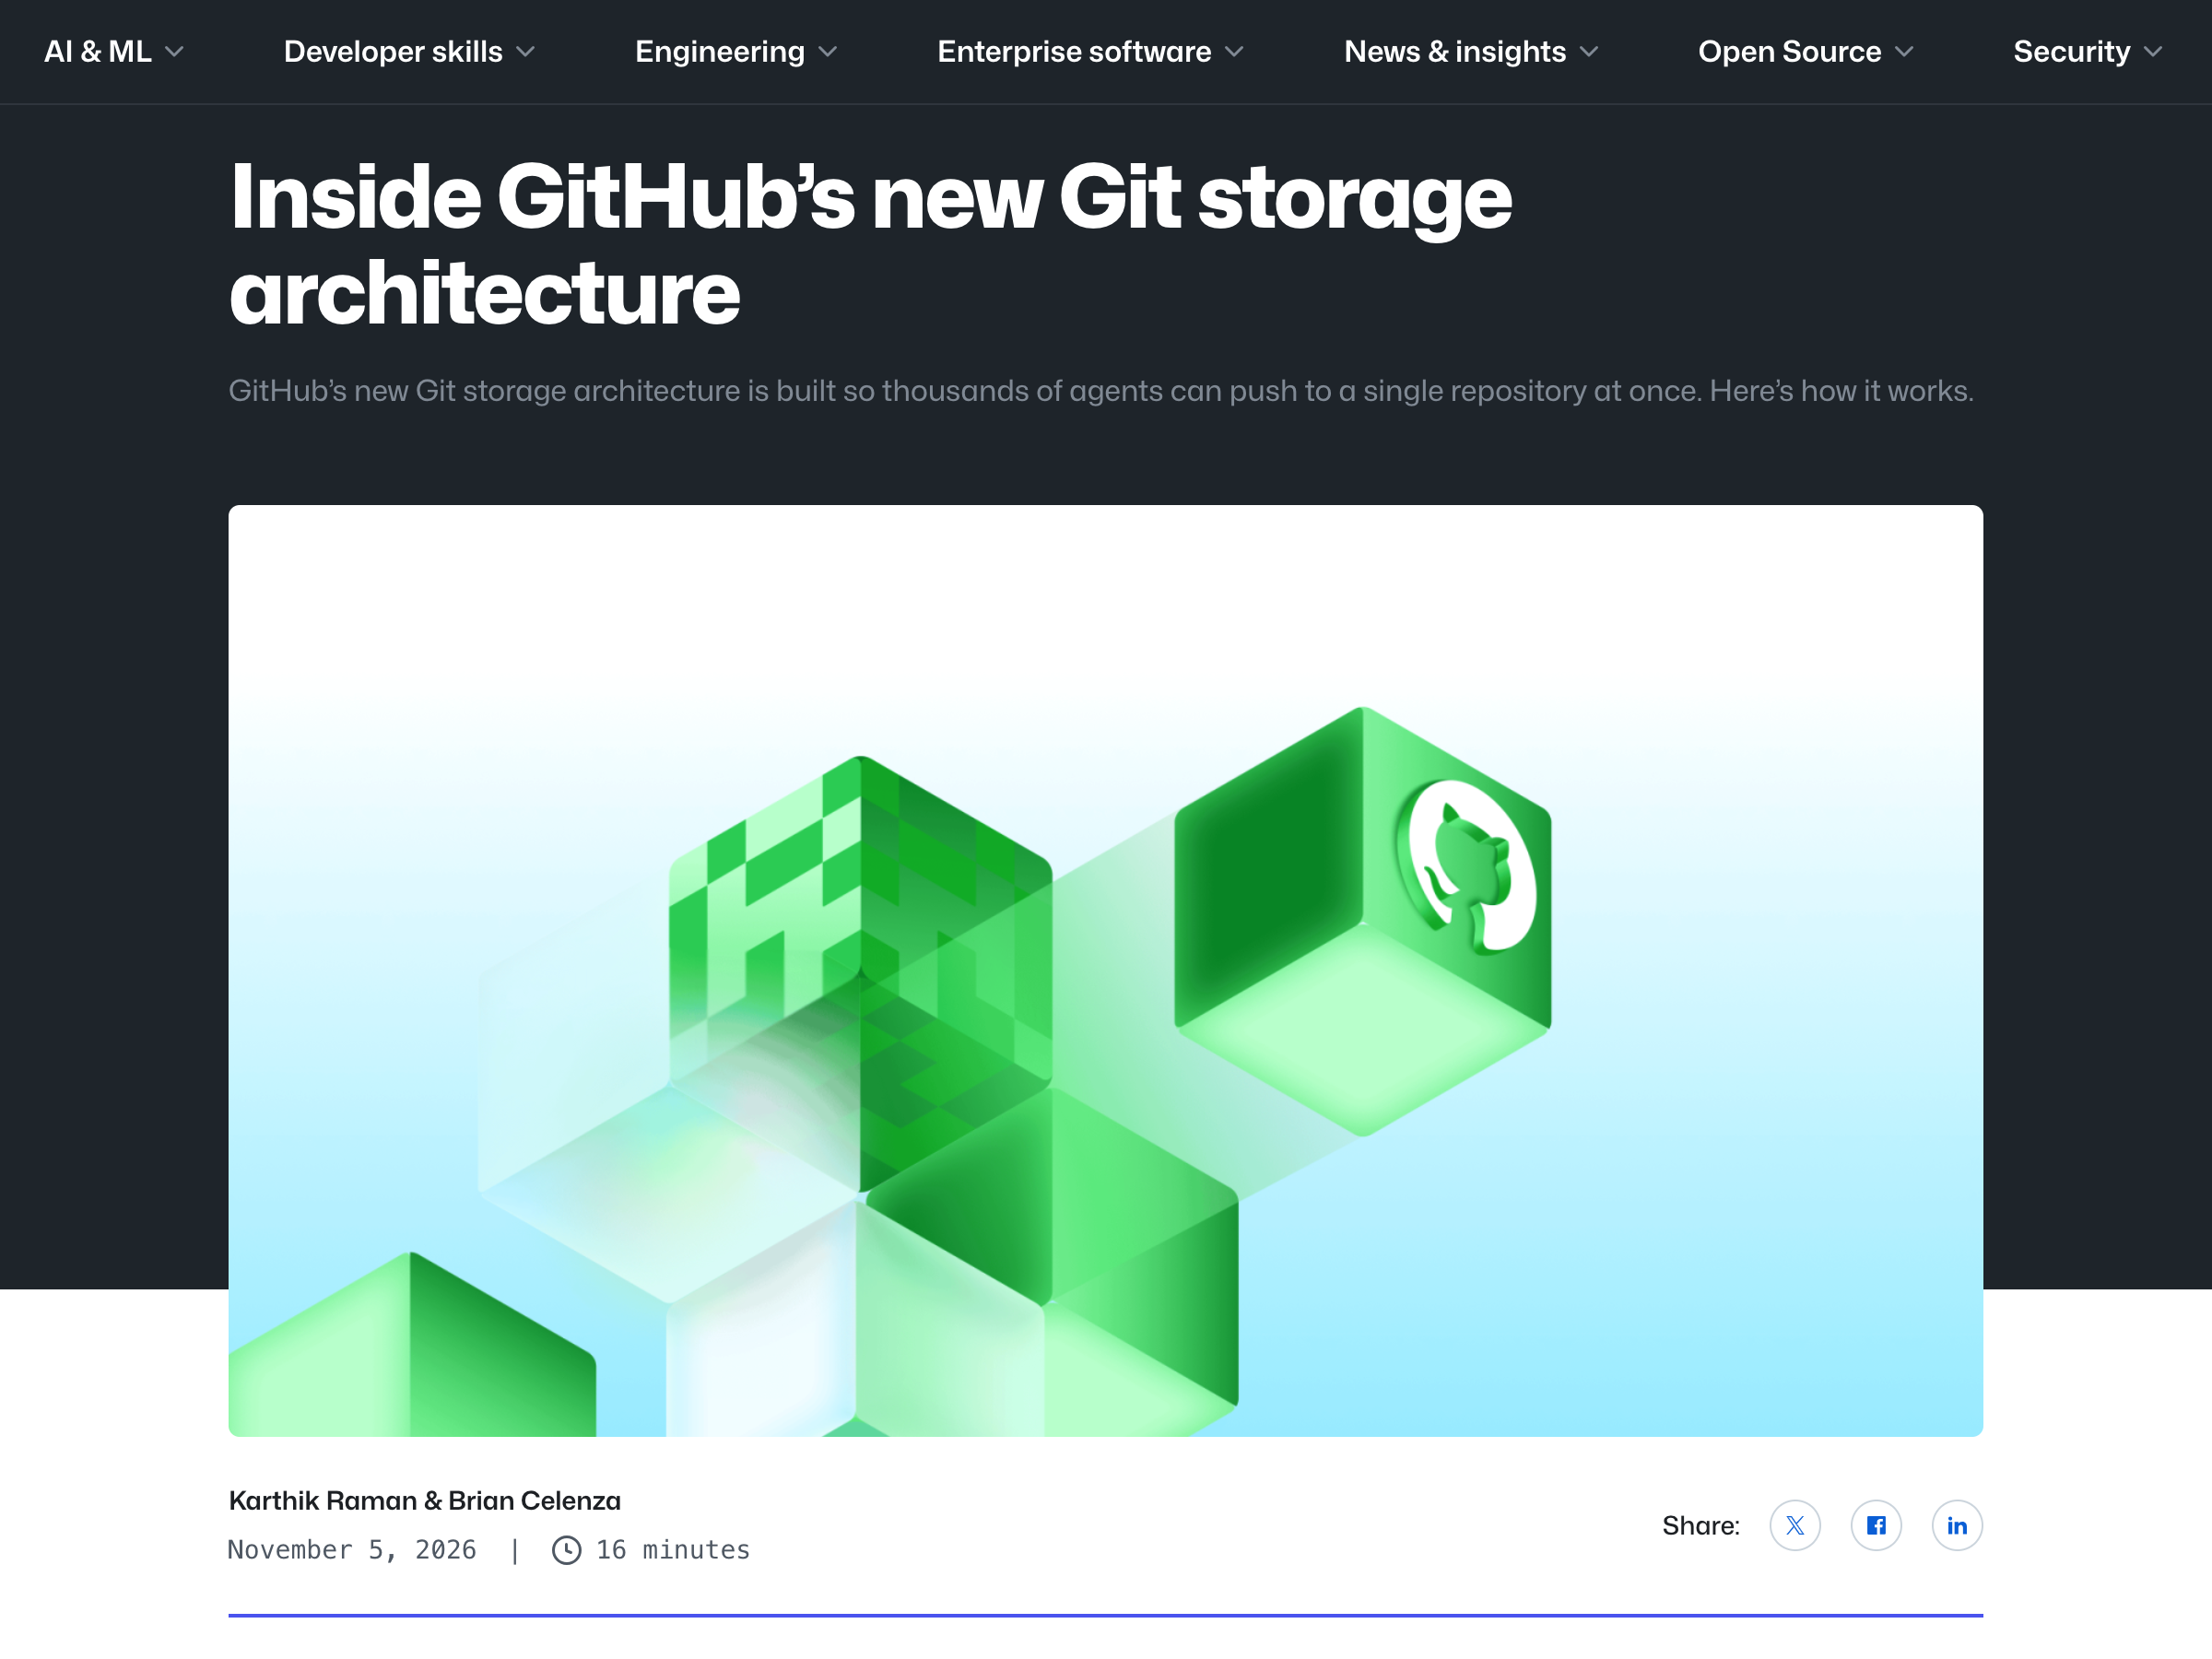
工程师在排查中发现,Git 写入最耗费资源的环节并不是简单的磁盘写入,而是极其消耗计算算力的对象解包与连通性校验。当高密度的写入请求全部塞进单个主节点时,服务器的处理器算力瞬间被吃满,整个系统迅速陷入不可逆的严重拥堵。
面对这场关乎平台生死存亡的工程考验,GitHub 悄悄启动了代号为“卢比孔计划”(Project Rubicon)的底层重构。
解耦存储与计算突破单节点瓶颈
历史上的“跨越卢比孔河”,象征着破釜沉舟、迈过不可逆转的关键分水岭。GitHub 将这一秘密工程命名为卢比孔,正是因为整个软件工业已经彻底踏入了智能体开发的全新纪元。
为了承载至少两个数量级的流量飞跃,工程团队彻底掀翻了坚守十年的软硬件紧耦合架构。
在卢比孔架构中,最核心的一刀切在了计算与存储的边界上。系统不再把庞大的历史数据和版本包固守在单一物理节点上,而是将所有核心块存储彻底下沉至海量的云端对象存储池。
计算节点得以完全从繁重的本地磁盘持久化中解放出来,演变为无状态的敏捷处理集群。
在这一改造过程中,团队在保障全球数千万开发者正常编码、全站服务不中断的极端苛刻条件下,平滑完成了多达百分之九十九点九九九九九的代码仓库数据大迁移。
任何一个计算节点发生故障或算力告急,集群都可以在瞬间拉起全新的无状态算力单元接管流量,从根本上终结了单点算力熔断的宿命。
引用独立仲裁支撑每秒数千写入
解决了存储与计算的物理剥离,接踵而至的另一只拦路虎是元数据层面的集中锁竞争。
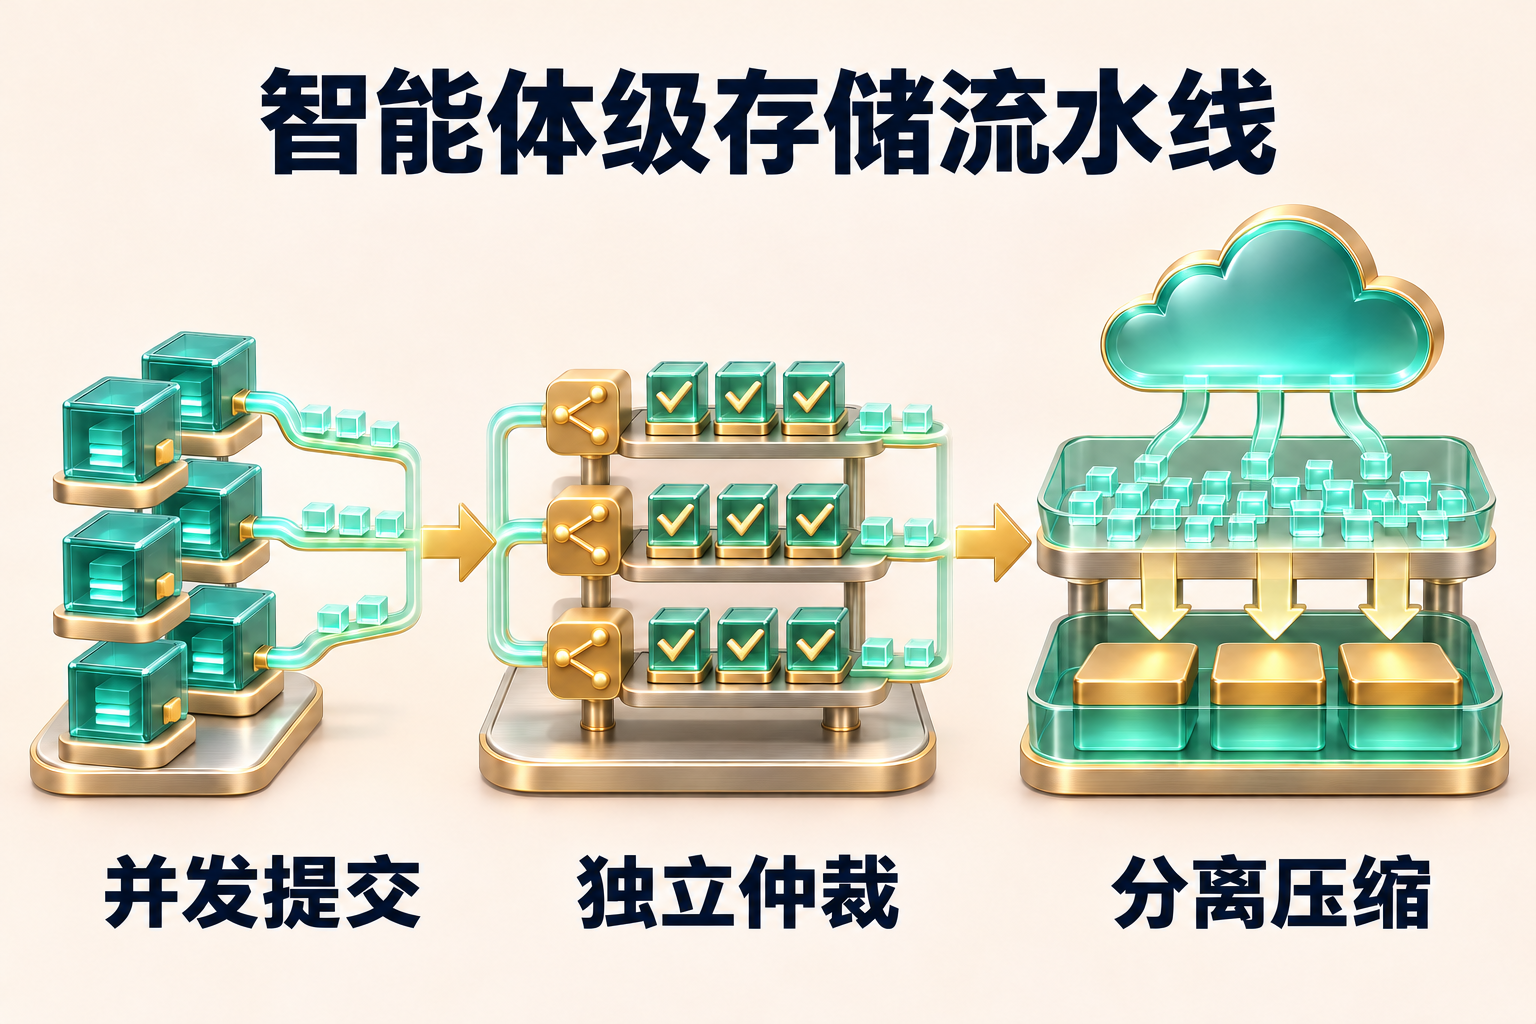
在原生的 Git 设计理念中,同一个代码仓库内部的引用更新往往共享全局状态。当数十个智能体试图向同一个仓库的不同分支并发推送代码时,它们不可避免地会在中央调度器前排起长龙,任何一笔慢写入都会直接卡死后序的所有变更。
卢比孔架构通过引入按引用独立法定人数仲裁(Per-reference quorums),从逻辑根源上斩断了全局锁链。
每一条独立的分支引用都拥有专属的仲裁通道。智能体在不同特性分支上的高频写入完全并行推进,彼此之间不再产生任何锁竞争与线程阻塞;配合毫秒级的流式高频压缩流水线,单仓库每秒写入处理能力直接飙升到了数千次级别。
从单点泥潭到云原生分布式解耦,卢比孔计划不仅是 GitHub 自身的底层换血,更为整个行业指明了智能体基础设施的演进终局。
当智能体开始成群结队地重塑软件工程,唯有彻底重构脚下的底层地基,我们才能真正接住这场呼啸而来的算力风暴。
