很多在企业一线负责智能体系统落地的架构师,都在成本与性能的天平两端饱受煎熬。
为了保证业务输出的绝对精准,团队最初往往习惯全链路挂载最昂贵的顶流大模型。然而一旦系统接入生产环境直面海量并发,月底送来的账单数字便足以让财务负责人当场报警。更棘手的是大模型的响应延迟,动辄数百毫秒乃至数秒的网络往返,极易将下游的高频交互通道彻底堵死。
为了压降成本,有人尝试将全量链路一刀切换成廉价的小模型。
然而残酷的现实随之而来:在面对复杂的长尾业务和细微边界判定时,小模型的准确率瞬间出现断崖式下跌,业务线上随即被大量低级判断失误淹没。
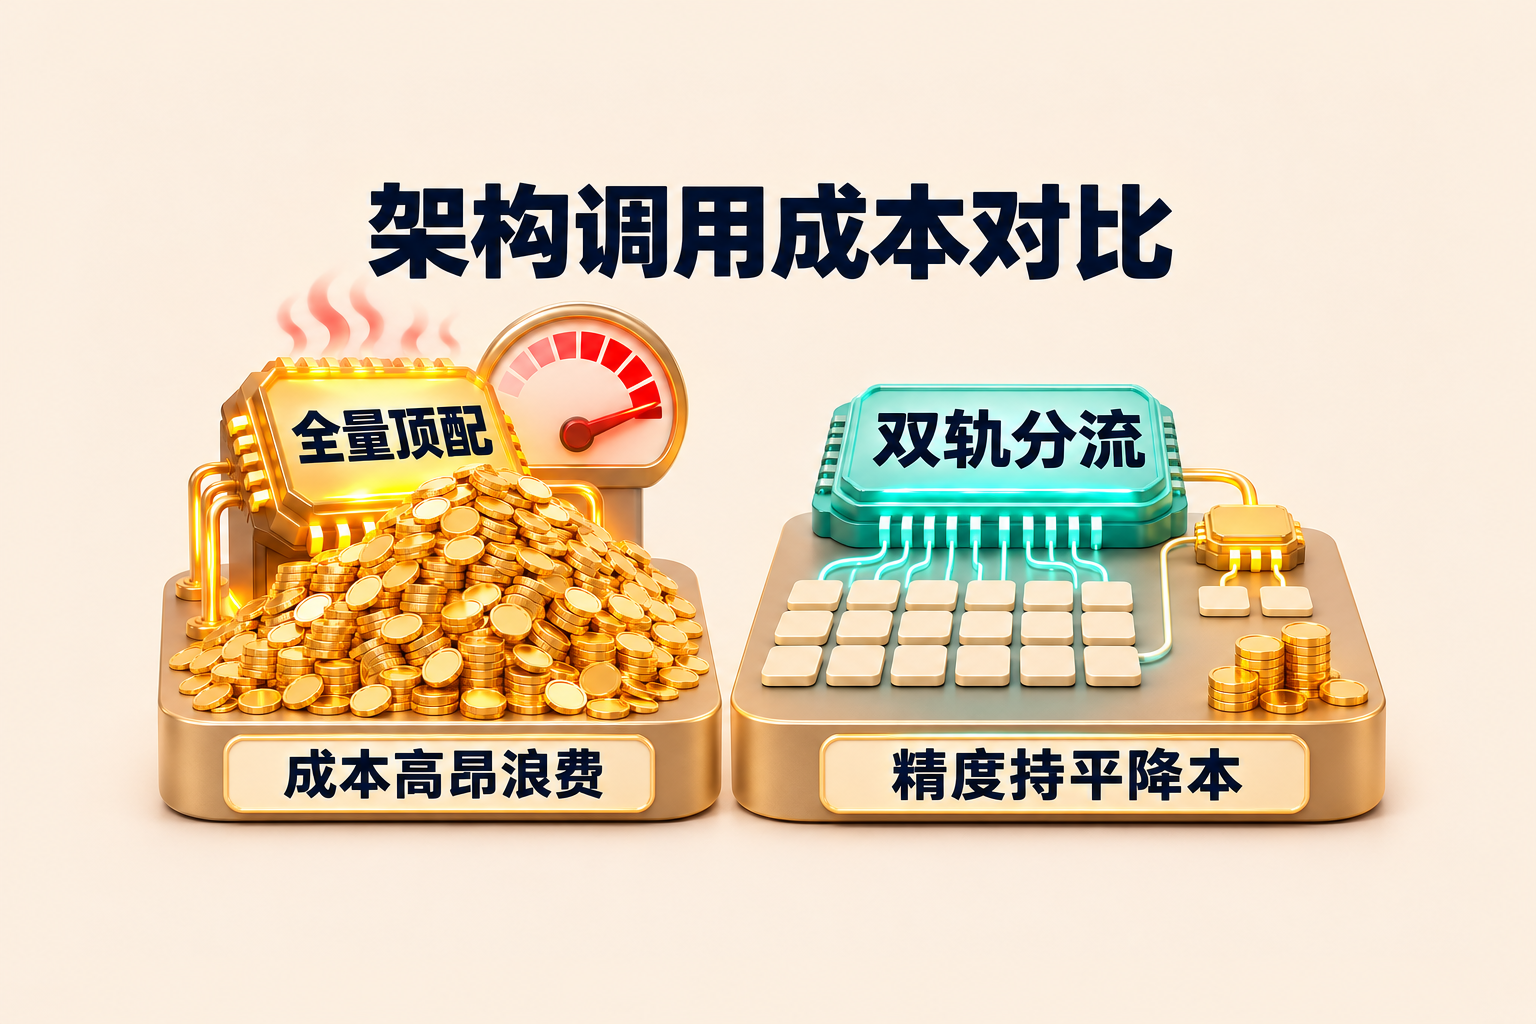
全量调用顶配模型让企业账单爆表
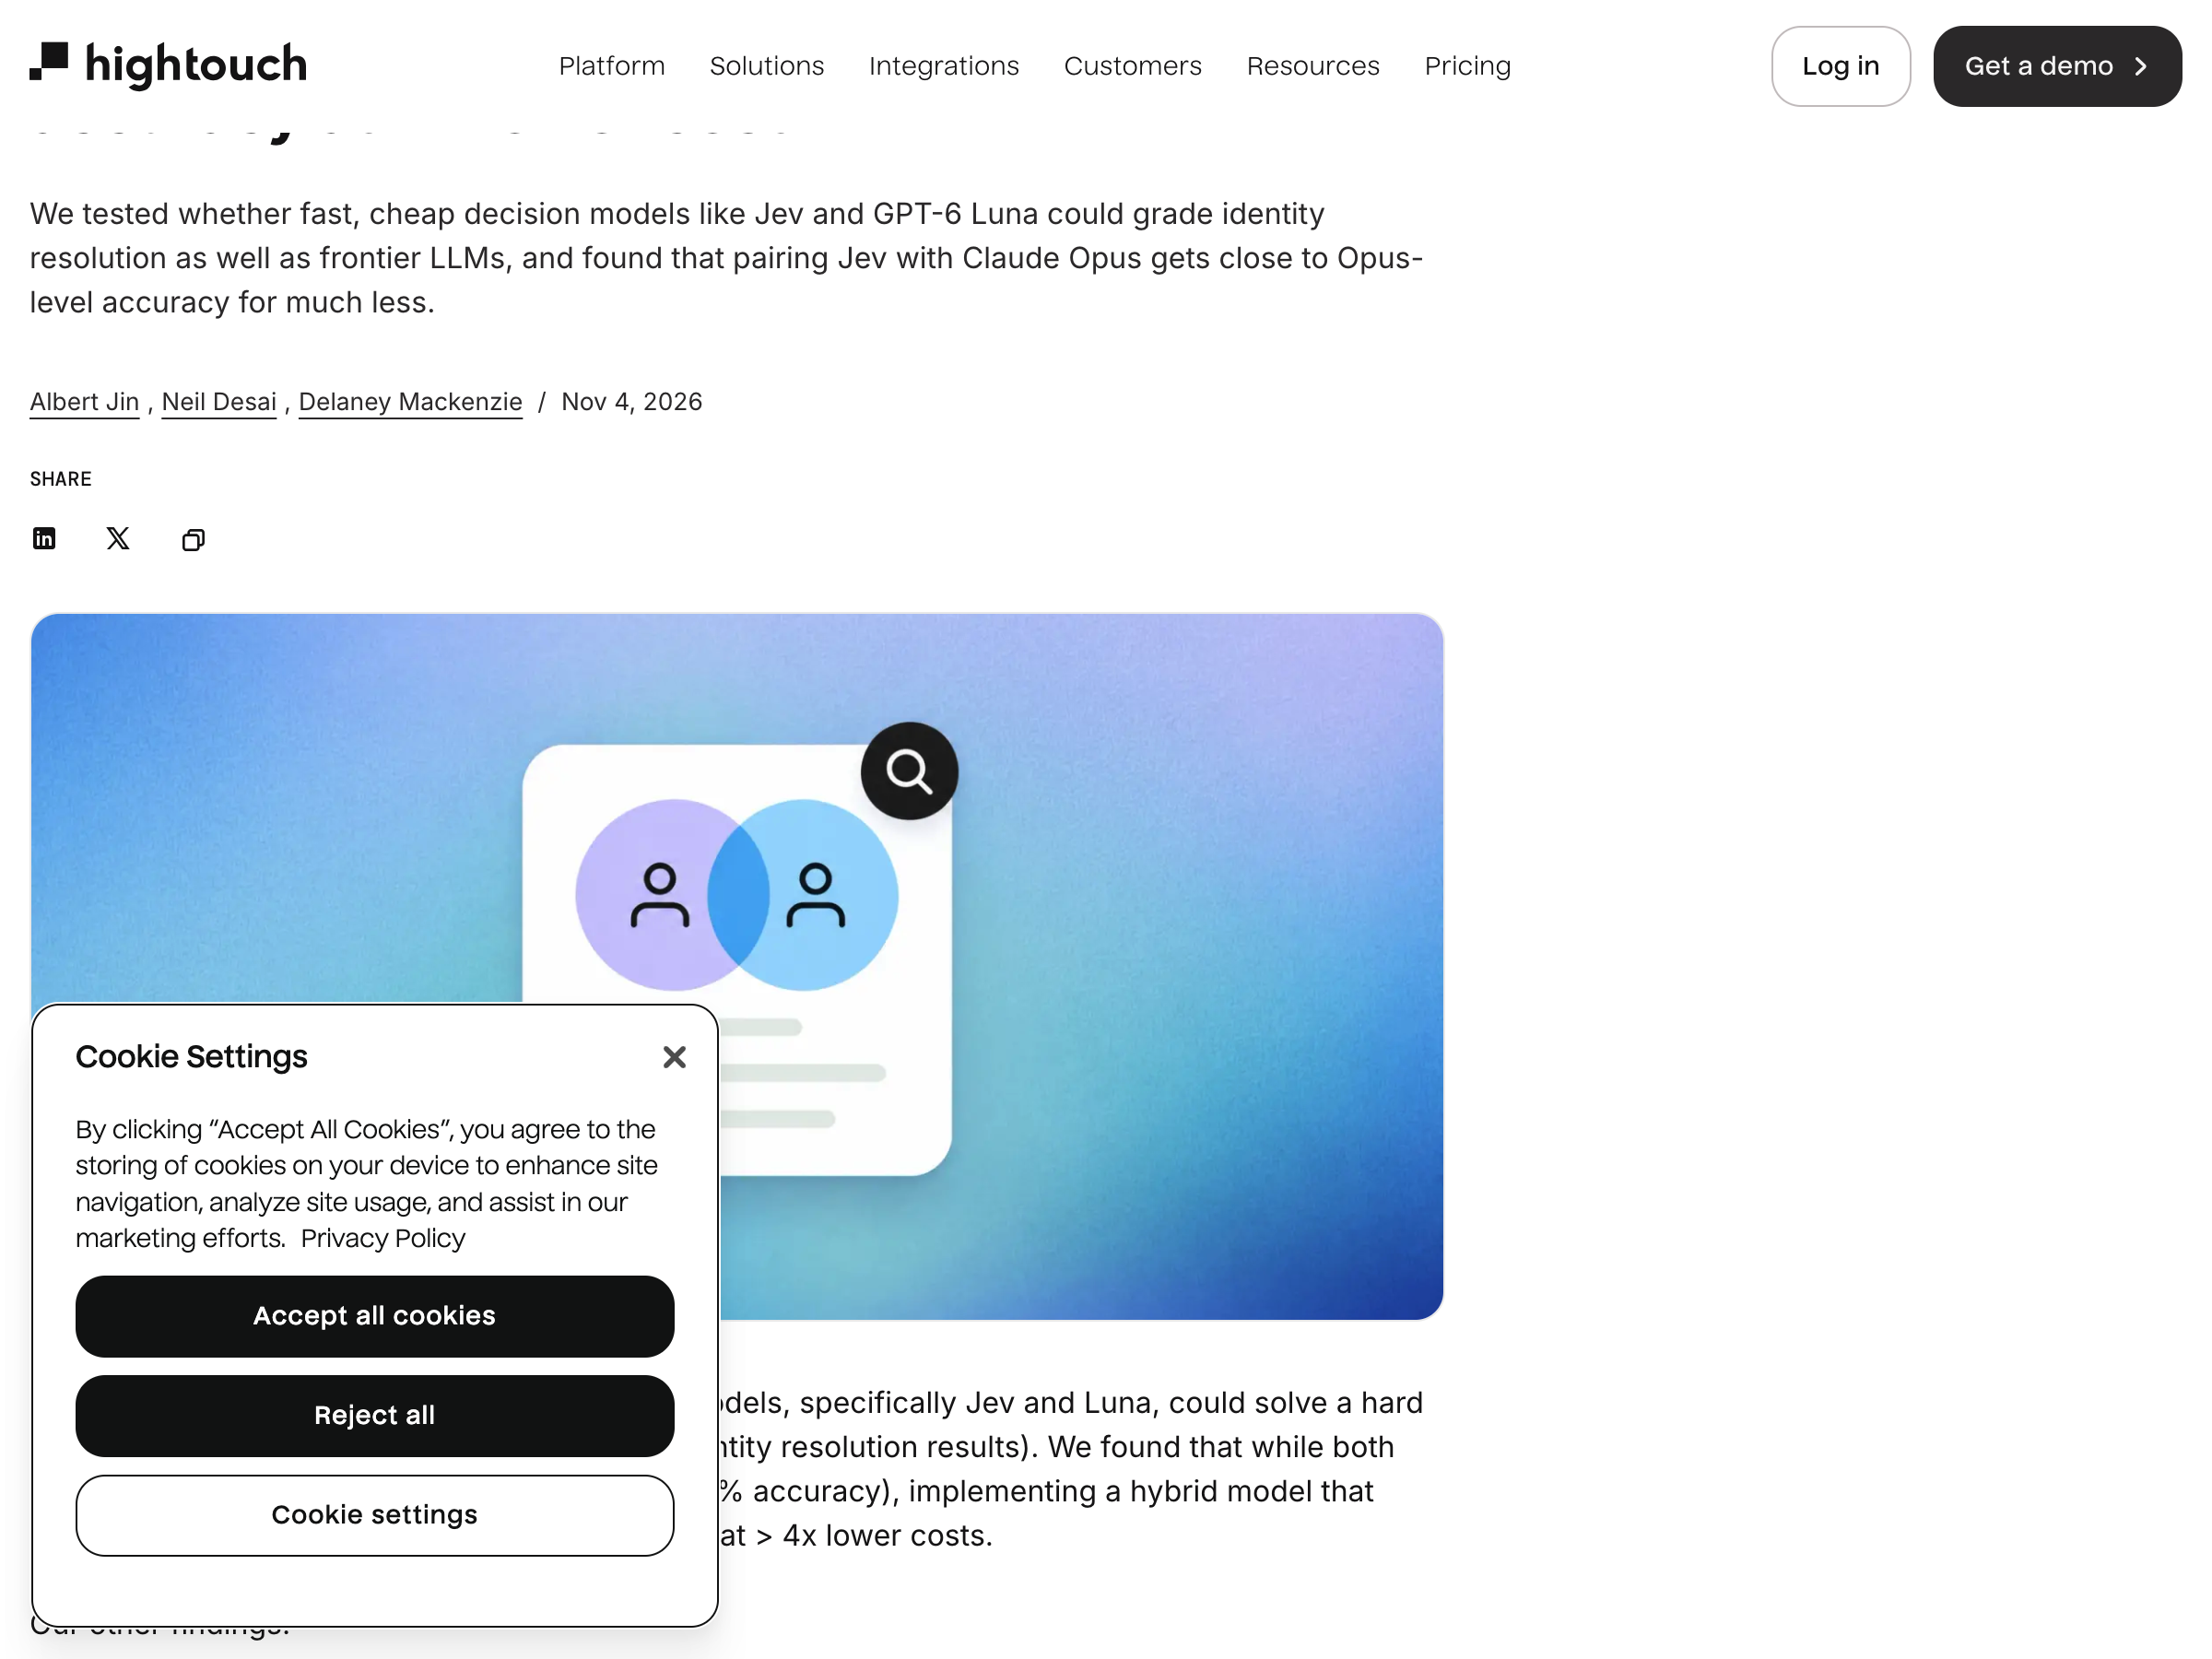
面对这道兼顾顶级精度与规模化成本的难题,知名数据智能独角兽 Hightouch 在其生产复盘中给出了突破性答案。
在企业级客户身份解析与大模型自动化裁决的超高频业务中,Hightouch 每天需要比对数以亿计的异构数据记录。如果全量采用 Claude Opus 级别的顶流前沿模型,单次判决的高昂成本将让大规模落地不堪重负;而开箱即用的轻量模型虽然极速且便宜,但在复杂边界问题上的准确率却整整落后了六个百分点。
工业级降本绝不是粗暴地将模型降级,而是让懂得自我怀疑的小模型挡掉八成常规流量,仅将真正的争议难题留给顶级大模型。
工程师在排查中发现,轻量决策模型单次响应仅需约零点一五秒,调用速度比顶流大模型快出十倍以上,每千次判决的成本更是低至几美分,便宜了整整九十倍。
问题在于,如何才能在不牺牲系统准确率的前提下,榨干小模型的极致性价比。
置信度动态分流把难题精准送达
Hightouch 团队通过严密的控制变量实验,揭开了一个至关重要的底层分水岭:置信度校准。
许多开发者在评测小模型时只盯着基准答题准确率,却忽视了模型对自身答案的确信程度。在实验对比中,虽然不同小模型的裸分看似接近,但底层行为模式截然相反:有的模型在犯下低级错误时依然给出盲目的极高置信度;而经过优秀校准的轻量模型,绝大部分失误都伴随着清晰的极低置信度评分。
这就是构建动态分流系统的核心钥匙。
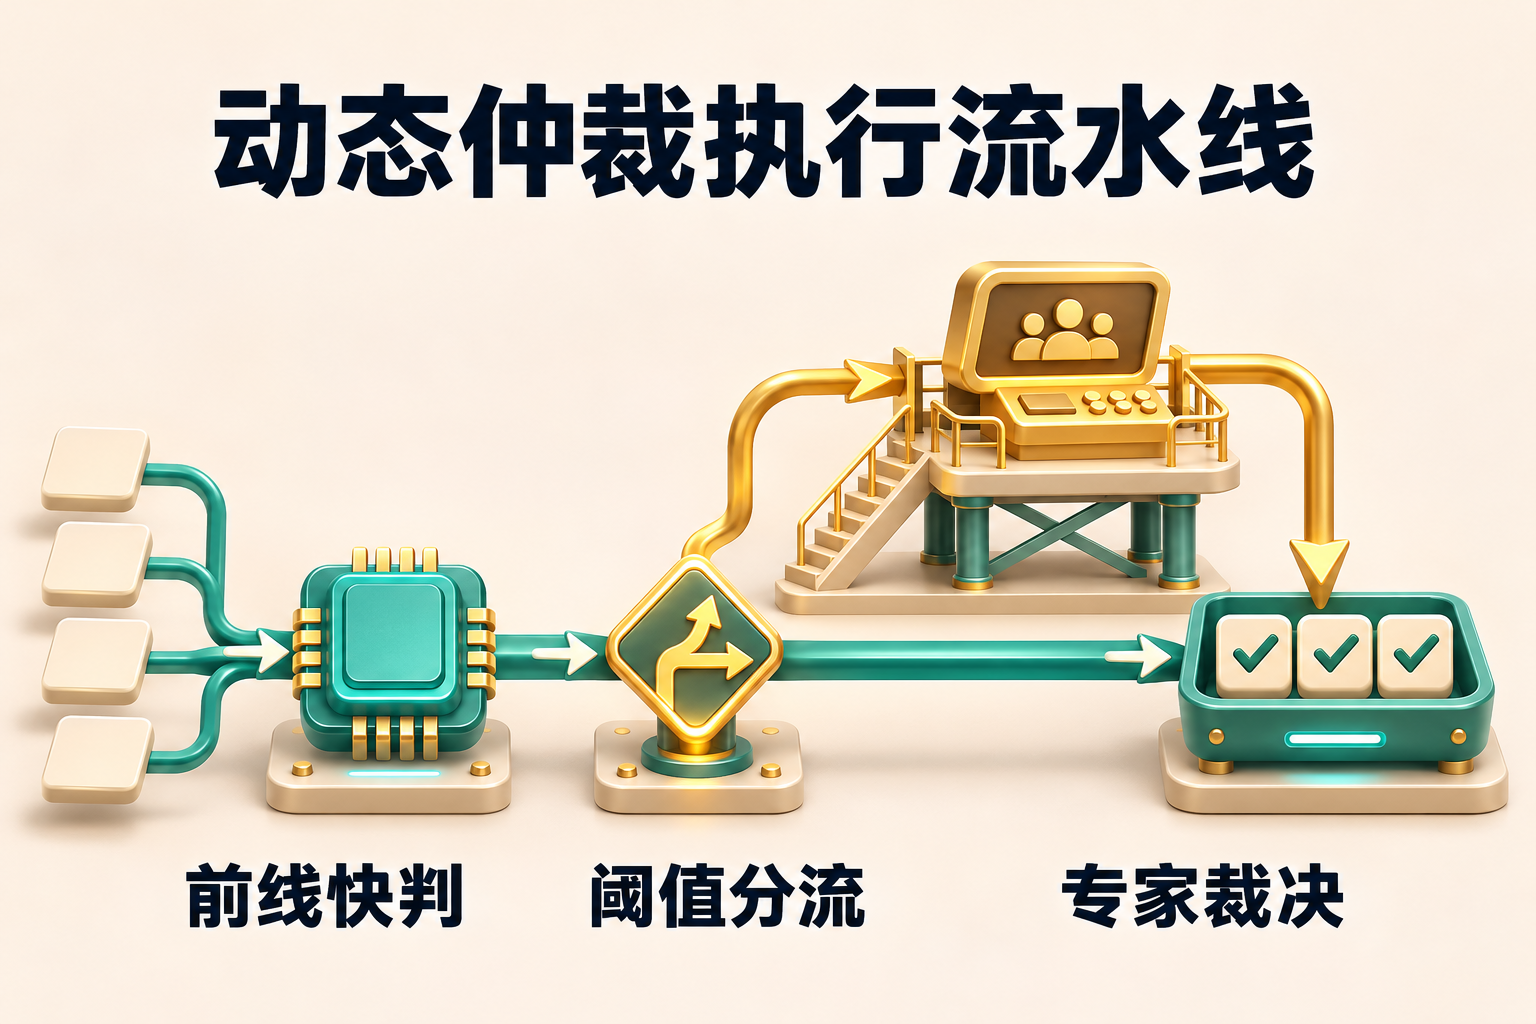
一个清楚知晓自己何时不确定的前线小模型,就是最理想的守门人。系统在收到任务请求后,首先交由轻量模型进行纳秒级的首轮研判。对于逻辑简单、特征分明的大多数常规样本,前线模型输出高达百分之九十五以上的置信评分,系统立刻触发短路机制直接放行。
只有当小模型遭遇模棱两可的模糊边界、置信度跌破设定的安全红线时,争议工单才会被打包送入深度裁决池。
双轨仲裁机制在生产环境狂省四倍
顺着这一设计思路,Hightouch 在生产环境中正式部署了双轨混合仲裁架构。
在这套体系中,轻量模型充当不知疲倦的前线哨兵,以极低的资源消耗阻断了超过百分之八十的常规流量。而真正昂贵稀缺的 Claude Opus 模型则退居二线,化身为专职处理疑难杂症的仲裁法官,仅在系统面临分歧与低确信时介入最终断言。
最终的生产实测数据让整个工程团队倍感振奋。
全链路的最终判决准确率,与全部请求无脑打给顶配 Opus 的基准线完全打平,达到了严苛的工业级上线标准;而由于昂贵模型的实际调用频次被断崖式压缩,整个系统的总 API 账单直接暴跌了四倍以上,相当于为企业凭空节省了超过四分之三的算力成本。
不再把顶配大模型当作毫无技术含量的粗工使唤,依托置信度建立精准的分流防线,工业级智能体才能在真实的业务战场上既算得准、又活得久。
