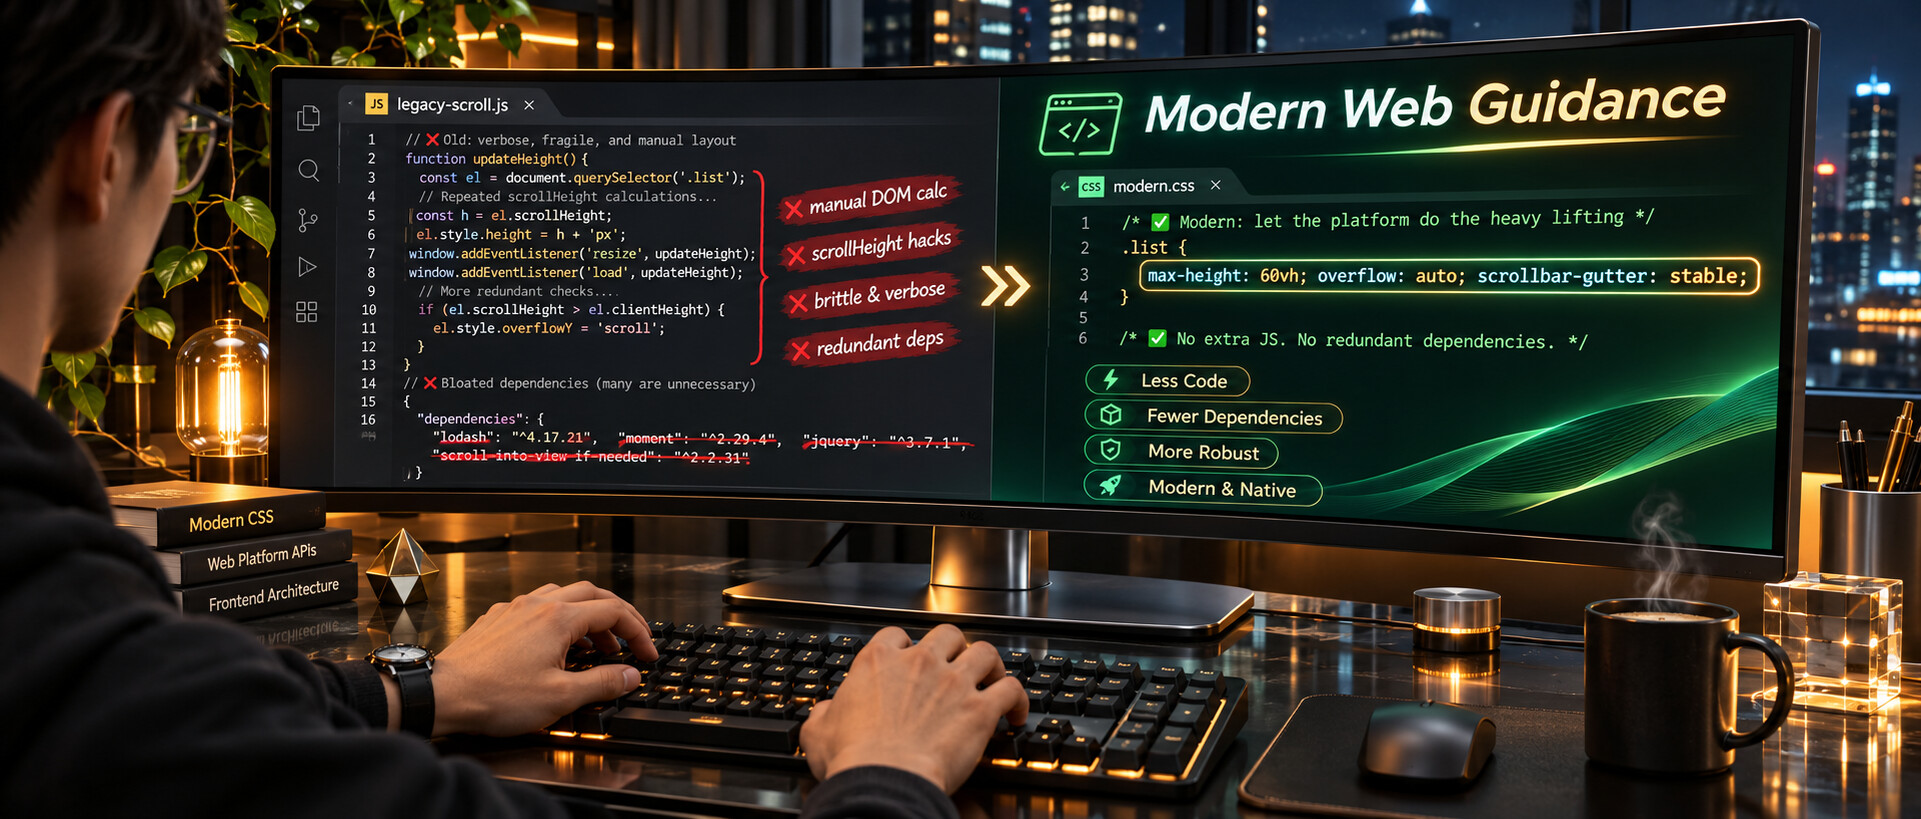
在工位上满怀期待地让编程智能体写一个文本框自适应高度的功能。
打开提交上来的代码审查页面,眼前的一幕让人啼笑皆非。编辑器里密密麻麻塞了六十多行 JavaScript,又是监听输入事件,又是挂载尺寸观察器,顺便还在配置清单里塞进了一个好几年没有维护的第三方依赖包。
而在今天的现代浏览器里,实现同样的功能只需要在样式表里写上一行原语。
一条简单的内容自适应属性,就能直接把过去十几年间前端工程师为了计算滚动高度而折腾的复杂脚本全部扫进历史垃圾堆。然而在技术日新月异的今天,最顶尖的大模型写出来的前端界面,却常常散发着浓郁的陈旧气息。
大模型明明每个月都在刷新评测跑分,为什么产出的代码却总像停留在五年前?
存量训练语料让大模型退化回五年前
编程智能体之所以热衷于制造代码屎山,并不是它的推理能力不够聪明。
大模型本质上是一台依据概率分布预测下一个字符的机器。在它的训练语料库深处,沉睡着过去十五年间全球开发者堆砌的浩瀚存量代码。在海量的历史代码里,手写脚本去监听 DOM 树变化的频次,比现代原生标准高出成百上千倍。
这种语料分布上的严重偏差,让智能体在生成前端逻辑时产生了顽固的路径依赖。
当开发者要求实现一个模态弹窗,大模型会习惯性地引入几十千字节的第三方组件库,外加五十行代码来手写焦点锁定和页面滚动拦截。实际上,现代浏览器早就原生内置了对话框标签与模态唤起方法,原生顶层视图管理可以让代码行数缩减八成以上。
大模型之所以总在写五年前的陈旧代码,是因为它的底层被过去海量的历史废弃语料淹没了;把现代原生原语写进契约,一行 CSS 就能扔掉几十行胶水脚本和第三方包。
当开发者要求实现页面文字搜索高亮,模型依然在用正则表达式暴力拆碎节点,在文本里到处乱插高亮标签引发严重的界面重排。而现代标准早已支持了原生的高亮接口,既不破坏文档树结构,性能也远超传统实现。
如果任由智能体自由发挥,原本轻巧的现代化项目很快就会被陈旧的胶水代码彻底压垮。
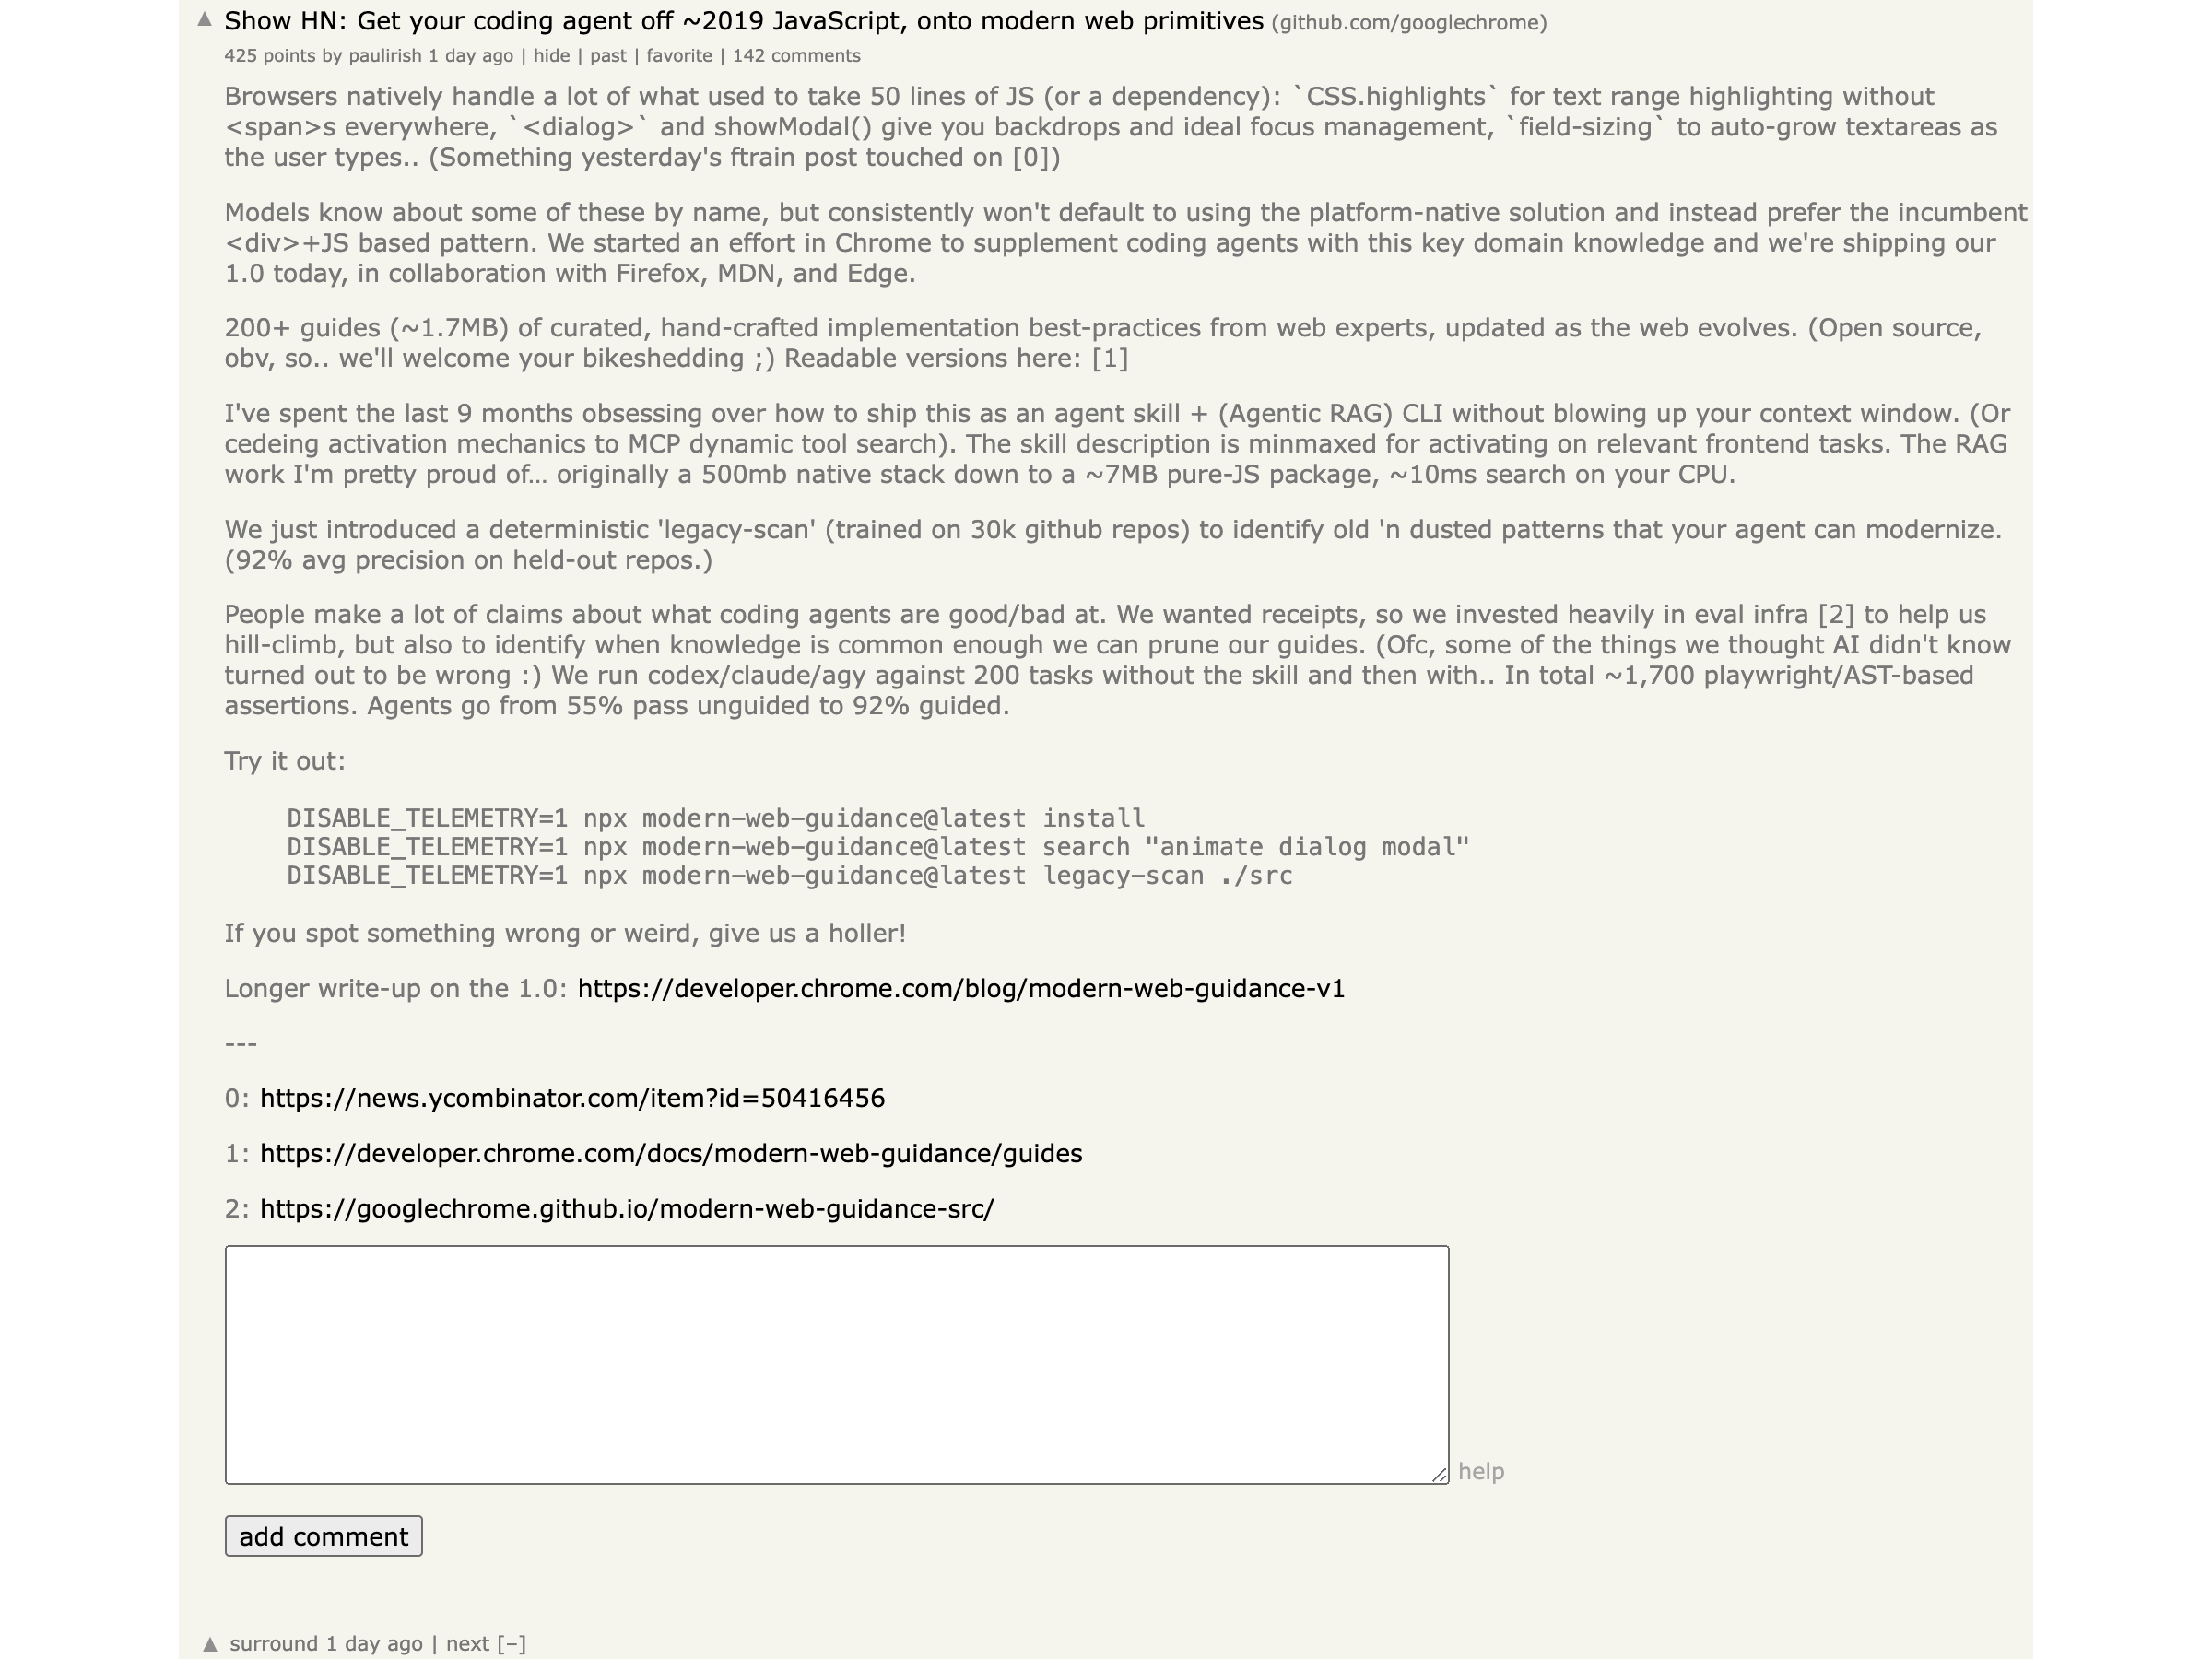
现代原生原语把前端产物体积砍掉七成
为了终结这种由于模型语料偏见引发的技术倒退,技术社区的巨头们终于坐不住了。
开源技术社区里,来自谷歌 Chrome 团队的资深工程师联合微软与火狐团队,共同发布了一项名为 Modern Web Guidance 的开源规范。他们把过去数年间浏览器已经全面落地的现代标准,系统性地整理成紧凑的机器规则,专门用来救赎被带偏的编程模型。
这套规范把现代 Web 平台原生能力划分成清晰的工程原语。
从不需要额外定位脚本的弹出层属性,到纯样式实现的平滑视图转场,再到基于现代色彩空间的调色规范,全部用最轻量的原生标准武装智能体的上下文。只要把这些现代契约显式注入到智能体的执行环境里,模型立刻就会抛弃五年前的陈旧模式。
研发团队在日常工程中引入这套现代基准,只需要极其简单的两步操作。
第一步是在项目根目录下执行扫描命令,快速盘点代码库中被大模型偷偷塞进的历史陈旧写法与多余依赖。第二步则是将官方提炼的现代 Web 指南直接写入项目的代理规范文件,明确要求智能体优先调用浏览器原生原语。
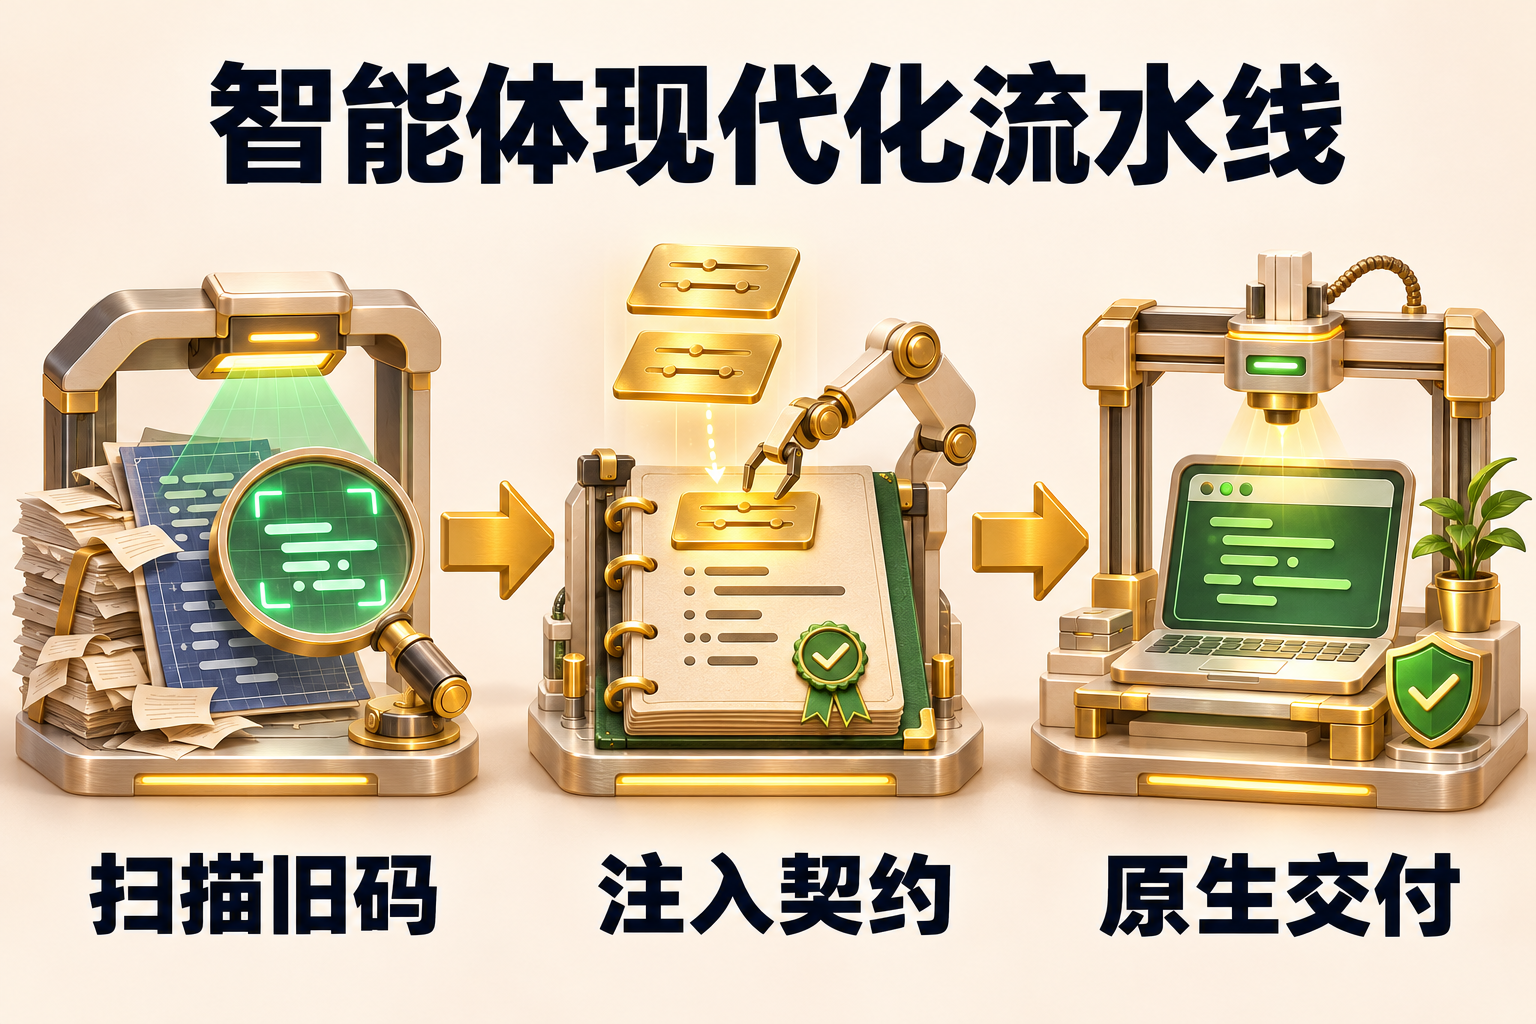
从被动审查冗长低效的胶水代码,到用现代平台契约精准约束模型输出。
告别五年前的冗余包与无效脚本,用最精炼的原生标准写代码,才是人机协同开发真正该有的优雅姿态。
